Darwin Gödel Machine:让编码 agent 编辑自己的代码库,越改越强
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。
先看一个现象:给编码 agent 加一个「更好用的工具」,效果好不好,几乎没法预先判断——同一个测试工具,在这个模型上顺手,换到那个模型上可能反而添乱。Gödel machine 的原始设想是要求形式化证明「这次自我修改一定有益」,实践中做不到。UBC、Vector、Sakana 这篇 ICLR 2026 论文(DGM)的解法很直白:不证明了,直接在 benchmark 上试——agent 改自己的代码,改完跑分,分数说话。
背景:自改进的两种死法
Hill-climbing 式自改进(每轮只从当前最优分叉)会困在局部最优:一次失败的自我修改,可能让后面所有改进都更难。固定 meta-agent 的框架(ADAS 等)则把元层锁死:base 系统只能在一个手工设计的边界内改进。DGM 的应对是开放探索树:从单个初始 agent 出发,每个变体都归档,parent 选择给每个 agent 保留非零概率——低分节点也可能是未来高分的跳板。
核心机制:自修改是编码任务,评估也是编码任务
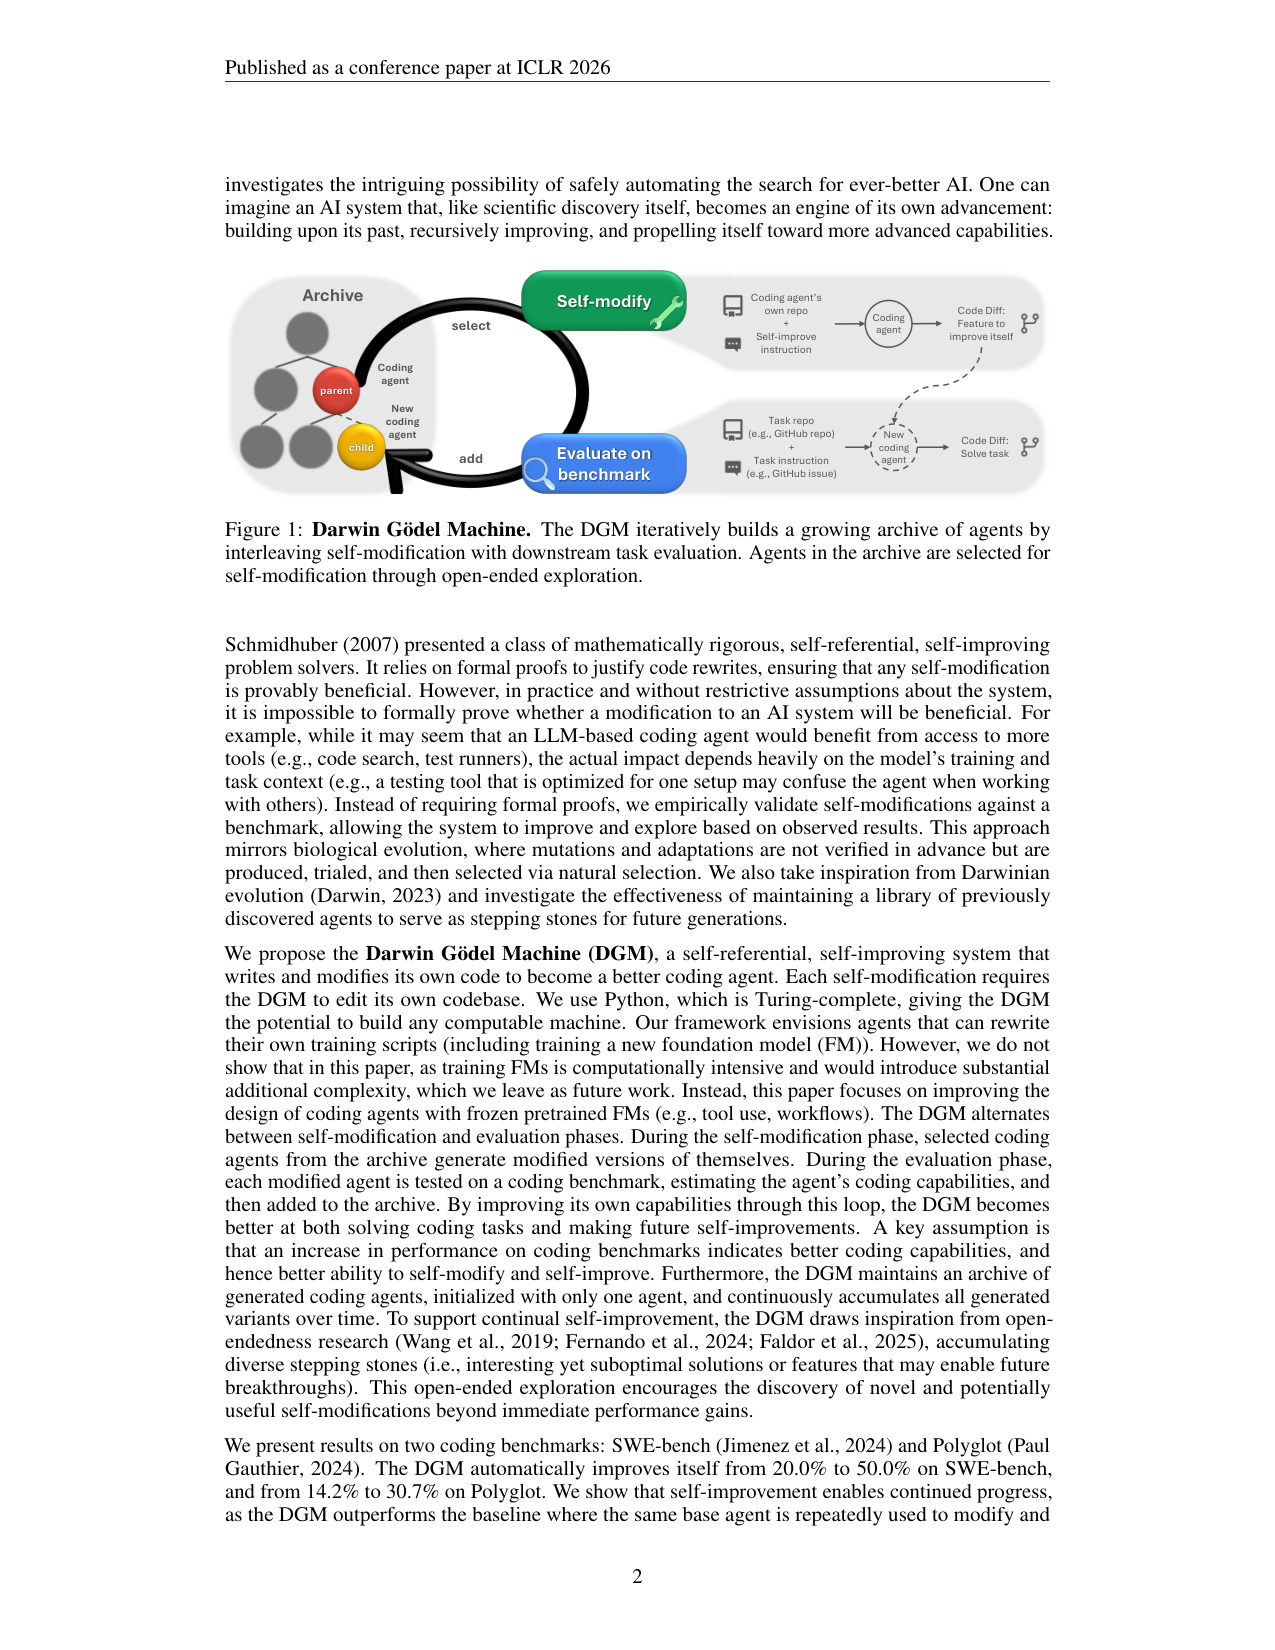
DGM 里只有一个系统:一个由冻结的 FM(Claude 3.5 Sonnet)驱动的 coding agent,带两个工具——bash 和执行文件查看/编辑的 edit 工具。每轮迭代:从档案里按概率选一个 parent——概率大致正比于它的性能分、反比于它有代码编辑能力的孩子数(子代少的强者优先)——然后让这个 parent 读自己的 benchmark 评估日志,提出下一个 feature,把「实现这个 feature」当成任务指令,用两个工具改自己的代码库,生成新 agent。
评估是分级漏斗:先 10 个任务验基础编辑能力(没有代码编辑能力的孩子直接淘汰),再 60 个任务估分,SWE-bench 上过了 40% 且档案 top-2 的才上 200 任务。80 次迭代里,SWE-bench 跑 2 路并行、Polyglot 跑 4 路并行。
这条设计的妙处是对齐:下游任务要求改代码,自我改进也要求改代码——编码能力提升,直接等于自改进能力提升。用论文的话说,这消除了「下游收益」和「自改进收益」之间的错位。
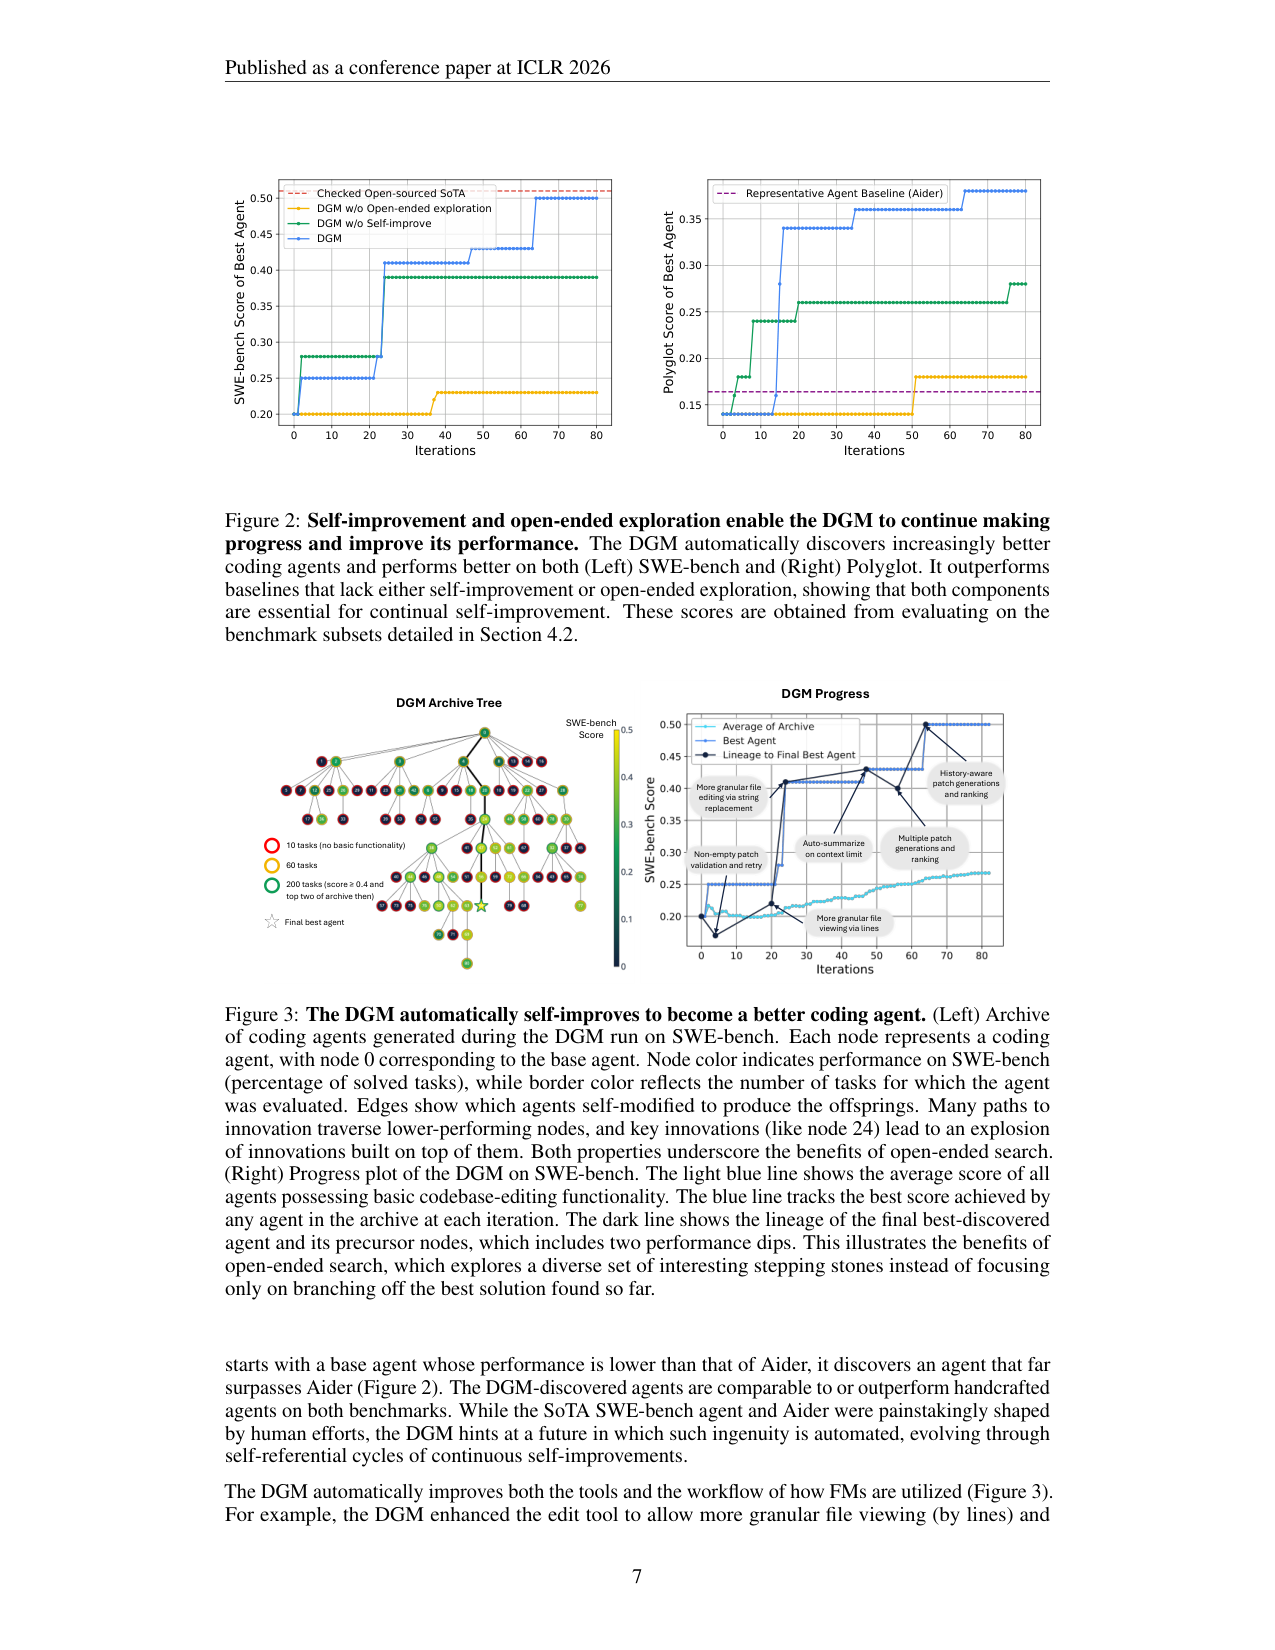
再补一个机制细节:为什么「非零选择概率」这么重要。DGM Greedy 消融(总选最优分叉)把 SWE-bench 从 50.0% 拖到 39.7%,说明档案里那些「当前分数不高但结构上有潜力」的路径,是后期突破的来源。图 3 的血统线显示,最终最优 agent 的祖先里有两次明显的性能下探——如果按 hill-climbing 的规则,这两条路径早就被剪掉了。开放探索的本质是:允许短期退步,换取长期走出局部。
另外,「有代码编辑能力的孩子数」这个分母是刻意选的:孩子多说明这条血统已经被充分开采,减权;孩子少但性能高,说明它还没被开采,加权。这让搜索在「强者」和「未被开采者」之间摆动,是质量-多样性思想在 agent 空间的落地。
关键结果:SWE-bench 20.0% → 50.0%
数字全部带 baseline 和 setup。SWE-bench Verified(分级子集评估):80 次迭代从 20.0% 涨到 50.0%;同 200 任务子集上,开源 SOTA OpenHands+CodeAct v2.1 是 51.0%——自动进化逼近了手工打造的开源方案。对照组(附录 A.3 表 1):去掉自改进 39.0%、去掉开放探索 23.0%、贪心只从最优分叉(DGM Greedy)39.7%。Polyglot:50 任务子集 14.0% → 38.0%,全量 benchmark 14.2% → 30.7%,超过 Aider 基线。
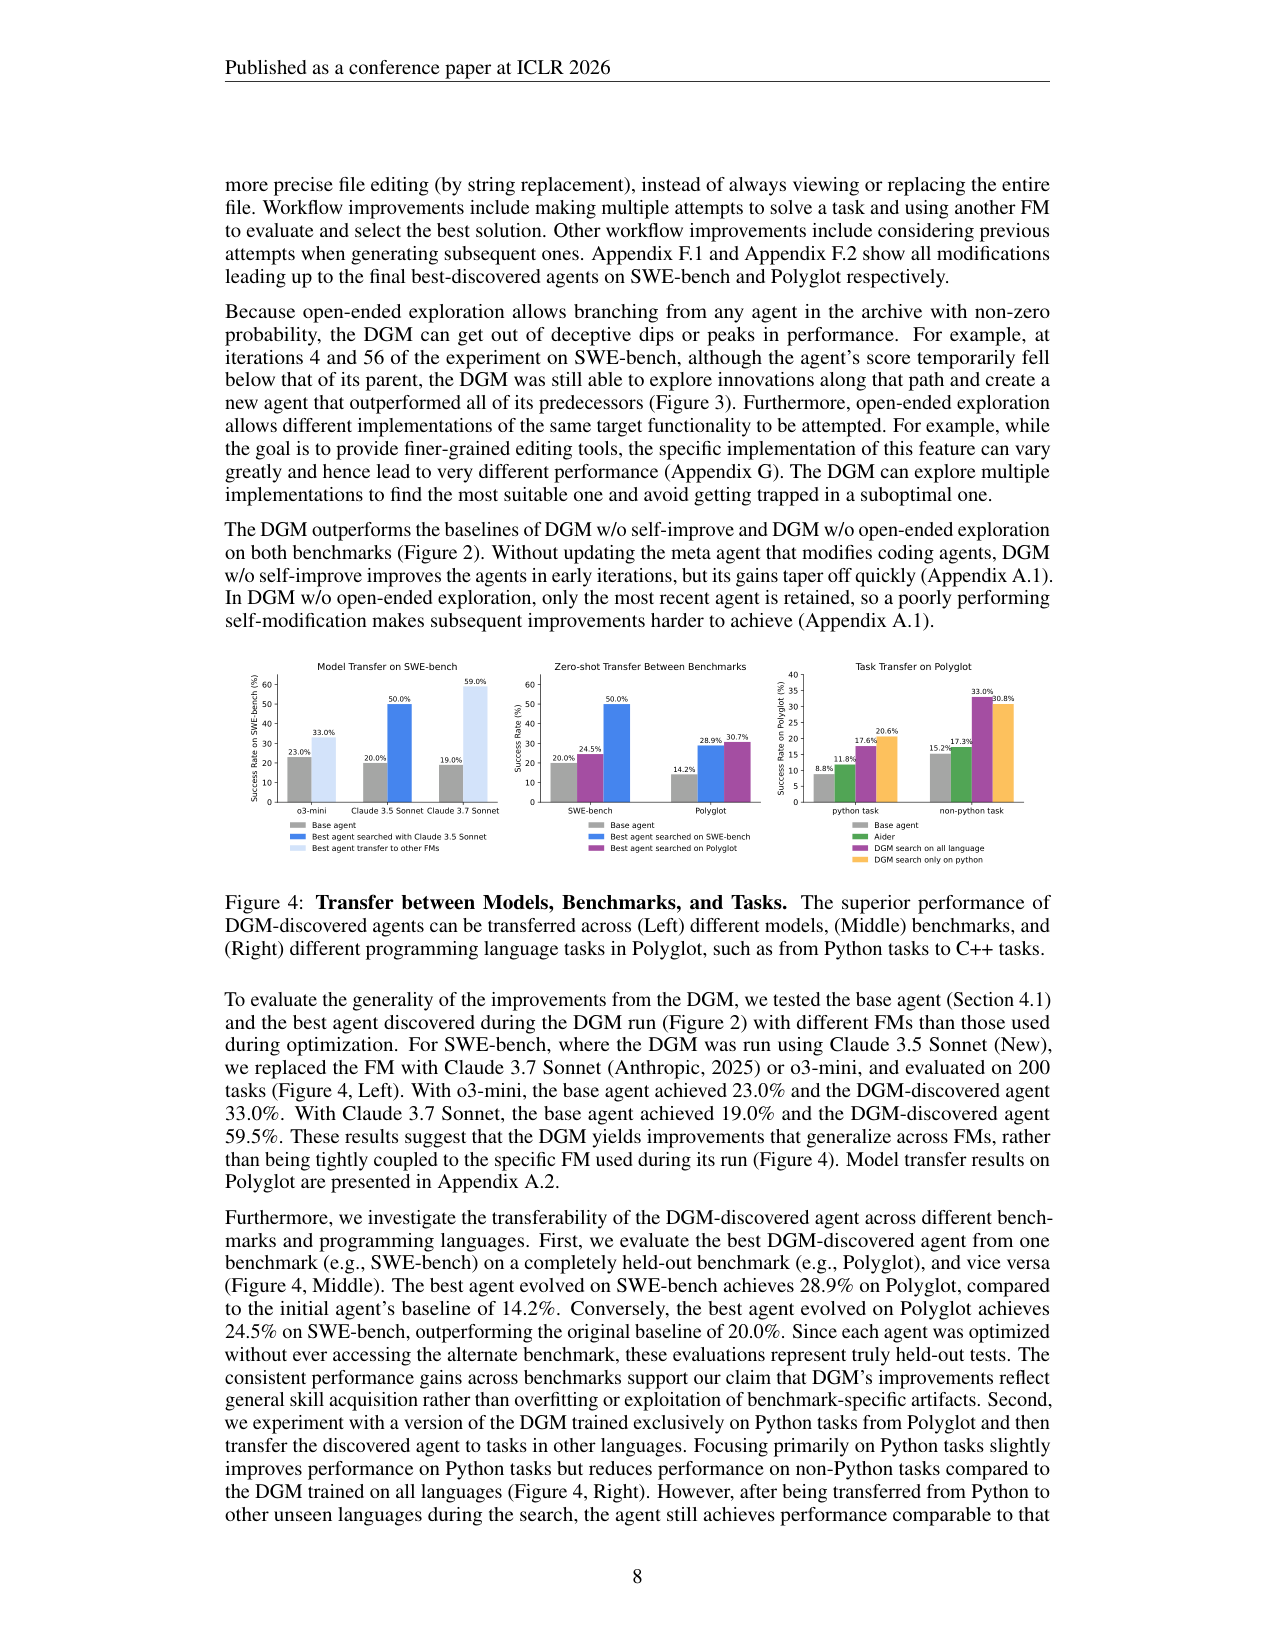
最值钱的是迁移性:SWE-bench 上进化的 agent 换到 o3-mini(23.0% → 33.0%)和 Claude 3.7 Sonnet(19.0% → 59.5%)依然提升;SWE-bench agent 零样本跑 Polyglot 拿到 28.9%(基座 14.2%),反之 Polyglot agent 跑 SWE-bench 24.5%(基座 20.0%)。它自动发现的改进也很有代表性:按行查看文件、字符串替换式编辑、上下文超限自动摘要、多 patch 生成加排名、历史感知的 patch 生成、让另一个 FM 做 peer-review——全是工具和工作流层面的改造,比 prompt 微调更可迁移。
局限:单次运行、编码专属、机制未自进化
四条。第一,每个 benchmark 只有一次 80 迭代的 run,无多 seed 统计;SWE-bench 一次跑约 2 周、API 费用高(附录 E.1)。第二,仍低于闭源 SOTA(作者自承),闭源方案靠大量手工工程。第三,对齐假设只在编码成立:编码表现等于自改进能力的等式,放到诗歌写作、奖励设计这些领域就断了——这是后续 Hyperagents 论文专门补的洞。第四,开放探索机制本身不参与自进化(论文自承留作 future work),parent selection 和档案维护仍是手工固定。另外评估子集敏感:Polyglot 子集 38.0% 对全量 30.7%,报数口径要看清。
一句话记住这篇
DGM 用「benchmark 实证」替代「形式化证明」,让编码 agent 用两个工具编辑自己的 harness 代码库,档案化开放探索避免局部最优。最该记住的数字:SWE-bench Verified 从 20.0% 涨到 50.0%,逼近同子集上开源 SOTA 的 51.0%;最该记住的边界:这套自改进只对编码成立,机制本身还没有自进化。
固定模型权重,让 coding agent 用 bash + editor 两个工具编辑自己的 harness 代码库:按「性能/孩子数」概率选 parent、把每个变体归档进开放探索树,80 次迭代内 SWE-bench Verified 从 20.0% 涨到 50.0%、Polyglot 从 14.2% 涨到 30.7%,且收益跨模型、跨 benchmark、跨语言迁移。
问题
要解决什么:让 AI 系统持续自我改进:编码 agent 把「改进自己」当成编码任务——分析自己的评估日志、给自己的代码库提出并实现新功能,并用 benchmark 实证验证每次改动。
为什么 prior work 不够:Gödel machine 要求形式化证明每次改动有益,实践中不可行;Hill-climbing 式自改进(如 Robeyns 2025)容易困在局部最优;固定 meta-agent 的框架(ADAS 等)把元层锁死。
进化循环(搜索空间 → 算子 → 评估 → 选择)
搜索空间(什么被进化):coding agent 自己的代码库:工具实现(bash/edit 两个工具的行为)、工作流逻辑、prompt 模板、上下文管理;底层 FM 权重冻结只读。边界:开放探索机制(archive 维护、parent selection)本身固定、不参与进化(论文自承留作 future work)。
变异/提案算子:
- 父 agent 读取自己的 benchmark 评估日志,提出下一个要实现的 feature,作为 problem statement 执行
- 用 bash + editor 工具实际编辑自己的代码库,生成新 coding agent
- 孩子若保留代码编辑能力才能继续繁殖;新 agent 由评估决定是否入档
- 论文未给出:feature 提议的具体 prompt 模板与失败重试策略的细节
评估方式:分级评估:先 10 个任务验基础编辑能力 → 60 任务子集估分 → SWE-bench 上若 >40% 且档案 top-2 再评估 200 任务;Polyglot 用随机 50 任务子集 + 事后全量复核。自修改过程用 Claude 3.5 Sonnet (New),SWE-bench 评估用 Claude 3.5 Sonnet、Polyglot 用 o3-mini;80 次迭代(SWE-bench 2 路并行、Polyglot 4 路并行)。
选择与归档:archive 保留所有发现的 agent;parent selection 大致正比于性能分、反比于「有代码编辑能力的孩子数」,且所有 agent 保留非零选择概率——低分节点也能当 stepping stone。对照组 DGM Greedy(只从最优分叉)SWE-bench 39.7% vs DGM 50.0%,证明开放探索的价值(附录 A.3)。
自我改进程度:L1(固定 FM 权重,harness 自进化):下游任务改进直接等于自改进能力提升,因为两者都是编码任务(对齐假设);论文自承开放探索机制未参与自进化。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|
输出
| 名称 | 类型 | 说明 |
|---|
数据集
| 数据 | 规模 | 备注 |
|---|
架构(摘要)
主干与结构
backbone:
参数:
类型:
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| SWE-bench Verified 成功率 | 20.0% → 50.0% | 同 200 任务子集上开源 SOTA OpenHands+CodeAct v2.1 为 51.0%;DGM w/o self-improve 39.0%;DGM w/o open-ended 23.0%;DGM Greedy 39.7% | SWE-bench Verified 子集(10→60→200 分级评估);80 次迭代;Claude 3.5 Sonnet (New);Figure 2 / 附录 A.3 表 1(§4.4) |
| Polyglot 成功率 | 50 任务子集 14.0% → 38.0%;全量 benchmark 14.2% → 30.7% | Aider 基座对照;DGM Greedy 30.0%;DGM w/o self-improve 28.0%;DGM w/o open-ended 14.0% | 随机 50 任务子集 + 全量复核;80 次迭代;评估用 o3-mini;Figure 2 / 附录 A.3 表 1(§4.4) |
| 跨模型迁移(SWE-bench,200 任务) | o3-mini:基座 23.0% → DGM agent 33.0%;Claude 3.7 Sonnet:基座 19.0% → DGM agent 59.5% | 各模型基座 agent | 用 Claude 3.5 Sonnet 进化出的 agent 换 FM 评估;Figure 4 左(§4.4) |
| 跨 benchmark 零样本迁移 | SWE-bench 进化 agent → Polyglot 28.9%(基座 14.2%);Polyglot 进化 agent → SWE-bench 24.5%(基座 20.0%) | 各 benchmark 初始基座 agent | 进化过程从未见过另一 benchmark;Figure 4 中(§4.4) |
| 自动发现的自改进 feature | 按行查看文件、字符串替换式编辑、上下文超限自动摘要、多 patch 生成 + 排名、历史感知的 patch 生成、peer-review 机制 | 初始 agent 的整文件查看/替换工具 | SWE-bench 与 Polyglot 档案树的修改日志;Figure 3 与附录 F(§4.4) |
Insights
- 自改进与下游任务对齐:评估任务是编码、自修改也是编码,编码能力提升直接翻译成自改进能力提升——这是「自我加速」得以成立的对齐假设。
- 开放探索树优于 hill-climbing:低分节点可以成为高分 stepping stone,性能下探后仍能继续爬升(Fig.3 的血统线)。
- 工具与工作流的自动改进(细粒度编辑、上下文摘要、peer-review)比 prompt 微调带来更可迁移的收益。
- 收益跨模型(Claude 3.7/o3-mini)、跨 benchmark(SWE↔Polyglot)、跨语言(Python→C++)迁移,说明学到的是通用技能。
- 安全设计(沙箱、超时、人工监督、可追溯档案)使自修改实验可控,论文同时承认 benchmark 优化可能放大 misalignment 的风险。
vs 同类工作
- 相
- 比
- R
- o
- b
- e
- y
- n
- s
- 2
- 0
- 2
- 5
- 等
- 单
- 链
- 自
- 改
- 进
- (
- h
- i
- l
- l
- -
- c
- l
- i
- m
- b
- i
- n
- g
- ,
- 总
- 从
- 最
- 优
- 分
- 叉
- )
- ,
- D
- G
- M
- 用
- a
- r
- c
- h
- i
- v
- e
- +
- 开
- 放
- 探
- 索
- 树
- 保
- 留
- 所
- 有
- 路
- 径
- ;
- 相
- 比
- A
- D
- A
- S
- 等
- 固
- 定
- m
- e
- t
- a
- -
- a
- g
- e
- n
- t
- 框
- 架
- ,
- D
- G
- M
- 的
- m
- e
- t
- a
- 层
- 就
- 是
- a
- g
- e
- n
- t
- 自
- 己
- (
- 没
- 有
- 单
- 独
- 的
- 手
- 工
- m
- e
- t
- a
- -
- a
- g
- e
- n
- t
- )
- ;
- 相
- 比
- G
- ö
- d
- e
- l
- m
- a
- c
- h
- i
- n
- e
- 的
- 形
- 式
- 化
- 证
- 明
- ,
- D
- G
- M
- 用
- b
- e
- n
- c
- h
- m
- a
- r
- k
- 实
- 证
- 替
- 代
- 证
- 明
- 。
局限
- 单次运行:每个 benchmark 只有一次 80 迭代的 run,无多 seed 统计;SWE-bench 一次 run 约 2 周、API 成本高(附录 E.1)。
- 仍低于闭源 SOTA:作者自承「falls short of closed-source SoTA SWE-bench solutions」,闭源方案依赖大量手工工程。
- 对齐假设只对编码成立:编码表现 ≈ 自改进能力的等式在其它领域(诗歌、奖励设计)不成立,这是后续 Hyperagents 论文专门解决的问题。
- 评估子集选择影响结论:SWE-bench 用 SWE-bench-verified-mini 采样、Polyglot 随机 50 任务,子集与全量的数字差(38.0% vs 30.7%)本身说明评估口径敏感。
- 开放探索机制(parent selection、archive 维护)固定、不参与自进化,论文自承这是 future work。
- 安全边界:沙箱限制当前实验范围,但「评估指标未覆盖安全/鲁棒性时,自改进循环可能放大 misalignment」的风险作者在安全节明确讨论,没有自动防护。
可复现性
全部开源(github.com/jennyzzt/dgm):基准 agent 定义(附录 C.1)、parent selection 与开放探索设置(附录 C.2)、算法伪代码(附录 C.4)、FM 与超参(附录 D.1)、SWE-bench/Polyglot 任务子集清单(附录 E.2/E.3)、完整修改日志(附录 F)。单次 run 约 2 周、依赖 Claude 3.5 Sonnet/o3-mini API,复现成本高。
DGM 架构:开放探索树的数据流
flowchart TD
    A["初始 coding agent(冻结 FM + bash 工具 + edit 工具)"] --> B["档案 archive(单 agent 起步,逐渐长成树)"]
    B --> C["parent 采样:概率 ∝ 性能分 / (1 + 有编辑能力的孩子数),全部非零"]
    C --> D["读自己的 benchmark 评估日志"]
    D --> E["提出下一个 feature(作为 problem statement)"]
    E --> F["自修改:bash + edit 编辑自己的代码库 → 新 agent"]
    F --> G["分级评估:10 任务(编辑能力)→ 60 任务 → 200 任务(SWE-bench)"]
    G --> H{"有代码编辑能力?"}
    H -- 是 --> I["入档(成为未来 parent 候选)"]
    H -- 否 --> J["淘汰"]
    I --> B
    B --> K["输出:档案中性能最高的 agent"]
组件详解
初始 agent:刻意做轻——冻结的 FM、两个工具(bash、edit)、单条输入 prompt(仓库位置 + 问题 + 测试框架)。起点简单,才能让后续改进清晰归因。自修改过程用 Claude 3.5 Sonnet (New),SWE-bench 评估用 Claude 3.5 Sonnet、Polyglot 用 o3-mini。
档案与 parent 采样:所有存活 agent 入档。选择概率大致正比于性能分、反比于「有代码编辑能力的孩子数」:强者被开采,未被开采的路径被保留,所有 agent 非零概率。DGM Greedy 消融(39.7% vs 50.0%)证明非贪心采样是收益来源。
自修改回路:parent 读评估日志 → 提 feature → 把 feature 当任务执行 → 编辑自己代码库。孩子继承父代代码库(带全部历史改进),因此改进可以叠加;只有保留编辑能力的 agent 才能继续繁殖。
分级评估漏斗:10 任务验基础编辑能力(快速淘汰);60 任务估分;SWE-bench 上 >40% 且档案 top-2 才上 200 任务。评估器是唯一真值,也是「自改进 = 编码能力」这一对齐假设的载体。
安全边界:所有 agent 执行与自修改在沙箱内、带严格超时;修改全程记录在档案中可追溯;人工监督贯穿。论文明确讨论:评估指标未覆盖安全/鲁棒性时,自改进循环可能放大 misalignment。
输出:80 次迭代后取档案最优 agent。它的改进集中在工具与工作流层(细粒度编辑、上下文摘要、多 patch 排名、peer-review),说明「改 harness 结构」比「改 prompt 措辞」的收益更可迁移。
与 hill-climbing 式自改进(Robeyns 2025)的差异:Robeyns 式系统每轮只从当前最优分叉,DGM 让档案里每个节点都有机会繁殖。图 3 的血统线显示最终最优 agent 的祖先有两次性能下探——在贪心规则下这些路径会被剪掉,在开放探索下它们成了突破的跳板。这是「开放探索树」与「单链自改进」在结构上的根本区别。
对齐假设的边界:这套架构的自我加速依赖「评估任务 = 自修改任务 = 编码」这个等式。等式成立时,下游收益直接变成自改进能力;等式断裂的领域(如诗歌写作),DGM 无法把任务表现转化为自改进技能——Hyperagents 论文正是为此把 meta agent 也变成可编辑程序。
Darwin Gödel Machine 总览:自修改 + 下游评估交替
原文 caption:The DGM iteratively builds a growing archive of agents by interleaving self-modification with downstream task evaluation. Agents in the archive are selected for self-modification through open-ended exploration. (caption 精简自原文)
全篇架构的入口:每个 agent 有两条产出路径——「自己 repo + 自改进指令 → 自修改 diff」和「任务 repo + 任务指令 → 解题 diff」;新 agent 评估后入档,档案再作为下一轮 parent 的来源。读图注意「Self-improve instruction」这一支:它由 agent 分析自己评估日志产生,是自引用闭环的位置。
SWE-bench 进化档案树与关键创新路径
原文 caption:The DGM automatically self-improves to become a better coding agent. (Left) Archive of coding agents generated during the DGM run on SWE-bench. (Right) Progress plot with the lineage of the final best agent. (caption 精简自原文)
证明「开放探索树」的价值:左图档案树里许多高分路径穿过低分节点,关键节点(如 node 24)之后创新爆发;右图最终最优 agent 的血统里有两次性能下探(dips)仍继续前进。读法:对照「DGM w/o open-ended exploration」(只保留最新)在 Fig.2 中提前停滞的曲线,理解为什么低分 stepping stone 有价值。
跨模型、跨 benchmark、跨语言迁移
原文 caption:The superior performance of DGM-discovered agents can be transferred across (Left) different models, (Middle) benchmarks, and (Right) different programming language tasks in Polyglot. (caption 精简自原文)
支撑「学到的是通用技能而非 benchmark 过拟合」:左图把 SWE-bench 上进化出的 agent 换到 o3-mini(23.0%→33.0%)与 Claude 3.7 Sonnet(19.0%→59.5%)依然提升;中图 SWE-bench agent 零样本跑 Polyglot 28.9%(基座 14.2%);右图只在 Python 任务上进化的 agent 迁移到 C++ 等未见语言仍优于 Aider。
让编码 agent 编辑自己的代码库,SWE-bench 从 20% 涨到 50%(对话版)
小播:今天聊 UBC、Vector 和 Sakana 的 ICLR 2026 论文,Darwin Gödel Machine。一句话先给结论:一个编码 agent,用两个工具改自己的代码库,80 次迭代里,SWE-bench Verified 的成功率从 20.0% 涨到 50.0%,逼近同子集上开源方案里最强的 51.0%。
老播:而且它发现的改进,比如按行查看文件、让另一个模型做 peer-review,跨模型、跨 benchmark、跨语言迁移都是正的——说明它学到的是通用技能。
小播:先记第一个记忆锚点:它改进的对象是自己的 harness 代码,不是模型权重,也不是提示词。
小播:为什么叫「Darwin Gödel Machine」?两个名字拼一起?
老播:Gödel machine 代表「形式化证明保证改进」的理想,Darwin 代表「变异加选择、不做预先证明」的现实——DGM 把 Gödel 的目标用 Darwin 的手段实现:每次自我修改就像一次基因突变,跑分就是自然选择,档案就是基因库。Figure 3 的档案树里,最终最优 agent 的祖先有两次明显的性能下探——在贪心规则下这两条路径早被剪掉,在开放探索下它们成了后期突破的跳板。
第一段:它要解决什么问题
老播:背景是「自改进 AI」的老问题。Gödel machine 的设想是系统每次修改自己都要有形式化证明,保证有益——实践里做不到,一个工具好不好用,得看模型和任务上下文,根本没法预先证明。所以 DGM 的选择是:不证明了,直接上 benchmark 试。
小播:那之前的方法卡在哪?
老播:两条路都会死。Hill-climbing 式自改进,每轮只从当前最优分叉,一次失败的修改就会把整条路带进沟里;固定 meta-agent 的框架,元层被手工锁死,系统只能在设计好的边界里改进。DGM 的应对是开放探索树:所有变体都进档案,每个 agent 都有非零概率被选中当 parent——低分节点也可能是未来高分的跳板。
第二段:循环怎么转
老播:具体流程:档案里按概率选一个 parent,概率大致正比于性能分、反比于它有代码编辑能力的孩子数——孩子多的说明这条血统被开采够了,减权;孩子少但分高,说明还没被开采,加权。然后让这个 parent 读自己的 benchmark 评估日志,提出下一个要实现的 feature,把「实现这个 feature」当成任务指令,用 bash 和 edit 两个工具改自己的代码库,生成新 agent。
小播:评估怎么筛?
老播:分级漏斗。先 10 个任务验基础编辑能力,没有编辑能力的直接淘汰;再 60 个任务估分;SWE-bench 上过了 40% 而且档案里排前二,才上 200 个任务。80 次迭代,SWE-bench 跑两路并行、Polyglot 跑四路。
小播:为什么这套能自我加速?
老播:因为对齐。下游任务要求改代码,自我改进也要求改代码——编码能力提升,直接等于自改进能力提升。这是 DGM 的核心假设,也是后面要打的问号。
小播:第二个记忆锚点:自改进和下游任务共用同一套编码技能,收益才能互相转化。
第三段:关键结果
老播:全部带 baseline 和 setup。SWE-bench Verified:从 20.0% 涨到 50.0%,同 200 任务子集上开源 SOTA OpenHands 加 CodeAct 是 51.0%。对照组:去掉自改进 39.0%,去掉开放探索 23.0%,贪心只从最优分叉 39.7%——开放探索单独值十多个点。Polyglot:50 任务子集从 14.0% 到 38.0%,全量 benchmark 从 14.2% 到 30.7%,超过 Aider 基线。
小播:迁移那些数字呢?
老播:SWE-bench 上进化的 agent 换到 o3-mini,基座 23.0% 变 33.0%;换到 Claude 3.7 Sonnet,基座 19.0% 变 59.5%。零样本跨 benchmark:SWE-bench 的 agent 跑 Polyglot 28.9%,基座只有 14.2%;反过来 Polyglot 的 agent 跑 SWE-bench 24.5%,基座 20.0%。
小播:它具体改了什么?
老播:改的全是工具和工作流:按行查看文件、字符串替换式编辑、上下文超限自动摘要、一次生成多个 patch 再排名、历史感知的 patch 生成、让另一个模型做 peer-review 挑最优解。这些比微调提示词更可迁移。
小播:第三个记忆锚点:收益来自工具和工作流层面的改造,迁移性最好。
第四段:局限
小播:冷水。哪里要打折?
老播:四条。第一,单次运行:每个 benchmark 只有一次 80 迭代的 run,没有多随机种子统计;SWE-bench 一次跑大约两周,API 费用很高。第二,还是低于闭源 SOTA,作者自己承认,闭源方案靠大量手工工程。第三,对齐假设只在编码成立:编码表现等于自改进能力这个等式,放到诗歌写作、奖励设计这些领域就断了。第四,开放探索机制本身——parent 选择和档案维护——没有参与自进化,还是手工固定的。另外评估子集很敏感:Polyglot 子集 38.0%,全量 30.7%,报数口径要看清楚。
小播:安全那边呢?
老播:所有执行和自修改都在沙箱里、带超时,修改全程记录可追溯,有人工监督。但论文也明说:评估指标没覆盖安全和鲁棒性的话,自改进循环可能把 misalignment 越放越大,这块没有自动防护。
收尾:一句话记住这篇
老播:收尾。DGM 用 benchmark 实证替代形式化证明,让编码 agent 用两个工具编辑自己的 harness 代码库,档案化开放探索避免局部最优。最该记住的数字:SWE-bench Verified 从 20.0% 涨到 50.0%,同子集开源 SOTA 是 51.0%。最该记住的边界:这套自我加速只对编码成立,探索机制本身还没有自进化。
小播:这篇值得读,它是「系统本身是优化目标」在 harness 层的一次完整落地。我们下期见。