DemoEvolve:稀疏反馈下,给 harness 进化配一副「示范」眼镜
> 量子位技术拆解 · 分数增益可能只是选择噪声——示范把 credit assignment 拉回正轨。完整结构化数据见「速查」tab。
先看一个现象:harness 进化(Meta-Harness 一系)把自生成 rollout 当作搜索信号——coding proposer 读历史代码、分数与执行轨迹,写下一个候选 harness。这套范式在文本与代码域很有效,因为失败局部、轨迹短、可归因。但清华与智元的这篇论文(arXiv 2605.24539)用游戏当试验场,问了一个更尖锐的问题:在 LLM 不熟的长时程随机世界里,稀疏、高方差、难归因的终局反馈,还能不能指导 harness 编辑? 答案是经常不能——而他们的解法是在自 rollout 存档里加入人类专家轨迹,作为 proposer 的 harness 级诊断参考。
核心思想:三种信息 regime
形式化上,harness 进化是对冻结模型 $\pi_\phi$ 周围的可执行结构 $h$ 求:
$$h^* = \arg\max_{h \in \mathcal{H}_T}\; \mathbb{E}_{x \sim X_T,\, \tau \sim p_{W_T,\pi_\phi,h}(\cdot|x)} \left[ R_T(\tau, x) \right]$$
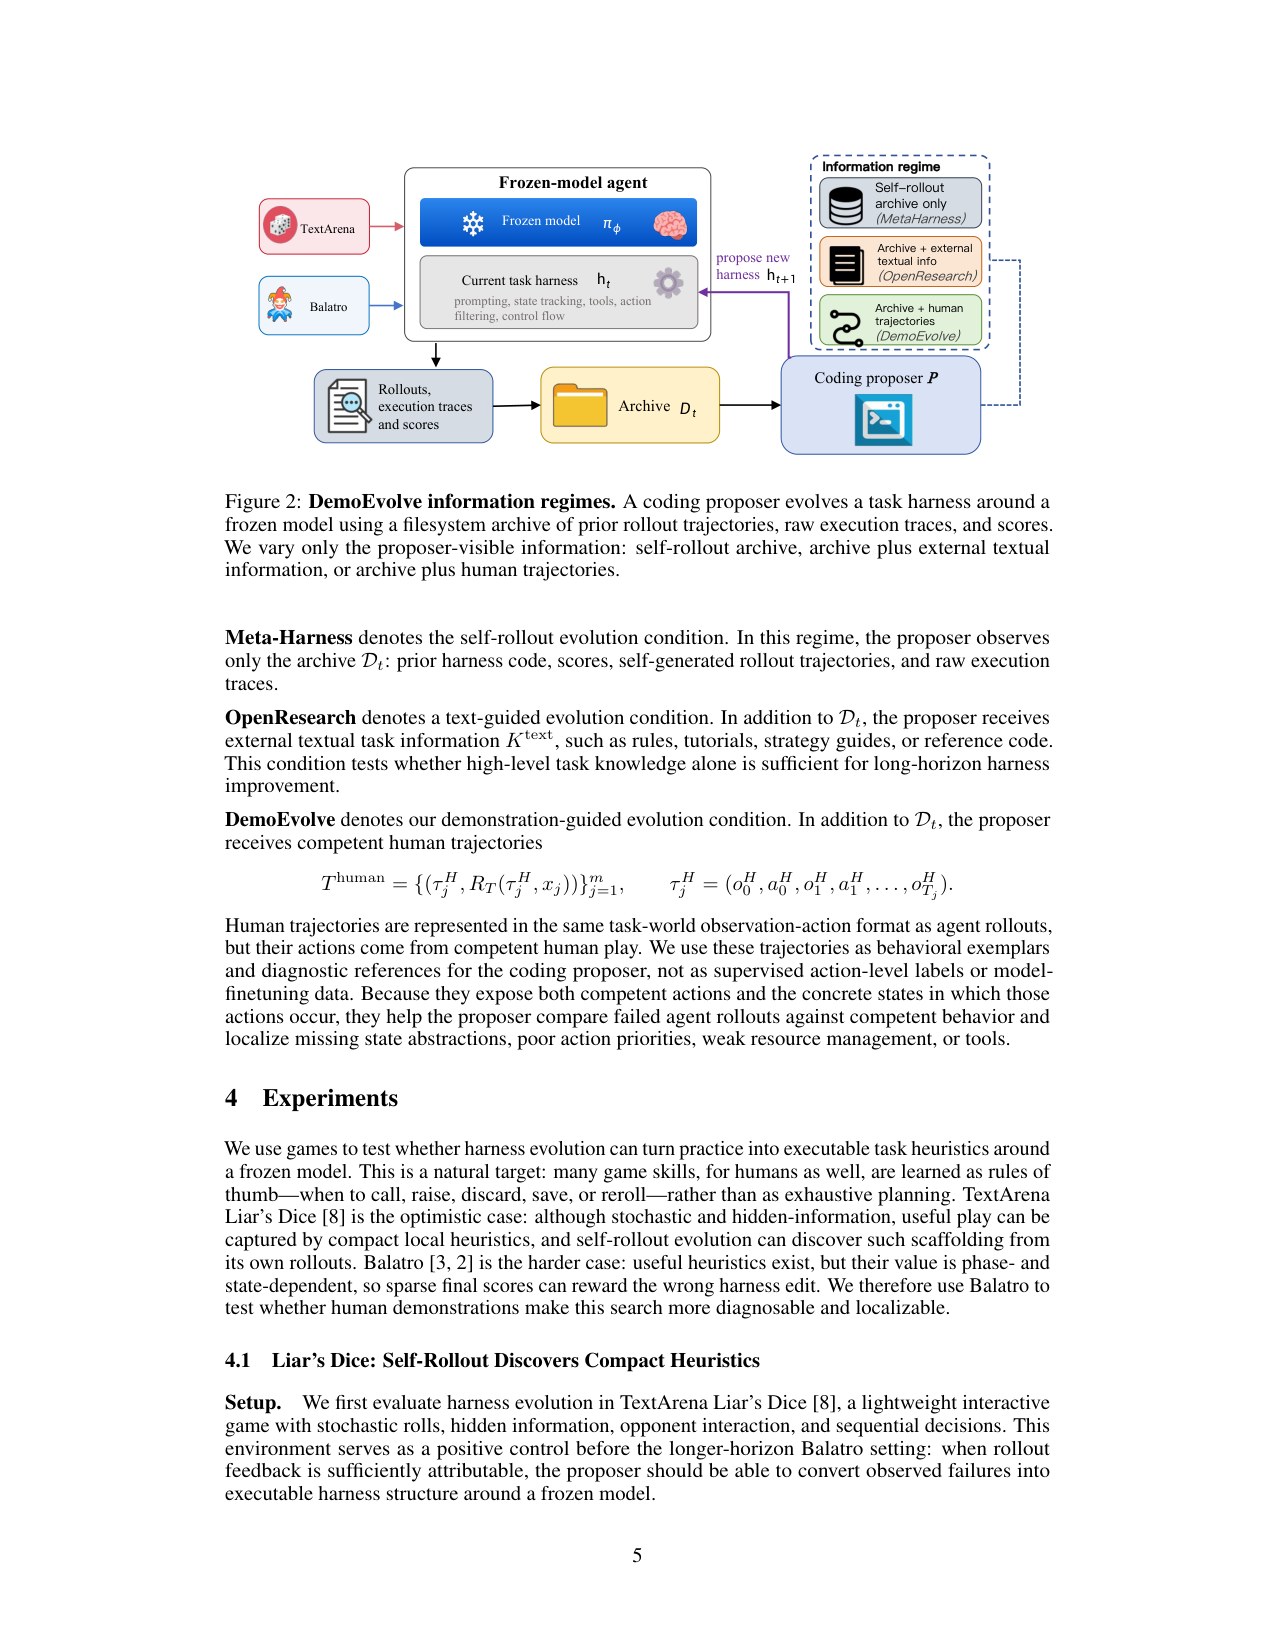
$R_T$ 是稀疏任务奖励(episode 末才给出),模型权重 $\phi$ 全程固定。外循环 proposer $P$ 是独立 coding agent,它可见的信息分三种 regime:$I_{\text{meta}} = D_t$(自 rollout 档案,即 Meta-Harness 条件)、$I_{\text{open}} = D_t \cup K_{\text{text}}$(档案 + 外部文本知识,即 OpenResearch 条件)、$I_{\text{demo}} = D_t \cup T_{\text{human}}$(档案 + 人类示范轨迹,即 DemoEvolve)。人类轨迹与 agent rollout 用完全相同的观测-动作格式,只当作行为范例与诊断参照——做示范的用途是给 proposer 正的状态-动作证据,而非给模型当监督标签。
正对照:Liar's Dice 里自 rollout 就够
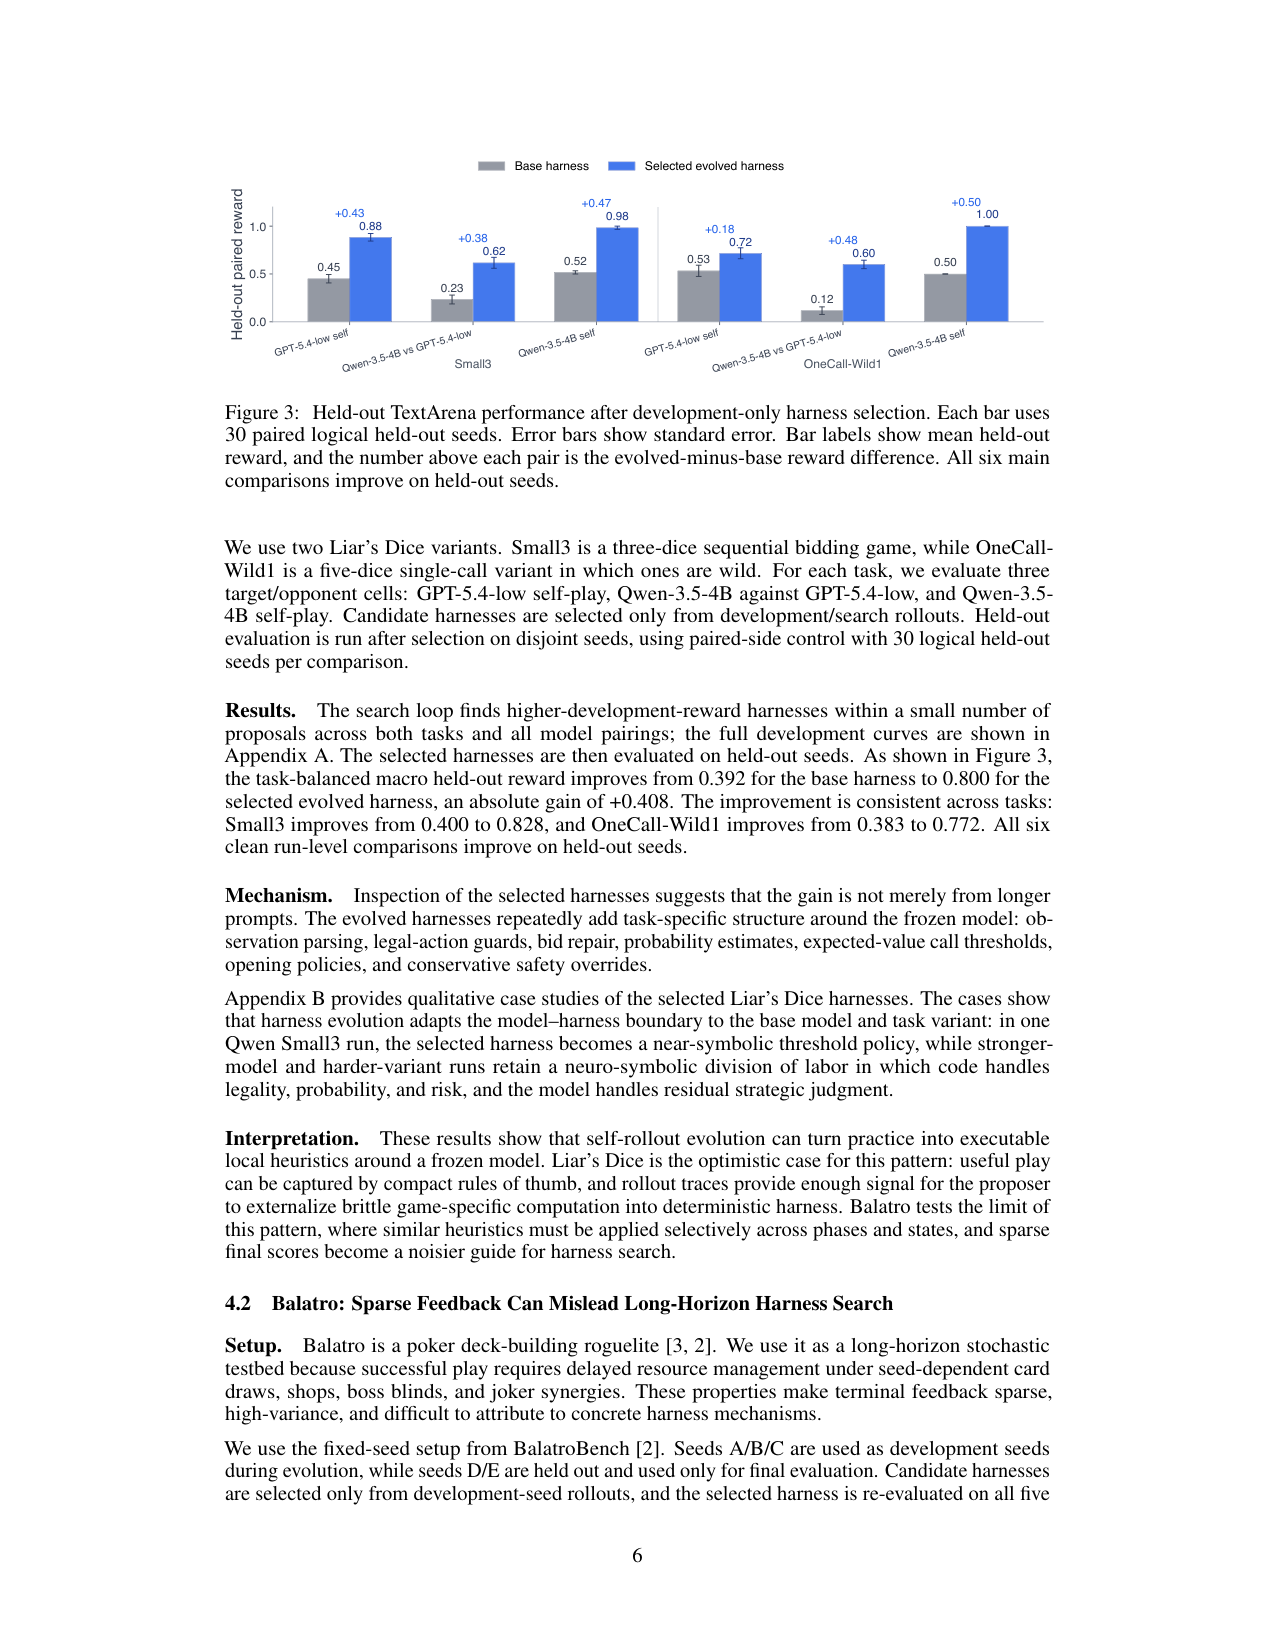
先看乐观情况。TextArena Liar's Dice(Small3 与 OneCall-Wild1 两个变体 × 三种对局配置)上,自 rollout 进化在开发 seed 上选出的 harness,在 30 个配对 held-out 逻辑 seed 上全部提升:宏平均 held-out 奖励从 0.392 到 0.800(+0.408),Small3 0.400→0.828、OneCall-Wild1 0.383→0.772。机制上,进化出的 harness 加了观测解析、合法动作守卫、出价修复、概率估计、期望值叫牌阈值等结构——失败可归因时,自生成经验足以驱动 harness 进化。
反例:Balatro 里自 rollout 被稀疏反馈误导
Balatro(扑克牌组构建 roguelite,固定 seed A/B/C 开发、D/E held-out,capped mean final round + 完成率)暴露了问题。Meta-Harness 看起来有 ID 增益(19.33 vs BalatroLLM 17.00,完成率 4/9 vs 3/9),但 OOD 从 16.83 掉到 16.33、完成率 2/6 不变——增益不迁移。审计发现原因:被选中的 harness 里那个意图中的动态 hook 因实现错误从未触发,所谓增益是 high-variance 候选选择噪声。OpenResearch 加了规则、教程、攻略文本,也没用(16.80、4/15)。而 DemoEvolve 完成 12/15(ID 8/9、OOD 4/6),OOD 均值 20.00,且被选编辑通过审计——示范把搜索从「碰运气选高分」拉回「确实改到模型面前」。
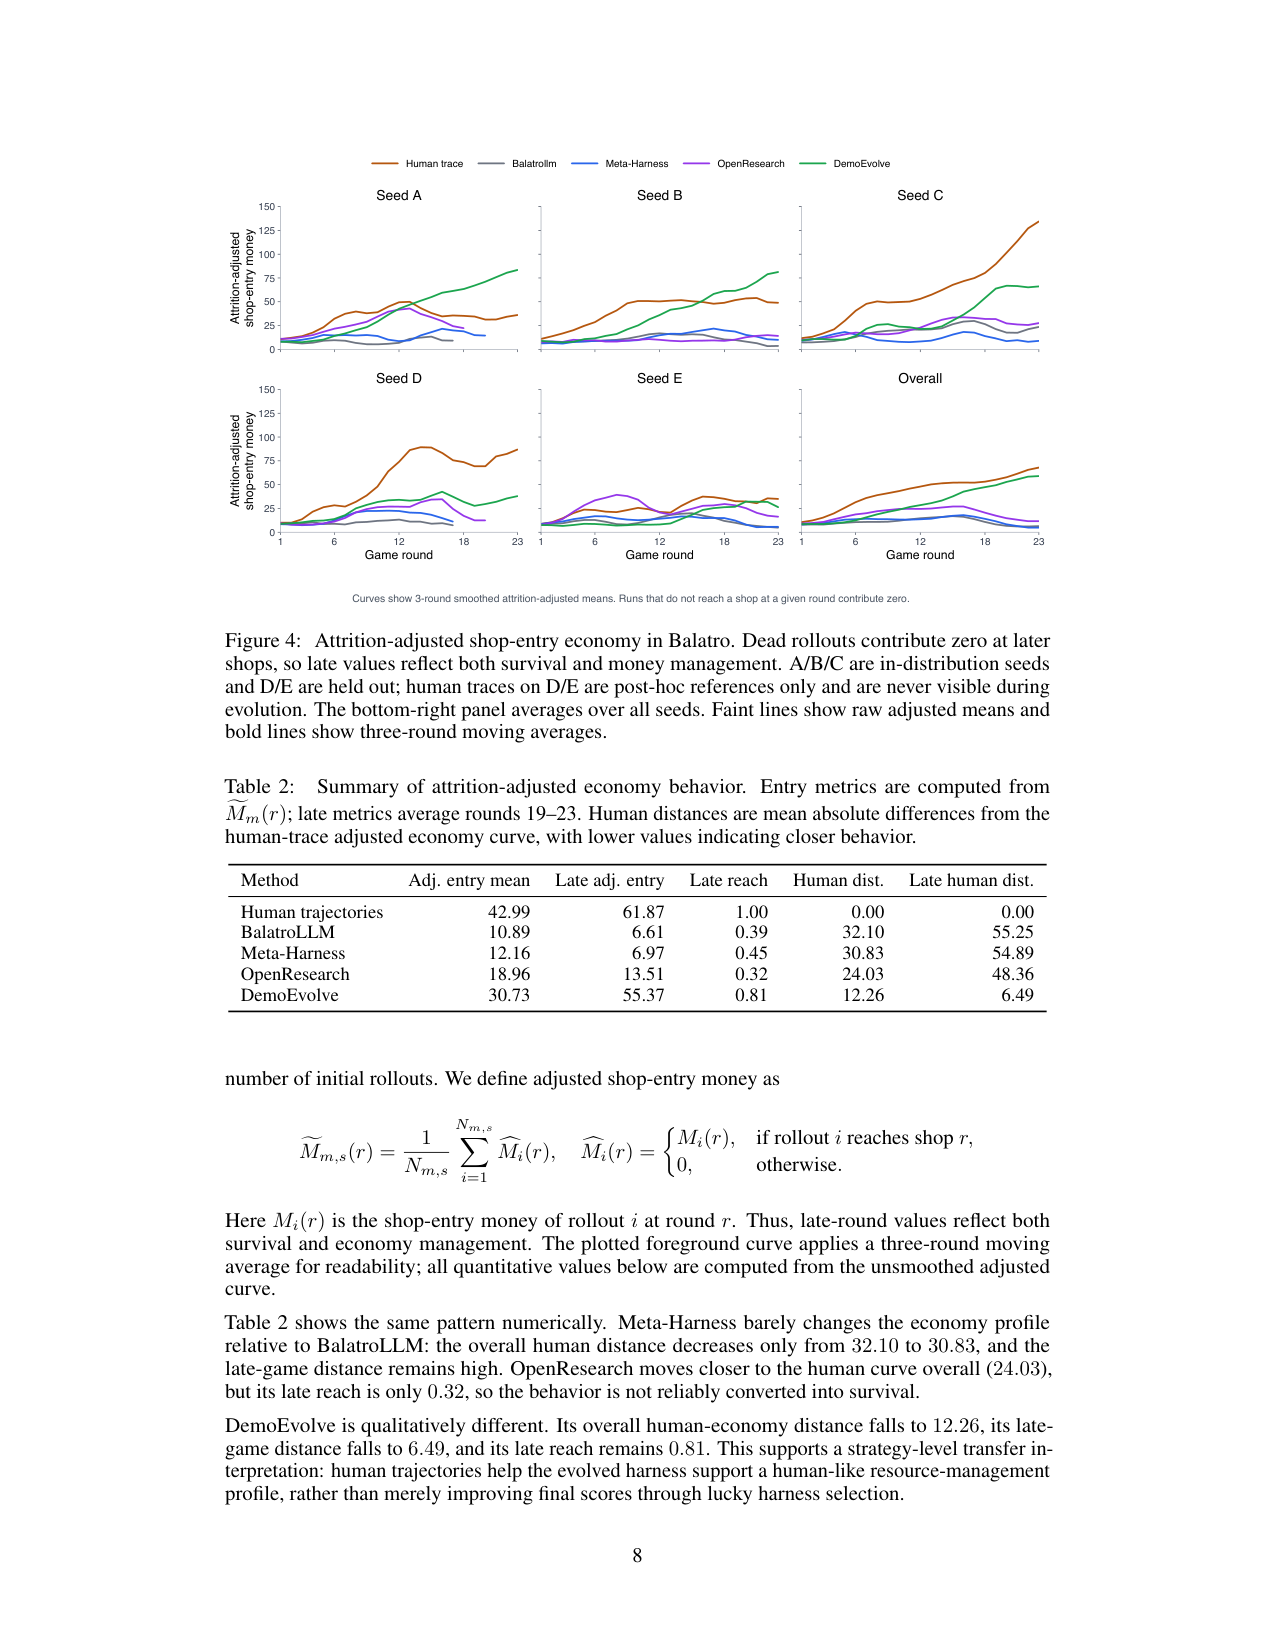
行为层面还有机制证据:示范转移的是人类式的经济管理策略。attrition-adjusted shop-entry money 与人类轨迹的距离,DemoEvolve 是 12.26(late 距离 6.49、late reach 0.81),而 BalatroLLM 32.10(55.25 / 0.39)、Meta-Harness 30.83(54.89 / 0.45)——harness 改对的不是分数,是行为曲线。
为什么示范有效:负证据 vs 正证据
论文用一个 5×3 诊断/设计研究定位了机制:让 5 个独立 proposer 复本检查同一批 BalatroLLM rollout,只变附加证据(无 / 人类笔记 / 人类轨迹),看提出的编辑是什么粒度(Persistent / Phase / State / Tool)。无证据时 Comp. rate(State+Tool 这类可执行决策支持的占比)46.2%——rollout 只定位「坏在哪」的负证据;纯文本笔记反而掉到 21.7%——原则没有状态边界,沦为持久/相位级提醒;人类轨迹回到 45.5%,但这次是带着「何时触发」的。典型例子:rollout 只看到「后期钱不够」的症状,笔记说「要省着花」,而人类轨迹显示——开局还没出牌、剩多次 discard、没有强牌时,高手会先弃牌再清关——于是 harness 编辑变成 round1_dig_hint,触发条件写死为 hands_played=0、discards_left≥2、early ante。示范补的是正的状态-动作反事实:原则 + 状态边界 = 可触发干预。
局限与边界
一个值得强调的对照是 BalatroLLM 基线本身:固定 harness、不做进化,完成 5/15;Meta-Harness 自 rollout 进化到 6/15——两者几乎一样,说明在稀疏反馈下「进化」本身并没有比「不进化」强多少,直到示范加入才出现 12/15 的跳变。
局限与边界
论文自承任务覆盖窄:主要证据来自 Balatro 一个游戏环境,Liar's Dice 只是正对照,工具 agent、终端任务、网页 agent、具身环境都没验证。我们补四条读出:统计功效弱——3 开发 + 2 held-out seed、每格 3 rollouts,完成率是 9/15、6/15 这种小样本;示范收集需要 competent human play,规模化代价与示范数量 $m$ 的选择没有敏感性分析;机制审计靠人工检查 hook 是否触发,规模化困难;选择规则是「按开发分数选单候选」,对开发 seed 的过拟合只是被 OOD 改善部分缓解。
一句话记住这篇
DemoEvolve 在自 rollout 档案里加入人类专家轨迹作为 proposer 的诊断参考:Liar's Dice 上自 rollout 本来就够用(held-out 0.392→0.800),Balatro 上 Meta-Harness 的 ID 增益不迁移、选中编辑的 hook 从未触发,加示范后完成率 12/15 vs 6/15。最该记住的判断是:稀疏反馈下分数增益可能只是选择噪声,示范的价值在于把「原则」变成「何时触发」——harness 级 credit assignment 需要正的状态-动作证据,光有负证据和文本规则都不够。
DemoEvolve 在自 rollout 存档之外把人类专家轨迹作为 proposer 的 harness 级诊断/编辑参考经验:Liar's Dice 上自 rollout 进化本来就有效(held-out 0.392→0.800),但 Balatro 这类长时程随机环境里稀疏反馈会误导搜索——Meta-Harness 的 ID 增益不迁移、且被选中编辑的 hook 因实现错误从未触发;加入人类示范后完成率 12/15 vs Meta-Harness 的 6/15,OOD 也提升(20.00 vs 16.33)。
问题
要解决什么:harness 进化把自生成 rollout 当作搜索信号,但作者要问:在 LLM 不熟的长时程随机交互世界里,稀疏、高方差、难归因的终局反馈是否还能指导 harness 编辑?答案是经常不能——分数增益可能是候选选择噪声而非因果的模型面向改进。
为什么 prior work 不够:Meta-Harness 式自 rollout 进化在文本/代码域有效,因为失败局部、轨迹短、可归因;在长时程随机环境里一个失败 run 含数百状态转移、早期小决定重塑未来分布、随机性让无效编辑看似有效;OpenResearch 式外部文本知识只给原则不给状态边界,Comp. rate 反而更低。
进化循环(搜索空间 → 算子 → 评估 → 选择)
搜索空间(什么被进化):围绕冻结模型 πφ 的 task harness h ∈ H_T:prompt 渲染、状态追踪、action filter、工具暴露、控制流等可执行结构;模型权重与 verifier 固定;演化目标是 h* = argmax_h E[R_T(τ, x)],外循环 proposer P 是独立 coding agent(执行 agent 之外)。
变异/提案算子:
- proposer 每轮检查历史 harness 与评估产物(代码、分数、轨迹、执行日志),诊断失败模式,写 1+ 个候选 harness h^{(t+1,j)},在开发实例上跑评估写进档案目录
- 三种信息 regime:I_meta = D_t(自 rollout 档案,即 Meta-Harness 条件)、I_open = D_t ∪ K_text(外部文本知识,即 OpenResearch 条件)、I_demo = D_t ∪ T_human(人类示范轨迹,即 DemoEvolve 条件)
- 人类示范以与 agent rollout 相同的观测-动作格式给出,作为行为范例与诊断参照,不做 action 级标签或微调数据
评估方式:稀疏任务奖励 R_T(τ, x)(episode 末才给出);Liar's Dice:30 个配对 held-out 逻辑 seed,候选仅由开发/搜索 rollout 选出;Balatro:BalatroBench 固定 seed A/B/C 开发、D/E held-out,capped mean final round + 完成率,每格 3 rollouts;另做 5×3 诊断/设计研究测量编辑定位粒度(Pers/Phase/State/Tool)。
选择与归档:按开发分数选候选 harness(单候选);关键审计:检查被选编辑是否 active/model-facing——hook 是否触发、state 变量是否计算并注入、模型调用输入或动作接口是否改变;Meta-Harness 被选候选的 hook 因实现错误从未触发,其 ID 增益被判为选择噪声;DemoEvolve 被选编辑通过审计。
自我改进程度:L1:固定模型 + harness 自进化。模型权重全程冻结,示范数据只用于 proposer 的诊断参考而非策略训练;本文同时暴露了 L1 在稀疏反馈下的脆弱性(自 rollout 搜索可被选择噪声误导)。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|
输出
| 名称 | 类型 | 说明 |
|---|
数据集
| 数据 | 规模 | 备注 |
|---|
架构(摘要)
主干与结构
backbone:
参数:
类型:
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| Liar's Dice 宏平均 held-out 奖励(配对 30 逻辑 seed) | 0.392 → 0.800(+0.408) | base harness 0.392;Small3 0.400→0.828、OneCall-Wild1 0.383→0.772 | TextArena;GPT-5.4-low / Qwen-3.5-4B 三种对局单元格;候选仅由开发 rollout 选出 |
| Balatro 完成率(capped mean final round,5 seeds × 3 rollouts) | DemoEvolve 22.00(12/15;ID 23.33 8/9,OOD 20.00 4/6) | Meta-Harness 18.13(6/15;ID 19.33 4/9 但 OOD 16.33 2/6);OpenResearch 16.80(4/15);BalatroLLM 16.93(5/15) | BalatroBench 固定 seed:A/B/C 开发、D/E held-out;所有进化条件共享初始 harness、预算、任务模型、proposer 与选择规则 |
| Meta-Harness 被选编辑的审计结果 | 意图中的动态 hook 从未被触发(实现错误),ID 增益被判为高方差候选选择噪声而非功能改进 | DemoEvolve 被选编辑通过审计(active、model-facing) | 对选中 harness 复播固定 seed rollout 并加日志,检查 hook 触发/state 注入/模型输入变化 |
| 经济行为(attrition-adjusted shop-entry money,人类距离越低越好) | DemoEvolve 整体距离 12.26、late 距离 6.49、late reach 0.81 | BalatroLLM 32.10 / 55.25 / 0.39;Meta-Harness 30.83 / 54.89 / 0.45;OpenResearch 24.03 / 48.36 / 0.32 | 5 seeds × 初始 rollout,死局在后续商店计 0;人类轨迹在 D/E 上仅作事后参考、进化期不可见 |
| 编辑定位粒度(5×3 诊断/设计研究,Comp. rate = State+Tool 占比) | 人类轨迹 45.5%(8 State + 4 Tool / 22) | 无附加证据 46.2%(10/26);纯文本笔记 21.7%(5/23) | 全部检查同一批 BalatroLLM rollout,5 个独立 proposer 复本;State=harness 触发计算决策变量注入,Tool=模型调用计算 |
Insights
- 稀疏反馈下『分数增益 ≠ 功能改进』:Meta-Harness 在 Balatro 的 ID 增益来自一个从未触发的 hook,自 rollout 搜索把选择噪声当成了因果信号——这正是 credit assignment 在 harness 程序搜索中的具体形态(§4.2)
- 示范提供正的状态-动作反事实:rollout 只告诉你哪里坏了(负证据),笔记只给原则(无状态边界),人类轨迹把『何时触发』讲清楚——round1_dig_hint 的触发条件是 hands_played=0、discards_left≥2、early ante(§4.4)
- 文本知识不够:OpenResearch 的 Comp. rate 21.7% 低于无附加证据的 46.2%,说明无观测-动作对齐的原则性提示反而把编辑推回持久/相位级提醒(§4.4)
- 自 rollout 进化有效的边界条件:Liar's Dice 里反馈局部可归因,因此 6/6 配对 held-out 全提升;Balatro 里稀疏终局奖励让同一机制失灵——论文把这条边界画得很清楚(§4.1 vs §4.2)
vs 同类工作
- vs Meta-Harness(自 rollout 档案):在长时程随机环境里被选择噪声误导,DemoEvolve 用示范补上正证据通道
- vs 外部文本知识(OpenResearch 条件):规则/教程/攻略给原则不给状态边界,Comp. rate 反而下降
- vs 传统 imitation learning:示范这里用于 harness 编辑的诊断与定位,不用于直接策略训练或模型微调(§2.2)
局限
- 任务覆盖窄:主要证据来自 Balatro 一个游戏环境,Liar's Dice 只是轻量正对照;工具 agent、终端任务、网页 agent、具身环境均未验证(论文自承,§6)
- 统计功效弱(我们读出):Balatro 只有 3 开发 + 2 held-out seed、每格 3 rollouts,完成率是 9/15、6/15 这种小样本;capped mean final round 抹平了终局内的奖励差异
- 示范成本与质量依赖未量化(我们读出):需要 competent human play 收集示范,规模化代价、示范数量 m 的选择都没有敏感性分析
- 机制审计依赖人工检查(hook 是否触发、state 是否注入),规模化困难;且选择规则是『按开发分数选单候选』,对开发 seed 的过拟合风险只是被 OOD 改善部分缓解(我们读出)
- 论文自承:示范把搜索变得更可诊断、可定位、更稳定,但并没有给出稀疏反馈下 harness 进化的理论保证,能否推广到其它游戏与真实任务仍是开放问题
可复现性
- code:论文未提供代码仓库;BalatroBench 固定 seed(balatrobench.com)与 TextArena Liar's Dice 公开可用
- weights:GPT-5.4-low、Qwen-3.5-4B(任务模型,冻结);proposer 为独立 coding agent
- sim_benchmark:TextArena Liar's Dice(Small3 / OneCall-Wild1)、BalatroBench(Balatro,seed A–E)
DemoEvolve 架构:三种信息 regime 的 harness 进化外循环
Mermaid 数据流
flowchart TD
    H["当前 task harness ht\n(prompt · 状态追踪 · action filter · 工具暴露 · 控制流)"] --> AGT["冻结模型 agent πφ\n(执行任务)"]
    AGT -->|"rollouts + 轨迹 + 分数"| ARC["档案 Dt\n(历史 harness 代码、评估产物)"]
    ARC --> PROP["coding proposer P\n(诊断失败模式,写候选 harness)"]
    INFO["信息 regime:\nI_meta = Dt(自 rollout)\nI_open = Dt ∪ K_text(外部文本)\nI_demo = Dt ∪ T_human(人类轨迹)"] --> PROP
    PROP -->|"候选 h^{(t+1,j)}"| DEV["开发实例评估\n(固定 seed:Balatro A/B/C;\nLiar's Dice 开发 seed)"]
    DEV -->|"分数 + 轨迹回填"| ARC
    DEV -->|"按分数选候选"| SEL["选择:单候选 harness\n(+ audit:hook 是否触发、\nstate 是否注入)"]
    SEL -->|"最终 harness"| HELD["held-out 复评\n(Balatro D/E seed;\nLiar's Dice 30 配对 seed)"]
组件详解
- 任务世界与 harness:$W_T$ 是任务世界(Liar's Dice / Balatro),$h \in \mathcal{H}_T$ 是任务导向 harness——决定观测如何表示、暴露哪些动作/工具、输出如何解析、动作如何执行;模型 $\pi_\phi$ 权重冻结,优化目标是 $h^* = \arg\max_h \mathbb{E}[R_T(\tau, x)]$。固定 seed 让 evaluator 侧可复现,但 agent 视角仍有不确定性(看不到完整状态),这是「可控动态」的来源。
设计要点
1. 信息是唯一自变量:三条件共享全部其它设置,Balatro 上 12/15 vs 6/15 的完成率差异可干净归因到「示范」。
2. 正证据补负证据:rollout 只定位「坏在哪」(负证据),文本给原则(无状态边界),示范给「原则 + 何时触发」的正反事实——这是 DemoEvolve 比 Meta-Harness 与 OpenResearch 都有效的机制解释。
3. 诊断与设计分离:5×3 研究把「定位缺陷」与「给出修正信号」分开测量,示范的 Comp. rate 45.5% 与无证据 46.2% 相当,但 ground 在可触发条件上。
4. 审计防幻觉增益:选择环节的 replay 审计是整篇可信度的支点——没有它,Meta-Harness 的 ID 增益会被当成真改进。
三种信息 regime:档案、档案+文本、档案+人类轨迹
原文 caption:DemoEvolve information regimes. A coding proposer evolves a task harness around a frozen model using a filesystem archive of prior rollout trajectories, raw execution traces, and scores. We vary only the proposer-visible information: self-rollout archive, archive plus external textual information, or archive plus human trajectories.
方法核心图:所有条件共享同一外循环(冻结模型 + 当前 harness + 档案 D_t + coding proposer),唯一变量是 proposer 可见信息。读图要点:DemoEvolve 与 Meta-Harness 的差异只在这一个输入通道——这保证 Balatro 结果里 12/15 vs 6/15 的完成率差距能被归因到『示范』而非其它设置。
Liar's Dice held-out:自 rollout 进化在可归因环境下有效
原文 caption:Held-out TextArena performance after development-only harness selection. Each bar uses 30 paired logical held-out seeds. Error bars show standard error. Bar labels show mean held-out reward; the number above each pair is the evolved-minus-base reward difference.
正对照证据:六个对比(Small3 / OneCall-Wild1 × GPT-5.4-low 自对弈 / Qwen-3.5-4B 对 GPT-5.4-low / Qwen-3.5-4B 自对弈)在 held-out seed 上全部提升,宏平均 0.392→0.800。读图理解论文的论证顺序:先证明『反馈可归因时自 rollout 够用』,再在 Balatro 展示它失效的边界条件,示范的价值只有在第二个场景才显现。
Balatro 经济行为:DemoEvolve 逼近人类曲线
原文 caption:Attrition-adjusted shop-entry economy in Balatro. Dead rollouts contribute zero at later shops, so late values reflect both survival and money management. A/B/C are in-distribution seeds and D/E are held out; human traces on D/E are post-hoc references only and are never visible during evolution.
机制证据:DemoEvolve 的整体 human-economy 距离 12.26、late 距离 6.49、late reach 0.81,远好于 BalatroLLM(32.10 / 55.25 / 0.39)与 Meta-Harness(30.83 / 54.89 / 0.45)。读图结论:示范转移的是『人类式的资源管理策略』而非碰巧高分的 harness——经济曲线形态比终局分数更能说明 harness 改对了地方。
DemoEvolve:稀疏反馈下,给 harness 进化配一副「示范」眼镜(对话版)
小播:今天聊一篇很会「拆台」的论文——它发现自进化 AI 的一个加分可能是假的,然后给出一个修复方案。
老播:对,清华和智元的团队,论文叫 DemoEvolve。它先证明一件事:在长时程随机环境里,自 rollout 的 harness 进化会被稀疏反馈误导——看着涨分的编辑,实际可能根本没生效。然后它给解法:在自 rollout 档案里加入人类专家的示范轨迹,作为改外壳的参考。结果完成率从 6 比 15 涨到 12 比 15。
小播:先解释两个词:harness 是什么?自 rollout 又是什么?
老播:harness 就是 agent 的外壳——提示词、状态追踪、动作过滤、工具暴露这些可执行结构。自 rollout 进化就是:让 agent 自己玩、收集自己的轨迹和分数,然后一个写代码的 proposer 读了这些档案,写下一个更好的外壳。这个范式在文本和代码任务上很有效,但这篇论文想问:换个环境还灵吗?
第一段:问题——分数可能是假的
小播:为什么不灵?
老播:因为他们挑了两个游戏当试验场。一个是骰子游戏 Liar's Dice,回合短、反馈好归因;另一个是 Balatro,扑克牌组构建 roguelite,一局几百步、终局才给分、随机性大。后者的关键问题是:一个失败的 run 里有几百个状态转移,到底哪一步改坏了、哪个外壳机制该背锅,从终局分数里根本看不出来。
小播:那「假加分」具体长什么样?
老播:他们在 Balatro 上复现了别人的 Meta-Harness 方法——只用自 rollout 档案进化。结果在开发用的种子上,通过率看着涨了,从 17.00 到 19.33;但换到没见过的种子,从 16.83 掉到 16.33,完成率原地不动。然后他们做了一个审计:把被选中的外壳拿出来复播,加日志检查。结果发现那个外壳里设计好的动态钩子,因为实现错误,从头到尾就没触发过——涨分纯属高方差随机撞出来的。
小播:也就是说,分数增益可能是选择噪声,不是真改进?
老播:对,这是全篇最核心的警示。而且他们还测了另一种补丁:给 proposer 加外部文本知识——规则、教程、攻略。结果也没用,完成率 4 比 15。文本给原则,但给不出「这个原则该在哪个状态触发」。所以我们看到三个条件在同一个预算下比赛:自 rollout 6 比 15,加文本 4 比 15,加人类示范 12 比 15。
第二段:机制——示范补的是「正的状态-动作证据」
小播:那人类示范到底提供了什么,文本给不了?
老播:示范轨迹和 agent 自己的轨迹用完全相同的格式——观测、动作、观测、动作。区别在于动作来自会玩的真人。proposer 拿到它,可以把失败的 agent 轨迹和成功的人类轨迹摆在一起对比:缺了哪个状态抽象、哪个动作优先级错了、哪个资源没管好。示范不拿来当监督标签训练模型,只当改外壳时的诊断参照。
小播:能不能给个具体的例子?
老播:Balatro 里有个典型:只给 rollout,你只能看到「后期钱不够花」这个症状,于是改成一个购物侧的省钱补丁;给文本笔记,你知道要省着花,但没有状态边界,改出来的还是提醒式的话;给人类轨迹,你看到高手在开局——还没出过牌、还剩多次弃牌、手里没有强牌——会先弃牌再清关。于是外壳编辑变成一条带触发条件的提示:只在「没出过牌、弃牌次数大于等于 2、前期」时才注入。这就是原则加状态边界等于可触发干预。
小播:所以示范的价值是「正的反事实」?
老播:对。rollout 只告诉你坏在哪——负证据;文本给原则但没有状态边界;示范把「什么时候该怎么做」讲清楚。他们还做了一个 5 乘 3 的定位实验量化这一点:同一个诊断任务,只给 rollout 时,46.2% 的编辑是带可执行决策支持的;只给文本笔记,掉到 21.7%——原则没有状态对齐,反而把编辑推回持久提醒;给人类轨迹,回到 45.5%,而且这次是带着触发条件的。
第三段:关键结果——两个游戏,两个结论
小播:那 Liar's Dice 那边呢?你开头说它有效。
老播:对,那边是正对照。骰子游戏回合短、反馈可归因,自 rollout 进化就够了:选出的外壳在 30 个没见过的种子上全部提升,宏平均奖励从 0.392 到 0.800。进化出的外壳加了观测解析、合法动作守卫、概率估计这些结构。这说明论文的结论是「有条件」的:反馈可归因时自 rollout 够用,Balatro 那种长时程随机环境才需要示范。
小播:Balatro 那边除了完成率,还有别的证据吗?
老播:有,行为层面的。他们画了「经济曲线」——每个商店阶段进场时的钱,加上死亡率校正。人类示范进化出的外壳,这条曲线整体距离人类只有 12.26,后期距离 6.49,后期存活率 0.81;而自 rollout 是 30.83 和 54.89、存活率 0.45。也就是说,示范转移的是人类式的资源管理策略,而不只是碰巧拿高分——harness 改对了行为,分数是结果。
第四段:局限与争议
小播:那这套方法的边界在哪?
老播:论文自承最大的局限是任务覆盖:主要证据就 Balatro 一个游戏环境,Liar's Dice 只是轻量正对照,工具 agent、终端任务、网页 agent、具身环境全都没验证。示范这条路能不能泛化出去,是开放问题。
小播:你还有别的担心吗?
老播:有,我们读出来四条。一是统计功效弱:Balatro 只有 3 个开发种子加 2 个测试种子,每格 3 次 rollout,完成率是 9 比 15、6 比 15 这种小样本,运气成分不小。二是示范的收集成本没量化——需要会玩的人类录轨迹,示范数量选多少也没有敏感性分析。三是「编辑有没有生效」的审计靠人工检查钩子触发和状态注入,规模化困难。四是选择规则是「按开发分数选一个」,对开发种子的过拟合只是被测试集改善部分缓解,没根除。
小播:所以它最稳的贡献是什么?
老播:最稳的是那个「假加分」的审计框架——它证明了稀疏反馈下,端到端分数不能当 harness 改进的证据,必须回放验证编辑到底有没有生效。这个教训适用于所有自进化系统。
收尾:一句话记住这篇
小播:最后用一句话总结?
老播:DemoEvolve 在自 rollout 档案里加入人类示范轨迹,作为改外壳的诊断参考:Liar's Dice 上自 rollout 本来就够用,Balatro 上 Meta-Harness 的涨分被审计为假增益,加示范后完成率从 6 比 15 涨到 12 比 15。
小播:最该记住的数字呢?
老播:12 比 15,对 6 比 15——这是 Balatro 上「有示范」和「只有自 rollout」的完成率对比。数字背后那句更重要:稀疏反馈下分数可能骗人,示范的价值是把「原则」变成「何时触发」。读这篇的时候,记住那个从未触发的钩子——它比任何涨分数字都值得记住。