AFlow:用 MCTS 把 agentic workflow「长」出来
> 量子位技术拆解 · 先给现象再给机制。完整结构化数据见「速查」tab。
先看一个现象:LLM 解决复杂任务靠的是 workflow——一串 LLM 调用节点按顺序、按条件组合。但 workflow 是人设计的。DSPy 要你先搭好骨架再优化 prompt;GPT-Swarm 用图表示,表达不了「如果错了就换路」这种条件逻辑;ADAS 用代码表示,可它的搜索是线性启发式,历史存成列表,限定迭代内搜不出好 workflow。AFlow(ICLR 2025)的切入点是:workflow 生成本质是一个搜索问题,而搜索算法应该用 MCTS。
核心机制:节点 + 算子 + 代码边,交给 MCTS 四步循环
AFlow 把 workflow 定义成 LLM 调用节点(node)连边(edge)的序列。每个节点有四个参数:模型 $M$、prompt $P$、温度 $\tau$、输出格式 $F$。边用代码表示——代码天然支持线性、条件、循环,表达力超过图。
为了缩小搜索空间,AFlow 做两个简化:固定节点的 model/temperature/format,只让 prompt 和代码边可编辑;同时预定义 operator 集合(Generate、Format、Review&Revise、Ensemble、Test、Programmer、Custom)把常见 agent 操作打包成统一接口。于是搜索空间写成:
$$\mathcal{S}_{\text{AFlow}} = \{(P_1,\dots,P_n, E, O_1,\dots,O_n) \mid P_i \in \mathcal{P},\; E \in \mathcal{E},\; O_i \in \mathcal{O}\}$$
即一组 prompt、一条代码边、一组算子组合。目标是从空模板找让评估函数 $G$ 最大的 workflow:
$$W^{*} = \arg\max_{W \in \mathcal{S}_{\text{AFlow}}} G(W, T)$$
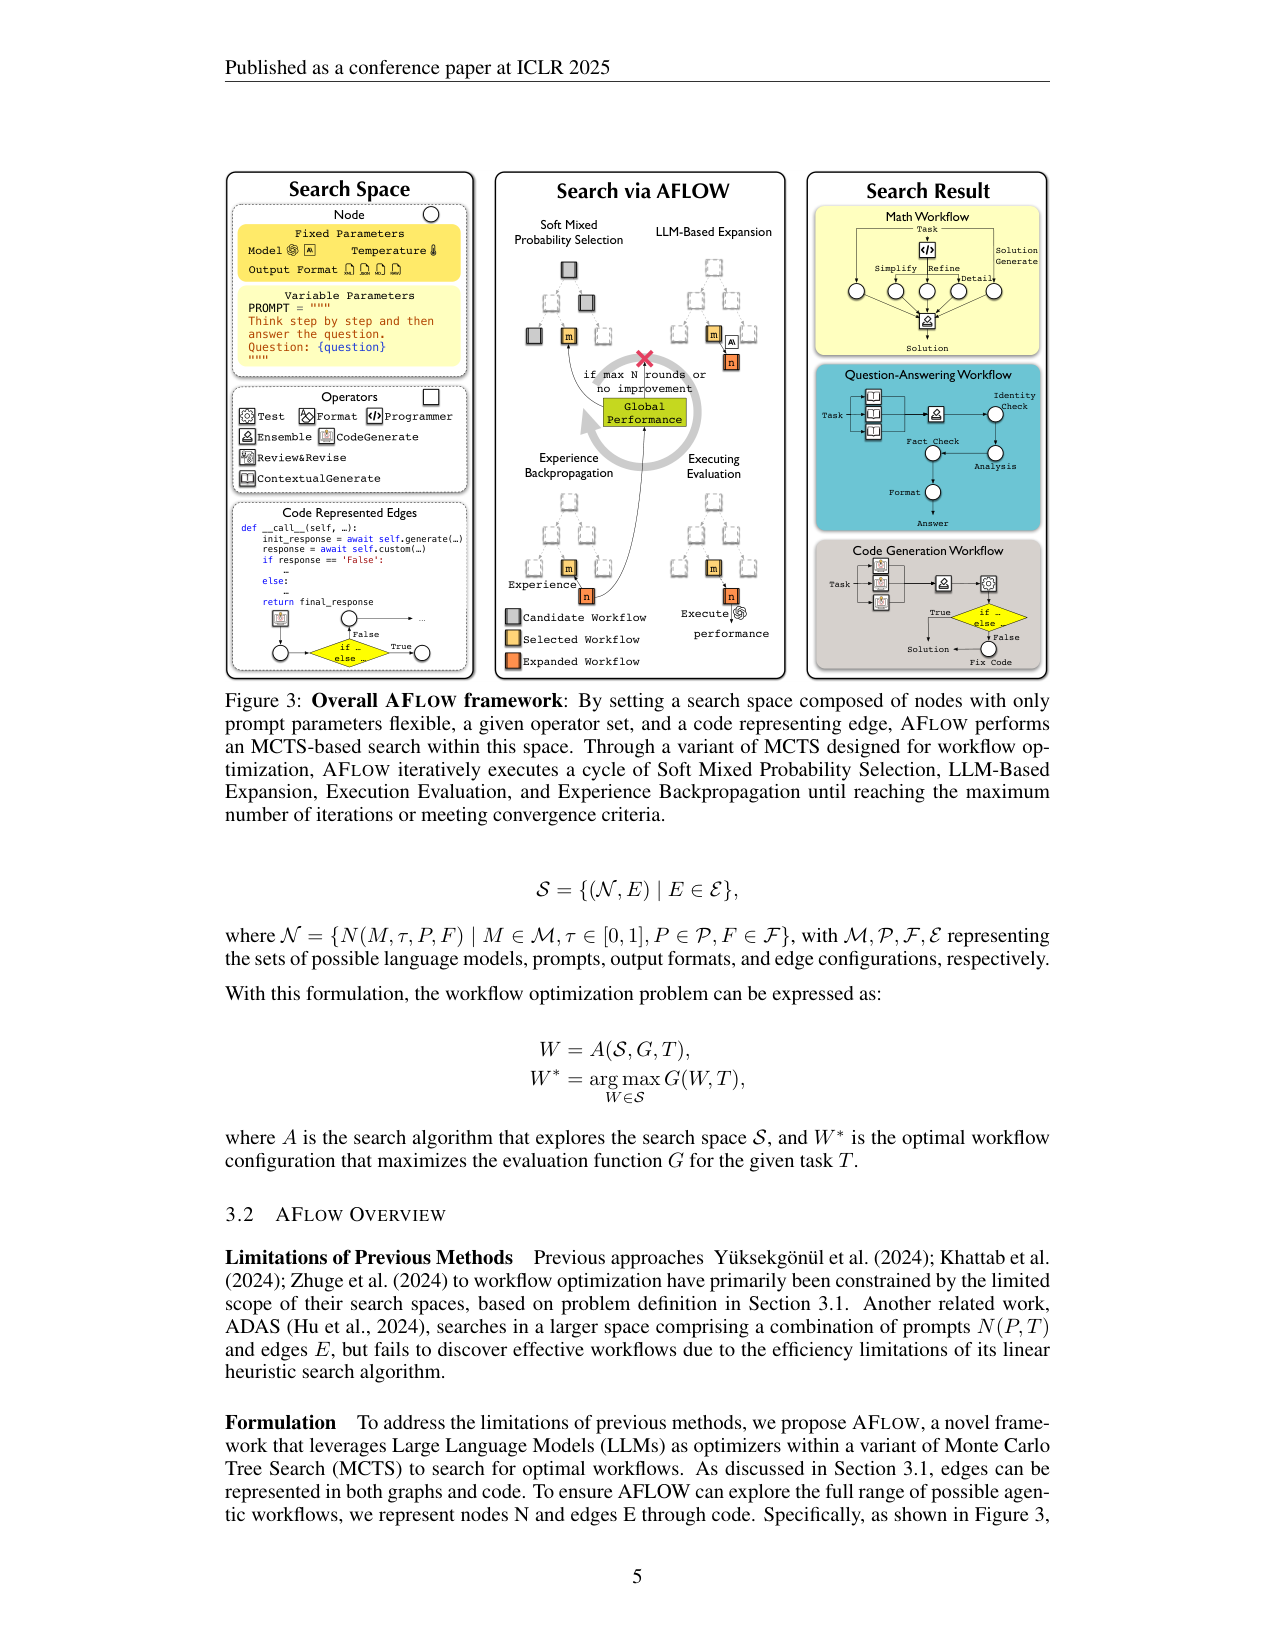
搜索用 MCTS 变体,四步循环(Figure 3):
1. Soft Mixed Probability Selection:按分数 + 均匀探索的软混合选一个节点。
2. LLM-Based Expansion:优化器(Claude-3.5-sonnet)基于父节点表现,做单步修改——加一个算子或改一段 prompt。
3. Execution Evaluation:执行新 workflow,算数值 fitness。
4. Experience Backpropagation:把经验回填到树里。
单步修改 + 树回溯是关键:失败的尝试(比如 round 5 加了个不合适的 review 节点、round 14 过度关注「折扣」信息)被丢弃,成功的路径保留继续优化。这比 ADAS 的线性列表高效得多。
关键结果:平均 80.3%,成本打一折
六个 benchmark,全部用 GPT-4o-mini 执行、3 次取平均(Table 1):
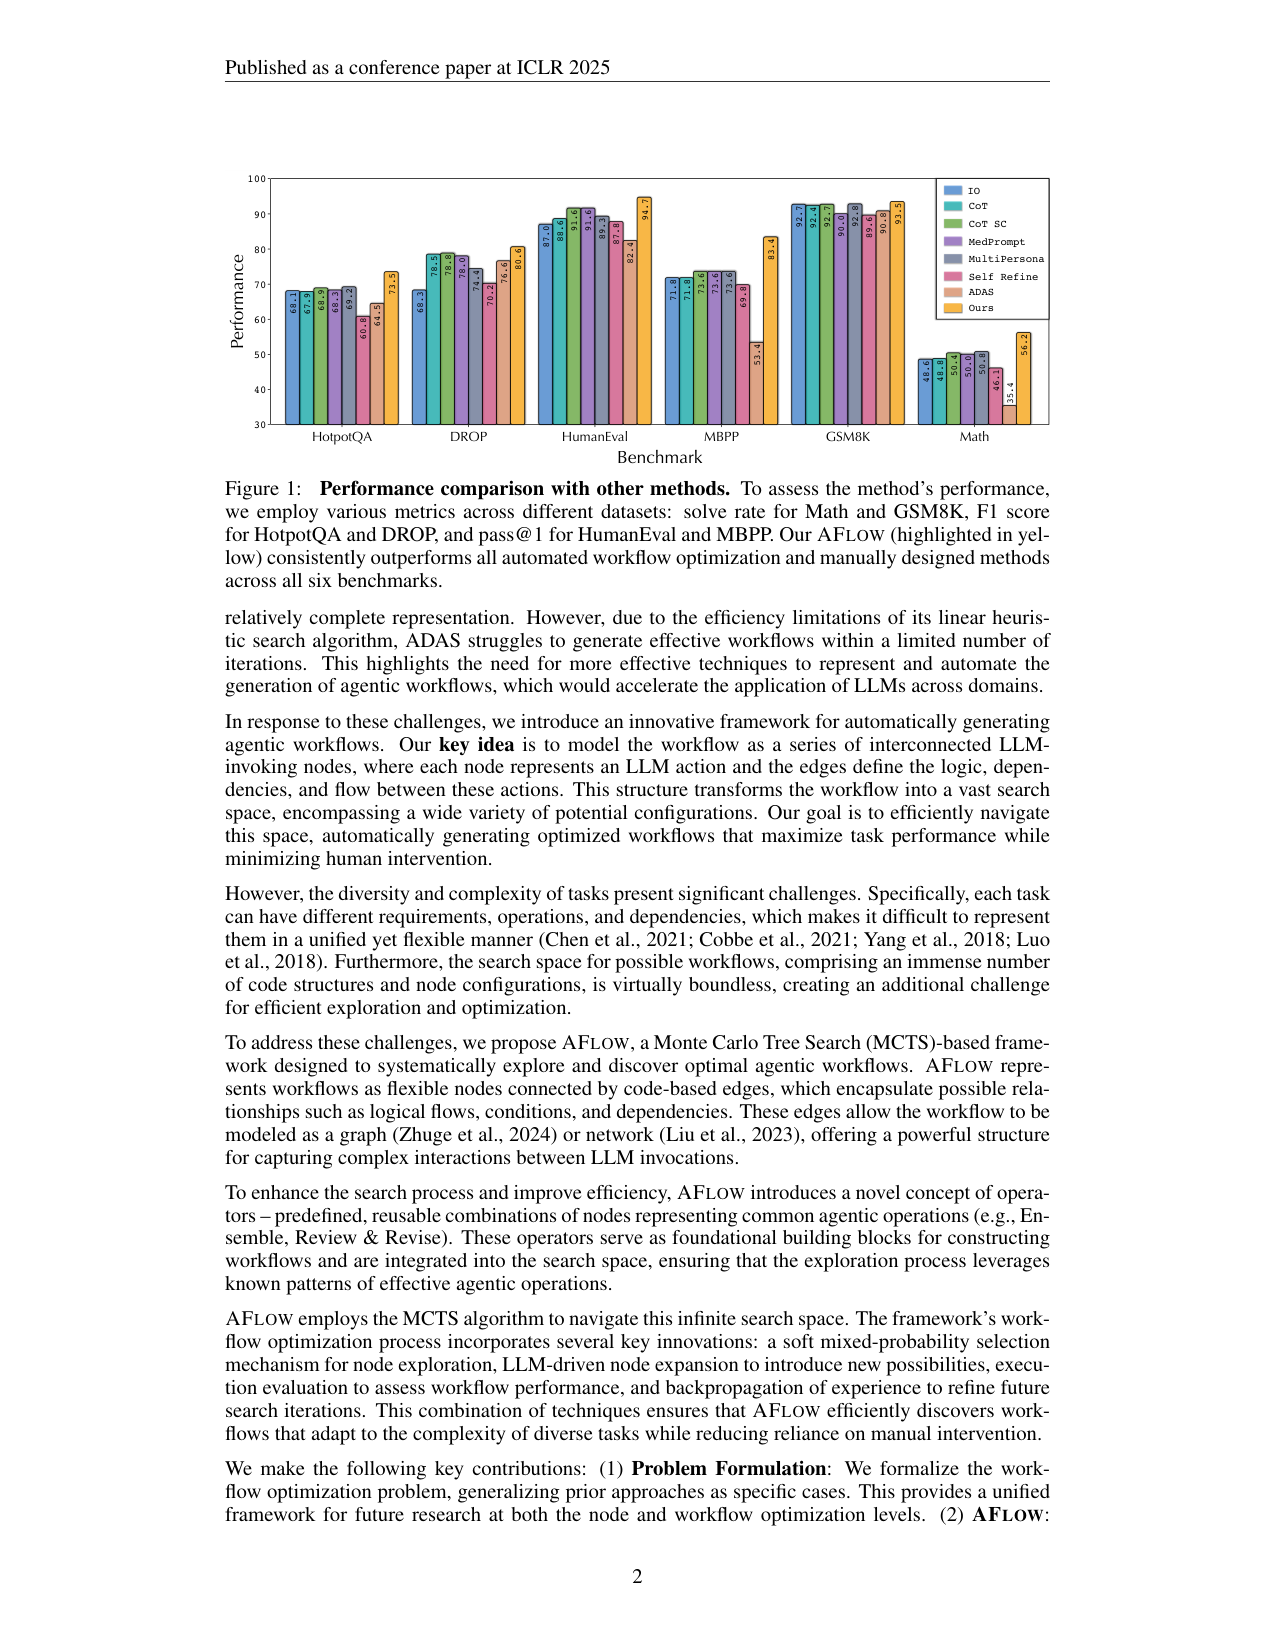
- 平均 80.3%,最佳手工 CoT-SC 76.0%(+5.7%),ADAS 67.2%(+19.5%)。
最戏剧性的是成本前沿(附录 D,HumanEval 划分集):DeepSeek 跑 AFlow 搜出的 workflow,93.9% pass@1,成本 $0.0291——约为 GPT-4o 直接推理(93.9%,$0.6371)的 4.55%。换个配置更狠:DeepSeek 跑自己搜的 workflow 94.66%(5.92% 的成本)、GPT-4o-mini 跑 AFlow workflow 94.7%(8.05% 的成本),都超过 GPT-4o 直接推理。弱模型 + 自动 workflow,打平并超过强模型。
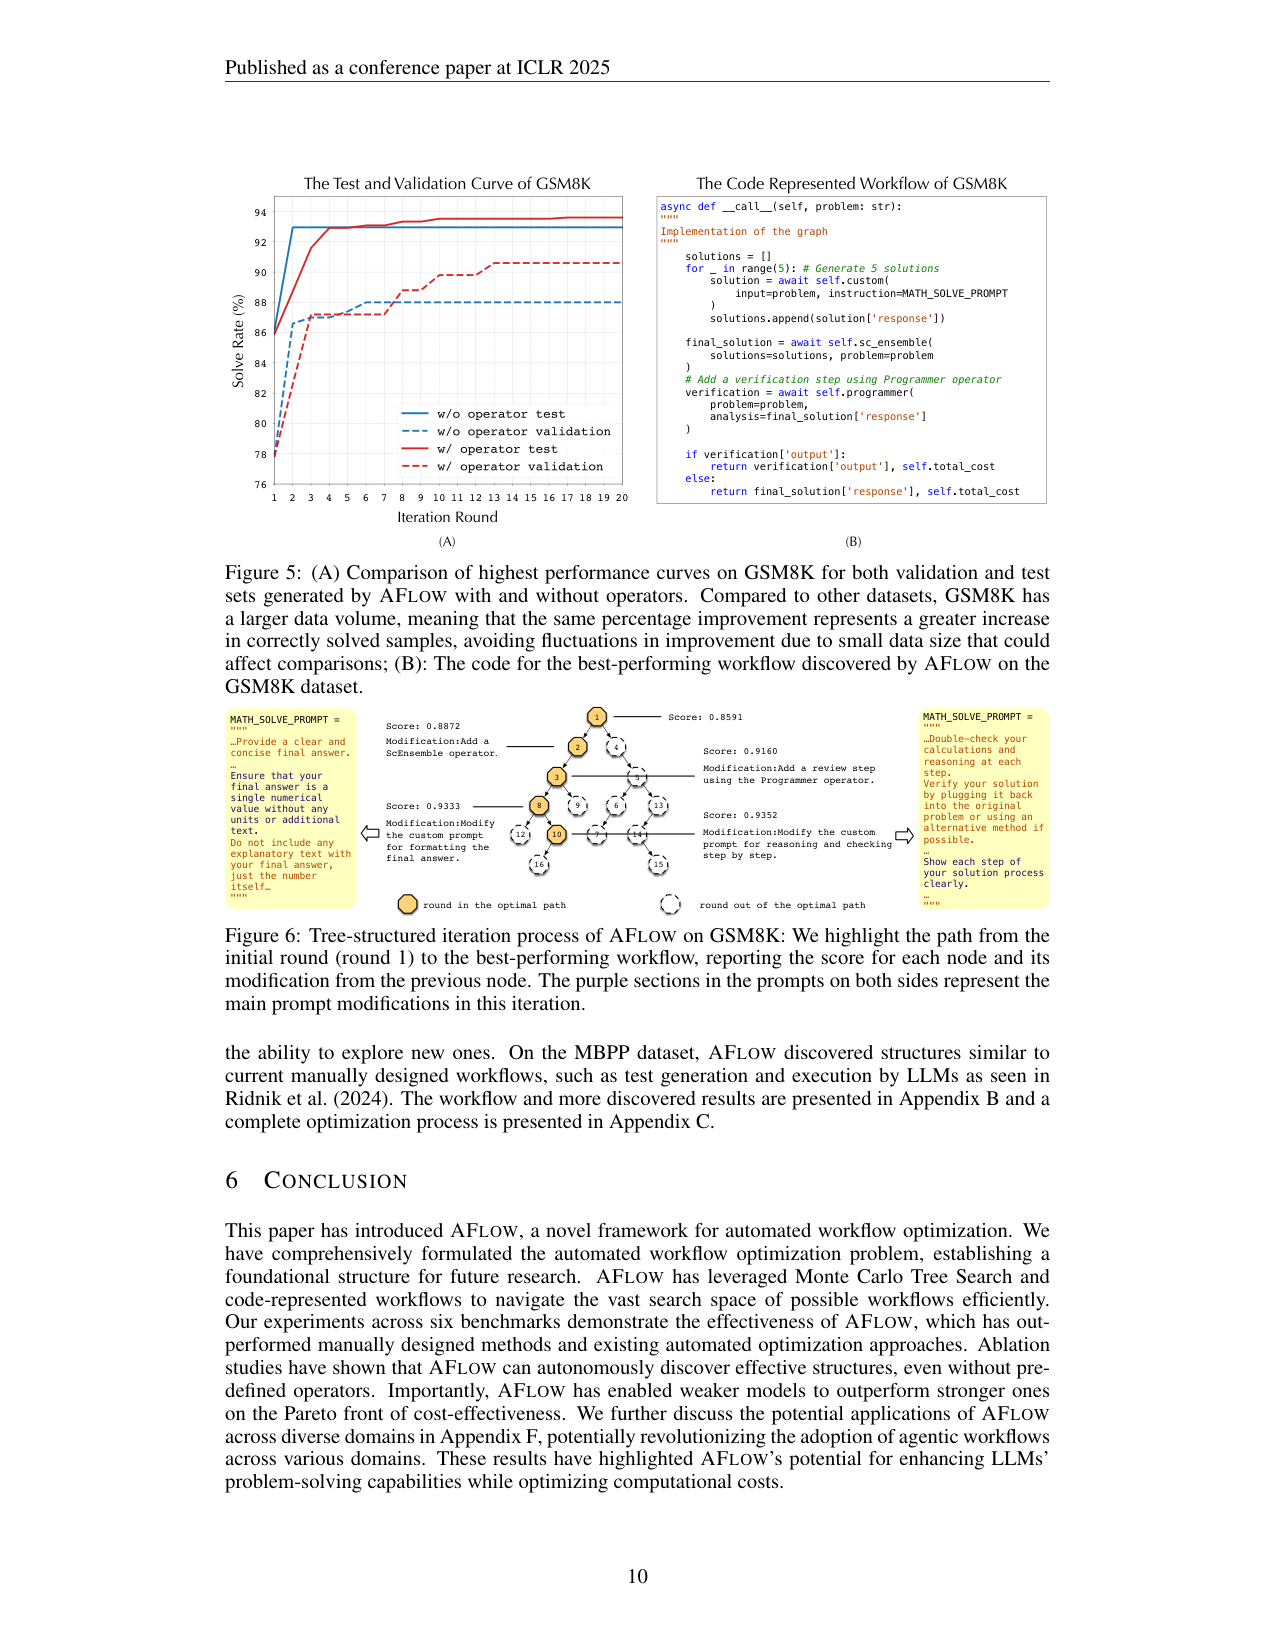
消融也干净:去掉 operator 集合,GSM8K 仍有 93.1%(超全部手工设计),AFlow 自主长出了 ensemble 结构——operator 是效率杠杆,不是能力前提(Fig.5)。跨模型迁移有个值得注意的发现:DeepSeek 搜出的 workflow 到 GPT-4o-mini 上只剩 90.8——最优 workflow 与执行模型绑定(Table 2)。
成本账再展开一点(附录 D 的完整表格):同一份 HumanEval 划分集上,GPT-4o-mini 直接推理 87.0%、$0.0223;GPT-4o 直接推理 93.9%、$0.6371;GPT-4o-mini 跑 AFlow 搜出的 workflow 94.7%、$0.0513。也就是说,自动化搜索把「最强结果」的成本门槛从美元级压到美分级——这是它相对手工 workflow 的另一层价值:人力成本被搜索算力替代,而搜索算力可以复用。
还有一点值得留意:AFlow 的收敛有明确轨迹可查——论文的 case study 展示了从空模板到最优 workflow 的逐轮修改,包括两次失败尝试为什么失败。这种可解释性来自单步修改约定:每轮只动一个地方,哪个改动带来提升、哪个改动带来回退,一清二楚。
局限:数值评估依赖、搜索成本、缩水空间
1. 评估必须数值化:solve rate / pass@1 / F1 之外的任务(对话质量、创意)无法直接搜索(§3.2 自承)。
2. 搜索成本未披露全貌:20 迭代 × 6 benchmark × 多执行器,每轮都要完整执行 workflow 评估,论文没给搜索阶段总成本。
3. 搜索空间被缩水:model / temperature / format 手工固定,这些参数本身可能才是最优解的一部分。
4. 优化器依赖强:Claude-3.5-sonnet 当 optimizer,没有做 optimizer 消融;换弱优化器效果未知。
5. benchmark 偏窄:QA/代码/数学六集,长 horizon agent 任务(多轮工具交互)没覆盖。
一句话记住这篇
AFlow 用 MCTS 把 workflow 生成变成树搜索:Soft Mixed 选择、LLM 单步扩展、执行评估、经验回填,20 迭代从空模板长出可用结构。最该记住的数字是:6 benchmark 平均 80.3%(超 ADAS 19.5%),DeepSeek+搜出的 workflow 以 GPT-4o 的 4.55% 成本达到同等 pass@1;最该记住的边界是——最优 workflow 与执行模型绑定,评估必须能数值化。
agentic workflow 用代码表示 + MCTS 优化(Soft Mixed 选择→LLM 扩展→执行评估→经验回填):6 个 benchmark 平均 80.3%(GPT-4o-mini 执行),超最佳手工方法 +5.7%、超 ADAS +19.5%;小模型+搜出的 workflow 以 GPT-4o 约 4.55% 的成本打平甚至超过它(HumanEval)。
问题
要解决什么:agentic workflow(LLM 调用节点 + 边)靠人设计,规模化与泛化受限;现有自动化方法要么要手工初始 setup(DSPy)、要么搜索空间表达不了条件/循环等结构(GPT-Swarm 的图、DyLAN 的网络)、要么搜索算法低效(ADAS 的线性启发式),AFLOW 要「从空白模板到可用 workflow 的端到端自动化」。
为什么 prior work 不够:Khattab et al. 需要手工 workflow 骨架再优化 prompt;GPT-Swarm 的图结构表达不了条件状态与并行;ADAS 用代码表示但把历史存线性列表、搜索效率差,限定迭代内产不出有效 workflow——问题在『表示能力』与『搜索算法』两头。
进化循环(搜索空间 → 算子 → 评估 → 选择)
搜索空间(什么被进化):workflow:code-represented edges(表达线性/条件/循环)+ node prompt;node 参数(model/temperature/format)固定以缩小空间;预定义 operator 集合(Generate / Format / Review&Revise / Ensemble / Test / Programmer / Custom)封装常见 agent 操作。
变异/提案算子:
- MCTS 四步:Soft Mixed Probability Selection(分数 + 均匀探索的软混合选择节点)
- LLM-Based Expansion(Claude-3.5-sonnet 作优化器,基于父节点评估性能生成修改版 workflow)
- Execution Evaluation(执行并算数值 fitness)
- Experience Backpropagation(树结构经验回填)
- 每轮单步修改:加一个 operator 或改一段 prompt
评估方式:数值评估函数 G:GSM8K/MATH(lv5) solve rate、HumanEval/MBPP pass@1、HotpotQA/DROP F1;HotpotQA/DROP 各 1000 样本、MATH 617 题(难度 5 的四类问题);执行器 DeepSeek-V2.5 / GPT-4o-mini / Claude-3.5-sonnet / GPT-4o,temperature 1 或 0,20 迭代。
选择与归档:树结构保留经验:只有提升的 workflow 在 N 轮预算内加回树,其余分支丢弃;top-k 平均分平台或预算耗尽停止;最终选最优 workflow 做测试集评估。无显式多样性控制——靠 soft-mix 探索与 MCTS 树回溯维持。
自我改进程度:L1 边缘:workflow 自动优化,但 optimizer(Claude-3.5-sonnet)、operator 集合、MCTS 规程、固定节点参数全部手工设计;模型权重固定。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|
输出
| 名称 | 类型 | 说明 |
|---|
数据集
| 数据 | 规模 | 备注 |
|---|
架构(摘要)
主干与结构
backbone:
参数:
类型:
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| 6 benchmark 平均 | 80.3% | 最佳手工 CoT SC 76.0%;自动化 ADAS 67.2% | Table 1(p8),全部用 GPT-4o-mini 执行、3 次取平均;相对手工 +5.7%、相对 ADAS +19.5% |
| MATH(lv5) / MBPP | 56.2 / 83.4 | ADAS 35.4 / 53.4(相对 +58.8% / +56.2%);手工 CoT SC 50.4 / 73.6 | Table 1(p8);617 题难度 5 数学、MBPP pass@1 |
| HumanEval / HotpotQA / DROP / GSM8K | 94.7 / 73.5 / 80.6 / 93.5 | HumanEval CoT 88.6;HotpotQA MultiPersona 69.2;DROP CoT SC 78.8;GSM8K CoT SC 92.7 | Table 1(p8);pass@1(HumanEval/MBPP)、F1(QA)、solve rate(数学) |
| 成本前沿(HumanEval 划分集) | DeepSeek 跑 AFLOW workflow:93.9% pass@1、成本 $0.0291,约为 GPT-4o IO($0.6371)的 4.55% | GPT-4o IO 93.9% @ $0.6371 | 附录 D(p28)+ Fig.4(p9);AFLOW(gpt-4o-mini) 搜出的 workflow 由 DeepSeek 执行;另:DeepSeek 跑 AFLOW(deepseek) 94.66% @ $0.0377(5.92%)、GPT-4o-mini 跑 AFLOW 94.7% @ $0.0513(8.05%)均超 GPT-4o IO |
| operator 消融(GSM8K) | 无 operator 仍 93.1%,超全部手工设计;有 operator 收敛更快 | 手工设计(IO/CoT/CoT SC/MedPrompt/MultiPersona/Self-Refine) | Fig.5(p10);无 operator 时 AFLOW 自主长出 ensemble 结构 |
| 跨模型迁移(HumanEval) | workflow 迁移到其它执行器多数超 baseline;但 DeepSeek 搜的 workflow 在 GPT-4o-mini 上弱于自搜(90.8 vs 94.7) | 各执行器的 IO/CoT 等手工方法 | Table 2(p9);不同模型需要不同 workflow——workflow 与模型配对而非通用 |
Insights
- 树结构经验优于线性 archive:ADAS 把历史存线性列表导致搜索低效;AFLOW 的 MCTS 树让每轮修改有父路径可回填,20 迭代超过 ADAS 30 迭代 19.5%(Fig.6 展示了逐轮单步修改路径)。
- 代码边 + operator 是效率杠杆:代码表达条件/循环,operator 把常见 agent 操作(Ensemble/Review/Test)打包成统一接口,减少搜索步数;去掉 operator 后模型仍能独立发现 ensemble 结构(Fig.5)。
- workflow 是模型相关的:DeepSeek 搜出的最优 workflow 到 GPT-4o-mini 上打折扣——搜索要绑定目标执行模型(Table 2)。
- 成本反转:弱模型 + 自动搜出的 workflow 能以强模型 4.55% 的成本达到同等 pass@1(附录 D),workflow 优化把对『贵的模型』的依赖下移。
vs 同类工作
- vs ADAS:同样代码表示,但 AFLOW 用 MCTS 树 + 执行反馈 + 单步修改,20 迭代内超过 ADAS 30 迭代的 19.5%(Table 1)。
- vs GPTSwarm:图结构表达不了条件状态;AFLOW 的代码边原生支持 if/else 与循环(Fig.3 右列代码示例)。
- vs DSPy/MIPROv2:仍需手工 workflow 骨架;AFLOW 从单节点空模板自动长结构(Fig.6)。
局限
- 评估函数必须数值化:只覆盖 solve rate / pass@1 / F1 类任务;开放式或模糊评估(对话质量、创意)无法直接搜索(§3.2 任务范围自承)。
- 搜索成本高:每轮修改要完整执行 workflow 评估,20 迭代 × 6 benchmark × 多执行器;论文未披露搜索阶段总成本表。
- 搜索空间被缩水:model / temperature / format 固定为手工设定,这些参数本身可能才是最优解的一部分。
- 优化器依赖强:Claude-3.5-sonnet 作 optimizer,换弱优化器效果未知;论文未做 optimizer 消融。
- benchmark 集偏窄:QA/代码/数学 6 个集,长 horizon agent 任务(多轮工具交互)未覆盖,迁移结论有限。
可复现性
- code:https://github.com/FoundationAgents/AFlow
- notes:优化器 Claude-3.5-sonnet;执行器 DeepSeek-V2.5(temperature 1)、GPT-4o-mini / Claude-3.5-sonnet / GPT-4o(temperature 0);20 迭代、ADAS 对照 30 迭代;成本按 token 用量核算(附录 D 给全表)。
AFlow 架构:MCTS 驱动的 workflow 进化循环
Mermaid 数据流
flowchart TD
    T0["根节点 W0\n(空模板:单 Node 无 prompt)"] --> SELECT["Soft Mixed Probability Selection\n(分数 + 均匀探索的软混合)"]
    SELECT --> EXP["LLM-Based Expansion\n(Claude-3.5-sonnet 优化器\n单步修改:加 operator / 改 prompt)"]
    EXP --> CAND["候选 Workflow W'\n(代码边 + prompt)"]
    CAND --> EVAL["Execution Evaluation\n(执行器跑任务,算数值 fitness)"]
    EVAL -->|"性能提升"| BACK["Experience Backpropagation\n(经验回填树,保留该分支)"]
    EVAL -->|"无提升"| DROP["丢弃分支"]
    BACK --> SELECT
    SELECT -->|"预算 N 轮 / top-k 平均分平台"| STOP["停止 → 最优 workflow 测试集评估"]
    OPS["Operator 集合\nGenerate / Format / Review&Revise /\nEnsemble / Test / Programmer / Custom"] --> EXP
    FIX["固定参数\nmodel / temperature / format"] --> CAND
组件详解
- 节点(Node):一次 LLM 调用,参数化 (M, P, τ, F)。搜索中 M/τ/F 固定,只有 prompt P 可编辑——这是刻意的空间收缩,把搜索预算集中到结构与指令上。
设计要点
1. 搜索即生成:workflow 从「单节点无 prompt 模板」起步,结构由搜索长出,无需手工骨架——这是与 DSPy 系方法的分水岭。
2. 效率来自树:树结构经验 + 单步修改 + 失败丢弃,20 迭代超过 ADAS(线性 archive)30 迭代 19.5%。
3. 模型相关的工作流:最优 workflow 绑定目标执行模型(DeepSeek 搜的到 GPT-4o-mini 上打折扣),搜索必须用目标模型做反馈。
4. 成本杠杆:弱执行器 + 优化后的 workflow 达到强模型同等精度,成本可低至 4.55%(附录 D)——把「贵模型」需求下移到「workflow 优化」。
AFLOW 框架:搜索空间 + MCTS 四步循环 + 搜索结果
原文 caption:Overall AFLOW framework: By setting a search space composed of nodes with only prompt parameters flexible, a given operator set, and a code representing edge, AFLOW performs an MCTS-based search within this space. Through a variant of MCTS designed for workflow optimization, AFLOW iteratively executes a cycle of Soft Mixed Probability Selection, LLM-Based Expansion, Execution Evaluation, and Experience Backpropagation.
展示机制全貌:左列搜索空间(node/operator/edge 的表示),中列 MCTS 四步循环(选择-扩展-评估-回填),右列产出三个域的 workflow(问答/数学/代码)。读法:看「Soft Mixed Probability Selection → LLM-Based Expansion → Execution Evaluation → Experience Backpropagation」的闭环。为什么重要:它把「workflow 生成」落实成树搜索——每轮单步修改、失败分支丢弃,是相对 ADAS 线性搜索的效率来源,站点封面。
6 个 benchmark 全面超越手工与自动化方法
原文 caption:Performance comparison with other methods. Our AFLOW consistently outperforms all automated workflow optimization and manually designed methods across all six benchmarks.
证明「全面领先」:HotpotQA 73.5 / DROP 80.6 / HumanEval 94.7 / MBPP 83.4 / GSM8K 93.5 / MATH 56.2,每栏都超过手工方法(CoT/CoT-SC/MedPrompt/MultiPersona/Self-Refine)与 ADAS。读法:看每个 benchmark 组里黄色柱的位置。为什么重要:它给出平均 80.3%(超最佳手工 5.7%、超 ADAS 19.5%)的逐项证据,是全文收益的浓缩。
GSM8K 收敛曲线 + 最优 workflow 代码
原文 caption:(A) Comparison of highest performance curves on GSM8K for both validation and test sets generated by AFLOW with and without operators; (B) The code for the best-performing workflow discovered by AFLOW on the GSM8K dataset.
证明「operator 提升搜索效率 + 无 operator 也能独立设计」:面板 A 显示有 operator 收敛更快,无 operator 仍达 93.1% 超手工设计;面板 B 展示发现的 workflow 代码——5 次生成 + SC-ensemble + Programmer 验证分支。读法:看曲线差距与代码里 ensemble/verification 结构的自组织。为什么重要:它说明 operator 是效率杠杆而非能力前提,workflow 结构可以由搜索独立长出。
用蒙特卡洛树搜索,把 agent 工作流「长」出来(对话版)
小播:今天聊一篇 ICLR 2025 的论文,讲 agent 工作流的自动生成。先说结论?
老播:这篇叫 AFlow。一句话:把工作流生成当成搜索问题,用蒙特卡洛树搜索来搜,从空白模板长出可用结构。六个基准平均 80.3%,超过最好的手工方法 5.7 个点,超过同类的 ADAS 19.5 个点。还有个更狠的数字:小模型配上搜出来的工作流,用 GPT-4o 大约 4.55% 的成本,就能打平甚至超过它。
小播:等等,工作流是什么?为什么要自动生成?
老播:工作流就是一系列 LLM 调用节点按顺序、按条件组合起来——比如先生成、再反思、再集成。现在这些全靠人设计。DSPy 要你先搭好骨架;GPT-Swarm 用图表示,表达不了「如果错了就换路」;ADAS 用代码表示,但搜索算法是线性的,效率不够。
表示:节点、算子、代码边
小播:AFlow 怎么表示工作流?
老播:三样东西。节点,就是一次 LLM 调用,有四个参数:模型、prompt、温度、输出格式。边,用代码表示执行顺序——代码天然支持 if-else 和循环,这是图结构给不了的。还有算子集合,把常见操作打包:生成、格式化、反思修正、集成、测试、程序员、自定义。
小播:为什么要把搜索空间缩小?
老播:因为全部参数一起搜太大了。AFlow 把模型、温度、输出格式固定,只让 prompt 和代码边可编辑——搜索预算集中在结构和指令上。加上算子,扩展动作就落在语义层面,而不是逐 token 变异。
MCTS 四步循环
小播:搜索具体怎么跑?
老播:四步。第一步,Soft Mixed 选择:按分数加一点均匀探索的软混合,选一个节点。第二步,LLM 扩展:优化器——这里用 Claude-3.5-sonnet——做单步修改,加一个算子或者改一段 prompt。第三步,执行评估:跑一遍,算数值分数。第四步,经验回填:把结果写回树里。
小播:单步修改?为什么不是大改?
老播:先记一个记忆锚点:每轮只动一处,哪个改动带来提升、哪个带来回退,一清二楚——可解释性是它和 ADAS 线性列表搜索拉开差距的关键。
老播:这是关键设计。每轮只动一处,成功路径保留、失败分支丢弃,搜索轨迹可解释。论文里有个 GSM8K 的迭代案例:第 2、3 轮加算子,第 8、10 轮改 prompt;第 5 轮加了个不合适的 review 节点,掉分了,被丢掉;第 14 轮过度关注「折扣」信息,也被丢掉。这就是树搜索和线性列表的差别——AFlow 是 20 轮迭代,ADAS 是 30 轮,AFlow 反而高出 19.5 个点。
数字:全面领先 + 成本打一折
小播:给硬数字。
老播:六个基准,全用 GPT-4o-mini 执行:平均 80.3%。逐项看:HotpotQA 73.5、DROP 80.6、HumanEval 94.7、MBPP 83.4、GSM8K 93.5、MATH 56.2。最难的题增益最大——MATH 上比 ADAS 高 58.8%,MBPP 高 56.2%。
小播:那个 4.55% 是怎么回事?
老播:在 HumanEval 上算成本账。GPT-4o 直接推理:93.9% 的 pass@1,成本 0.64 美元。换成 DeepSeek 执行 AFlow 搜出来的工作流:93.9%,成本 0.0291 美元——正好是 4.55%。换个配置更夸张:DeepSeek 跑自己搜的工作流 94.66%,GPT-4o-mini 跑 AFlow 工作流 94.7%,成本分别是 5.92% 和 8.05%,都超过 GPT-4o 直接推理。
小播:也就是说,弱模型加好的工作流,可以打平甚至超过强模型?
老播:对,记住这个记忆锚点:工作流优化把对「贵模型」的依赖下移了。但有个重要的前提——最优工作流和执行模型是绑定的。DeepSeek 搜出来的工作流拿到 GPT-4o-mini 上,从 94.7 掉到 90.8。所以搜索必须用目标模型做反馈。
消融:没有算子也能长出来
小播:算子是不是必须的?
老播:论文做了消融:把算子集合整个拿掉,AFlow 在 GSM8K 上仍然 93.1%,超过所有手工设计。它自己长出了 ensemble 结构——生成 5 个解、集成、再用程序员算子验证,验证不过就退回原答案。所以算子是效率杠杆,不是能力前提。
小播:这挺能说明搜索能力的。
老播:对。它证明了结构可以从搜索里独立长出来,人只提供了表示和搜索规程。
泼冷水:五个边界
小播:它有什么短板?
老播:五个。第一,评估必须数值化——对话质量、创意这种模糊任务没法直接搜。第二,搜索成本没披露全貌:20 轮乘 6 个基准乘多个执行器,每轮都要完整跑一遍工作流。第三,模型、温度、输出格式被手工固定了,这些参数本身可能才是最优解的一部分。第四,优化器必须是 Claude-3.5-sonnet 这个级别的模型,换弱的没验证过。第五,基准偏窄——只有问答、代码、数学,长 horizon 的多轮工具交互任务没覆盖。
收尾
小播:最后用一句话总结?
老播:AFlow 用蒙特卡洛树搜索把工作流生成变成搜索问题:Soft Mixed 选择、LLM 单步扩展、执行评估、经验回填,20 轮从空模板长出可用结构。最该记住的数字是:六个基准平均 80.3%,超 ADAS 19.5%;DeepSeek 加搜出的工作流用 GPT-4o 的 4.55% 成本达到同等水平。
小播:而最该记住的边界是:最优工作流与执行模型绑定,评估必须能数值化。
老播:没错。这篇和 ADAS 是同一拨想法,但它证明了「搜索算法」和「表示」一样重要——同样的代码空间,换 MCTS 就高出 19.5 个点。