MCE:连「怎么管上下文」这个机制,也交给进化
> 量子位技术拆解 · 先给分层直觉再给形式。完整结构化数据见「速查」tab。
先看一个现象:上下文工程(Context Engineering,CE)火起来以后,方法各带各的结构偏见。GEPA 追求 brevity,上下文固定压到 1–2K token,领域细节被丢掉;ACE 反向膨胀,条目化 playbook 五轮之后能长到约 80K token;Dynamic Cheatsheet 整体重写,长到一定程度就 collapse。为什么没有一种「刚好的长度」?MCE(Meta Context Engineering,arXiv 2601.21557)给出的回答是:因为「怎么组织上下文」这个机制本身是手工设计的,而手工设计必然带偏置。
它的解法是把 CE 拆成两层:meta 层进化「skill」——一份定义上下文如何表示与学习的可执行规格;base 层按 skill 把上下文当文件与代码优化。机制与内容分离,两层一起进化。
核心机制:双层优化 + agentic crossover
先给形式。设上下文函数 $c(x)$ 把查询 $x$ 映射到上下文,由静态组件 $\rho = \{\rho_1,\dots,\rho_m\}$(系统 prompt、知识库、代码库)与动态算子 $F = \{F_1,\dots,F_k\}$(检索、过滤、格式化、组合)组成:
$$c(x) = (F_k \circ \cdots \circ F_1)(x; \rho)$$
传统 CE 固定 $(\rho, F)$ 的结构,只优化里面的内容。MCE 引入 skill $s$——它决定 $(\rho, F)$ 该长什么样、该怎么从数据里学。于是优化变成双层:
$$s^{*} = \arg\max_{s \in \mathcal{S}}\, J_{\text{val}}(c_s^{*}) \quad\text{s.t.}\quad c_s^{*} = \arg\max_{c_s}\, J_{\text{train}}(c_s; s)$$
逐项看:内层在给定 skill 下找最优上下文函数(训练集上的 $J_{\text{train}}$);外层找那个让验证集性能 $J_{\text{val}}$ 最高的 skill。这类似把「模型架构与训练算法」和「学到的参数」分开,只不过发生在上下文层面。类比机器学习:参数是学出来的,架构和优化器是设计出来的;MCE 让「架构和优化器」也进化。
进化怎么跑?agentic crossover:meta agent 读技能历史库 $\mathcal{H}_{k-1} = \{(s_i, c_i, J_i^{\text{train}}, J_i^{\text{val}})\}$,选择性重组祖先 skill 目录里的组件,生成新 skill;base agent 在编码环境(Read/Write/Edit/Bash/Glob/Grep/TodoWrite)里执行它,把上下文函数写成文件与代码,带签名接口供程序化调用。外层用 (1+1)-ES 精英保留——每次只留优于当前最优的 skill。
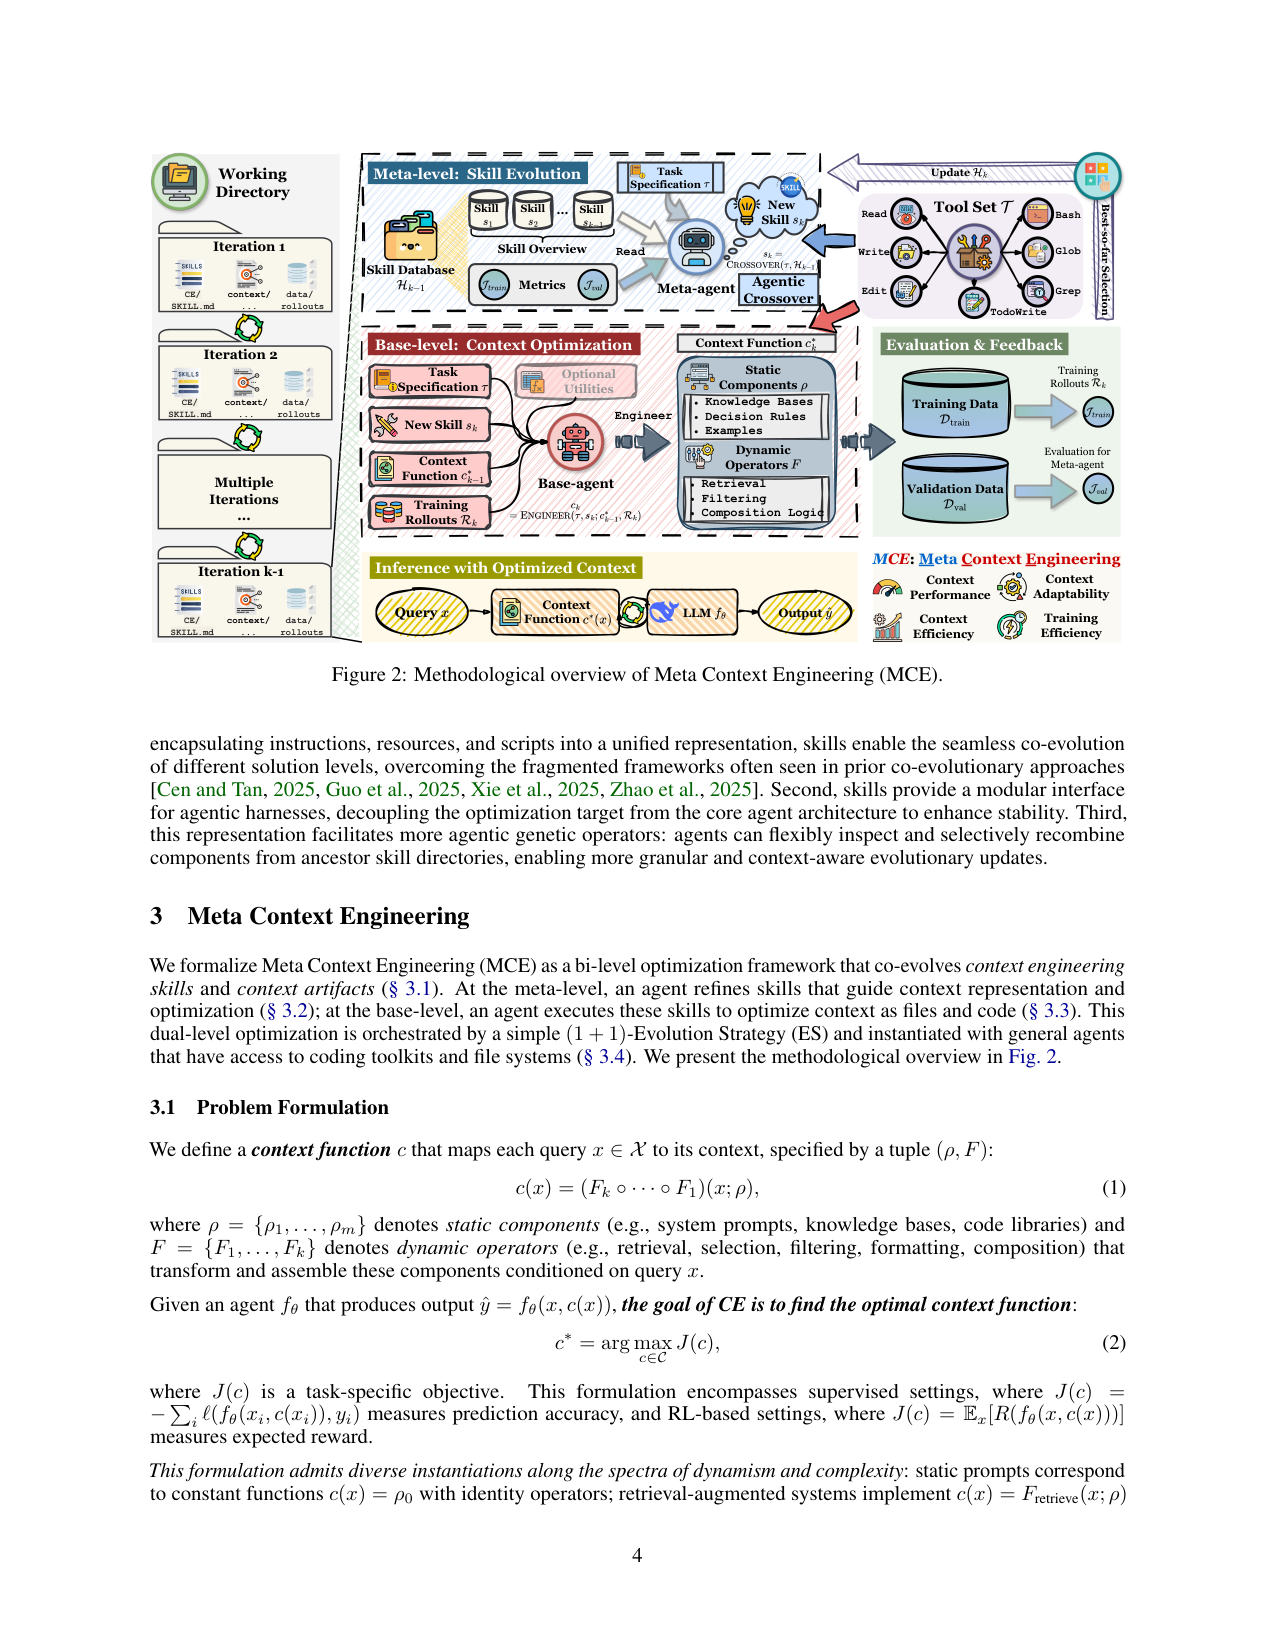
实现层面有个值得展开的细节:上下文函数被实例化成工作目录里的一堆文件——CE/SKILL.md 存 skill 指令,context/ 存静态组件与动态算子,data/ 存 rollout。base agent 用标准工具集(读、写、编辑、跑 bash、glob、grep、todo)在目录里施工,产出必须带预定义输入输出签名的可调用接口,接口在每次执行完会被校验。这套「文件即上下文」的约定让双层循环都跑在同一个编码环境里,也让「改上下文」变成一次普通的文件编辑——可版本化、可审计、可复用。
关键结果:平均 +16.9%,训练快 13.6×
评估覆盖五个域:FiNER(金融)、USPTO-50k(化学)、Symptom2Disease(医学)、LawBench(法律)、Aegis2.0(AI 安全),生成器 DeepSeek V3.1、agentic 模型 MiniMax M2.1:
- 相对 SOTA(ACE)平均 +16.9%,范围 5.6%–53.8%(abstract)。
消融与 confound 检验也很干净:去掉 meta 层 skill 进化,offline 从 75% 掉到 73%(仍超 ACE 的 71%);把 ACE 的 reflector/curator 换成 MiniMax M2.1,ACE 反而从 70% 退到 67%、playbook 膨胀到 114K token——说明 MCE 的增益来自方法本身,来自换更强的 agentic 模型。
局限:推理任务、长轨迹、成本
1. 推理密集任务未必更好:作者自承,需要细粒度 credit assignment 的长轨迹场景,现有的手工 harness(迭代试错+反思)可能更合适(§4.5)。
2. 强依赖 agentic 模型:meta/base agent 的编码与文件操作能力决定上限,作者预期随 agent 模型进步而缓解——但这意味着门槛不低。
3. 在线模式退化:skill 进化需要多 epoch,在线单遍处理只能用 base-only 模式,适应性打折(§4.2.4)。
4. 成本未完整披露:全 agentic 双层循环 + 编码工具调用的 token 消耗远大于传统 CE,论文没有完整成本表。
一句话记住这篇
MCE 把上下文工程从「优化上下文内容」升级为「优化管上下文的机制」:meta 层 agentic crossover 进化 skill,base 层把上下文当文件与代码优化,双层 (1+1)-ES 驱动。最该记住的数字是:相对 ACE 平均 +16.9%,FiNER 训练快 13.6×,上下文长度从 1.5K 到 86K 按任务自适应;最该记住的边界是——推理密集与长轨迹任务上,它可能比手工 harness 差。
机制与内容分离的双层上下文优化:meta 层用 agentic crossover 进化「怎么管上下文」的 skill,base 层按 skill 把上下文当文件与代码优化;五个域相对 SOTA agentic CE 方法平均 +16.9%(范围 5.6–53.8%),FiNER 训练比 ACE 快 13.6×,上下文长度按任务自适应(1.5K–86K token)。
问题
要解决什么:现有 Context Engineering(CE)方法被手工设计的 harness 绑住:ACE 用固定的生成-反思-策展 workflow 和预定义条目 schema,GEPA 倾向 brevity 压缩,DC 累积式改写会膨胀——结构偏差把上下文优化限制在窄小、凭直觉的设计空间里。MCE 要回答:连「怎么组织与学习上下文」的机制本身,能不能也变成优化对象。
为什么 prior work 不够:单一 agentic harness 没有普适最优:schema 化的条目列表带来结构刚性(ACE),全 LLM 重写带来 brevity bias(GEPA)与 context bloat(DC 到 80K token);这些方法把『表示/学习上下文的规程』当固定外设,只优化上下文内容本身。
进化循环(搜索空间 → 算子 → 评估 → 选择)
搜索空间(什么被进化):双层:meta 层进化 skill s(可执行规格:指令 + 脚本 + 资源,如 CE/SKILL.md 目录),它定义上下文如何表示与学习;base 层在给定 skill 下优化上下文函数 c=(ρ,F)——ρ 是静态组件(prompt/知识库/代码库),F 是动态算子(检索/过滤/组合)。两者以文件与代码形式存在、均可编辑;核心 agent 架构与工具集(Read/Write/Edit/Bash/Glob/Grep/TodoWrite)只读。
变异/提案算子:
- agentic crossover:meta agent 审视技能历史库(skill/执行/评估三元组 H),选择性重组祖先 skill 目录中的组件生成新 skill
- base-level engineer:agent 执行 skill s_k,从 rollout 反馈学习上下文函数 c_k
- (1+1)-ES 精英循环驱动双层交替优化
评估方式:内层 J_train:给定 skill 下最大化训练集上的上下文函数性能;外层 J_val:skill 在验证集上的表现。五域基准:FiNER(金融)、USPTO-50k(化学)、Symptom2Disease(医学)、LawBench criminal charge(法律)、Aegis2.0(AI 安全);DeepSeek V3.1 默认生成器、MiniMax M2.1 作 agentic 模型,经 OpenRouter 调用。
选择与归档:best-so-far 精英保留((1+1)-ES):每次迭代只保留优于当前最优的 skill;skill 数据库维护 (s_i, c_i, J_train, J_val) 历史供 crossover 参考;无显式种群多样性控制——多样性靠 agentic crossover 对历史的选择性重组维持。
自我改进程度:L1:生成器/reflector/agentic 模型固定,skill(管上下文的机制)与上下文内容协同进化;进化规程本身(crossover 操作、(1+1)-ES)仍是手工设计的。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|
输出
| 名称 | 类型 | 说明 |
|---|
数据集
| 数据 | 规模 | 备注 |
|---|
架构(摘要)
主干与结构
backbone:
参数:
类型:
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| 相对 SOTA agentic CE 方法的改进 | 平均 +16.9%(范围 5.6%–53.8%) | ACE(SOTA agentic CE 方法) | FiNER / USPTO-50k / Symptom2Disease / LawBench / Aegis2.0 五域,abstract + §4(p1/p10) |
| 相对 base 模型的平均增益(offline) | 89.1%(MCE) | ACE 70.7%(第二名) | 五个 benchmark 平均,DeepSeek-V3.1 作生成器,Table 1(§4.2.1,p7) |
| 相对 base 模型的平均增益(online) | 74.1%(MCE) | ACE 41.1% | 在线设置,单遍处理测试集(§4.2.1,p7) |
| 小模型迁移增益 | Gemma3-4B + MCE 上下文平均相对增益 172.6% | 无上下文 Gemma3-4B;对比 ACE 迁移 | Table 2(p8),FiNER/Symptom2Disease/LawBench 三域 |
| 训练耗时(FiNER,5 epoch) | 1.9 小时(13.6× 加速) | ACE 25.8 小时 | Fig.4(p9);MCE 的 batch-level 优化一次 rollout 处理一批样本 |
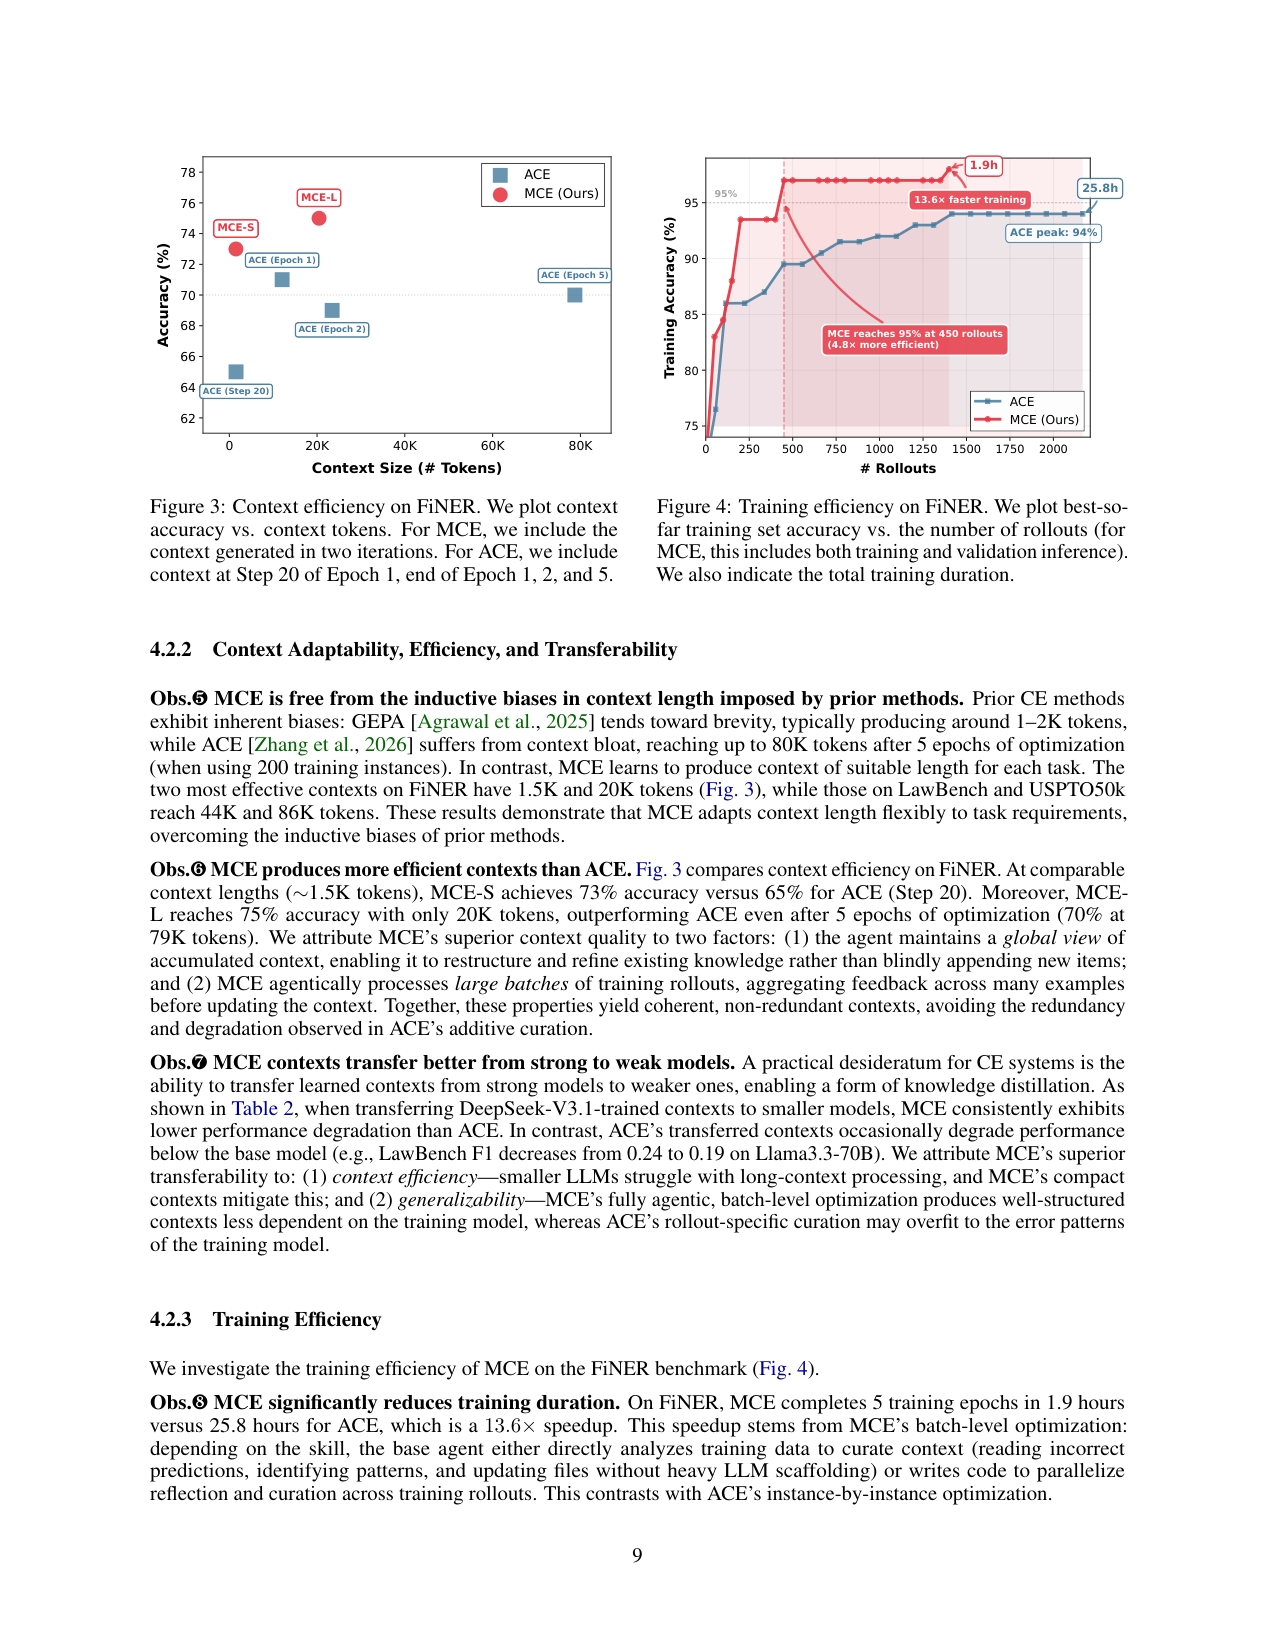
| 上下文长度自适应 | FiNER 最优上下文 1.5K / 20K token;LawBench 44K;USPTO-50k 86K | GEPA 固定约 1–2K;ACE 5 epoch 后膨胀至约 80K | Fig.3 + §4.2.2(p9);200 个训练实例的设置下(§4.2.2 上下文) |
| 消融:meta 层 skill 进化的贡献 | 完整 MCE 75% vs 无 skill 变体 73%(offline) | 无 skill 的 base-agent 单独跑(也超 ACE 的 71%) | §4.2.4(p8);online 单遍处理无法迭代 skill,所以 skill 进化只在 offline 生效 |
| 模型 confound 排除 | 把 ACE 的 reflector/curator 换成 MiniMax M2.1 反而退化:67% vs 70%,playbook 114K vs 79K token | ACE 默认 DeepSeek V3.1 配置 | Table 4(p8)——MCE 的增益来自方法而非更贵的 agentic 模型 |
Insights
- 机制与内容分离:上下文函数 c=(ρ,F) 解决『上下文里有什么』,skill 解决『怎么表示与学习它』;公式 (3) 的双层 argmax 把前者当内层、后者当外层——这是相对 ACE 的范式差(§3.1)。
- 上下文 = 文件 + 代码:Turing-complete 表示比预设 schema 更通用,且编码可验证;base agent 只需实现带签名接口即可程序化调用(§3.4)。
- 长度无偏是可见收益:GEPA 压到 1–2K、ACE 涨到 80K 都是结构偏置,MCE 学会按任务定长度(1.5K~86K),这对小模型迁移尤其重要(§4.2.2)。
- 13.6× 训练加速来自 batch-level 优化:一次 rollout 处理一批样本,替代 ACE 的逐样本更新循环(Fig.4)。
vs 同类工作
- vs ACE:ACE 的三角色 workflow 与条目 schema 是手工固定;MCE 把『怎么组织上下文』的机制本身进化掉,且上下文表示从条目列表换成文件/代码。
- vs GEPA:GEPA 只优化 prompt 文本并倾向 brevity;MCE 优化完整上下文函数(静态组件 + 动态算子),长度由任务决定。
- vs 一般 LLM-EC:此前进化对象是 prompt/程序/启发式/奖励函数;MCE 首次把『agent skill』(指令+脚本+资源的目录)作为进化抽象,支持跨组件粒度重组。
局限
- 推理密集任务未必有优势:作者自承对需要细粒度 credit assignment 的长轨迹/推理类任务,batch-level 全 agentic CE 可能失效——现有手工 harness(迭代试错+反思)反而更合适(§4.5 Limitations)。
- 强依赖 agentic 模型能力:meta/base agent 的编码与文件操作能力决定效果;作者预期随 agent 模型进步而缓解,但这意味着门槛不低。
- 数据与计算受限:实验用数据子集(预算原因);skill 进化只在 offline 多 epoch 设置下生效,在线单遍处理退化为 base-only 模式(§4.2.4)。
- 训练成本未完整披露:全 agentic 双层循环 + 编码工具调用的 token 消耗远大于传统 CE,论文没有给出完整成本表,工程落地门槛被低估。
- 评估仍依赖 GT/验证集信号:对更开放任务(无验证器)的 reward hacking 与上下文污染问题未讨论。
可复现性
- code:https://github.com/metaevo-ai/meta-context-engineering
- notes:Claude Agent SDK 实例化 MCE agent;DeepSeek V3.1 / MiniMax M2.1 经 OpenRouter 调用;上下文接口定义为一发检索函数 query→context,与 ACE 基线保持一致(§4.1)。
MCE 架构:双层进化循环数据流
Mermaid 数据流
flowchart TD
    subgraph META["Meta 层:skill 进化"]
        SK["Skill Database\n{(s_i, c_i, J_train_i, J_val_i)}"]
        MO["Meta-agent\n(读历史 + 评估指标)"]
        XO["Agentic Crossover\n(选择性重组祖先 skill 组件)"]
        NS["新 Skill\n(CE/SKILL.md 指令 + 脚本 + 资源)"]
        SK --> MO --> XO --> NS
    end

    subgraph BASE["Base 层:上下文优化"]
        BA["Base-agent Engineer\n(编码工具集:Read/Write/Edit/\nBash/Glob/Grep/TodoWrite)"]
        CF["Context Function\n(文件 + 代码:\n静态组件 ρ + 动态算子 F)"]
        RO["Training Rollouts\n(按批次执行 + 反馈)"]
        BA --> CF --> RO --> BA
    end

    NS -->|"执行 skill"| BA
    RO -->|"评估 J_train / J_val"| MO
    CF -->|"最优上下文 c*"| INF["Inference with Optimized Context"]
    RO --> SK
组件详解
- Meta-agent(元层优化器):读取技能历史库(每个 skill 附带的上下文函数与训练/验证指标),决定如何把祖先 skill 中「各自成功」的部分交叉重组。交叉粒度是 skill 目录组件级,比整份文本变异更精细、更有上下文意识。
设计要点
1. 机制与内容分离:skill 是「怎么学/怎么表示」,上下文是「学到的结果」;分离让上层机制可跨任务迁移。
2. 上下文代码化:Turing-complete 表示 + 可验证接口,比条目 schema 通用;编码能力是 LLM 的强项,搜索效率高。
3. 长度自适应:没有预设上下文长度偏置(对比 GEPA 1–2K、ACE 80K),长度由任务数据决定——这直接带来小模型迁移收益(Gemma3-4B 相对 +172.6%)。
4. batch-level 训练:一次 rollout 处理一批样本,替代逐样本更新,是 13.6× 训练加速的结构性来源。
5. 只读边界:核心 agent 架构与工具集固定,两个 agent 的读写权限按角色与迭代严格限定——进化的是 skill 与上下文,系统骨架不进化。
MCE 双层框架:meta 层 skill 进化 + base 层上下文优化
原文 caption:Methodological overview of Meta Context Engineering (MCE).
展示机制:meta 层读 skill 数据库与评估指标、经 agentic crossover 生成新 skill;base 层按 skill 在编码环境中把上下文函数当文件/代码工程化,训练 rollout 与验证反馈闭环。读法:看上下两条回路如何通过 skill 与上下文函数交接。为什么重要:它把「机制与内容分离」落到具体数据流——上层进化怎么管,下层进化管什么,是全文架构的核心证据。
MCE 概念总览:magic formula 与双层循环
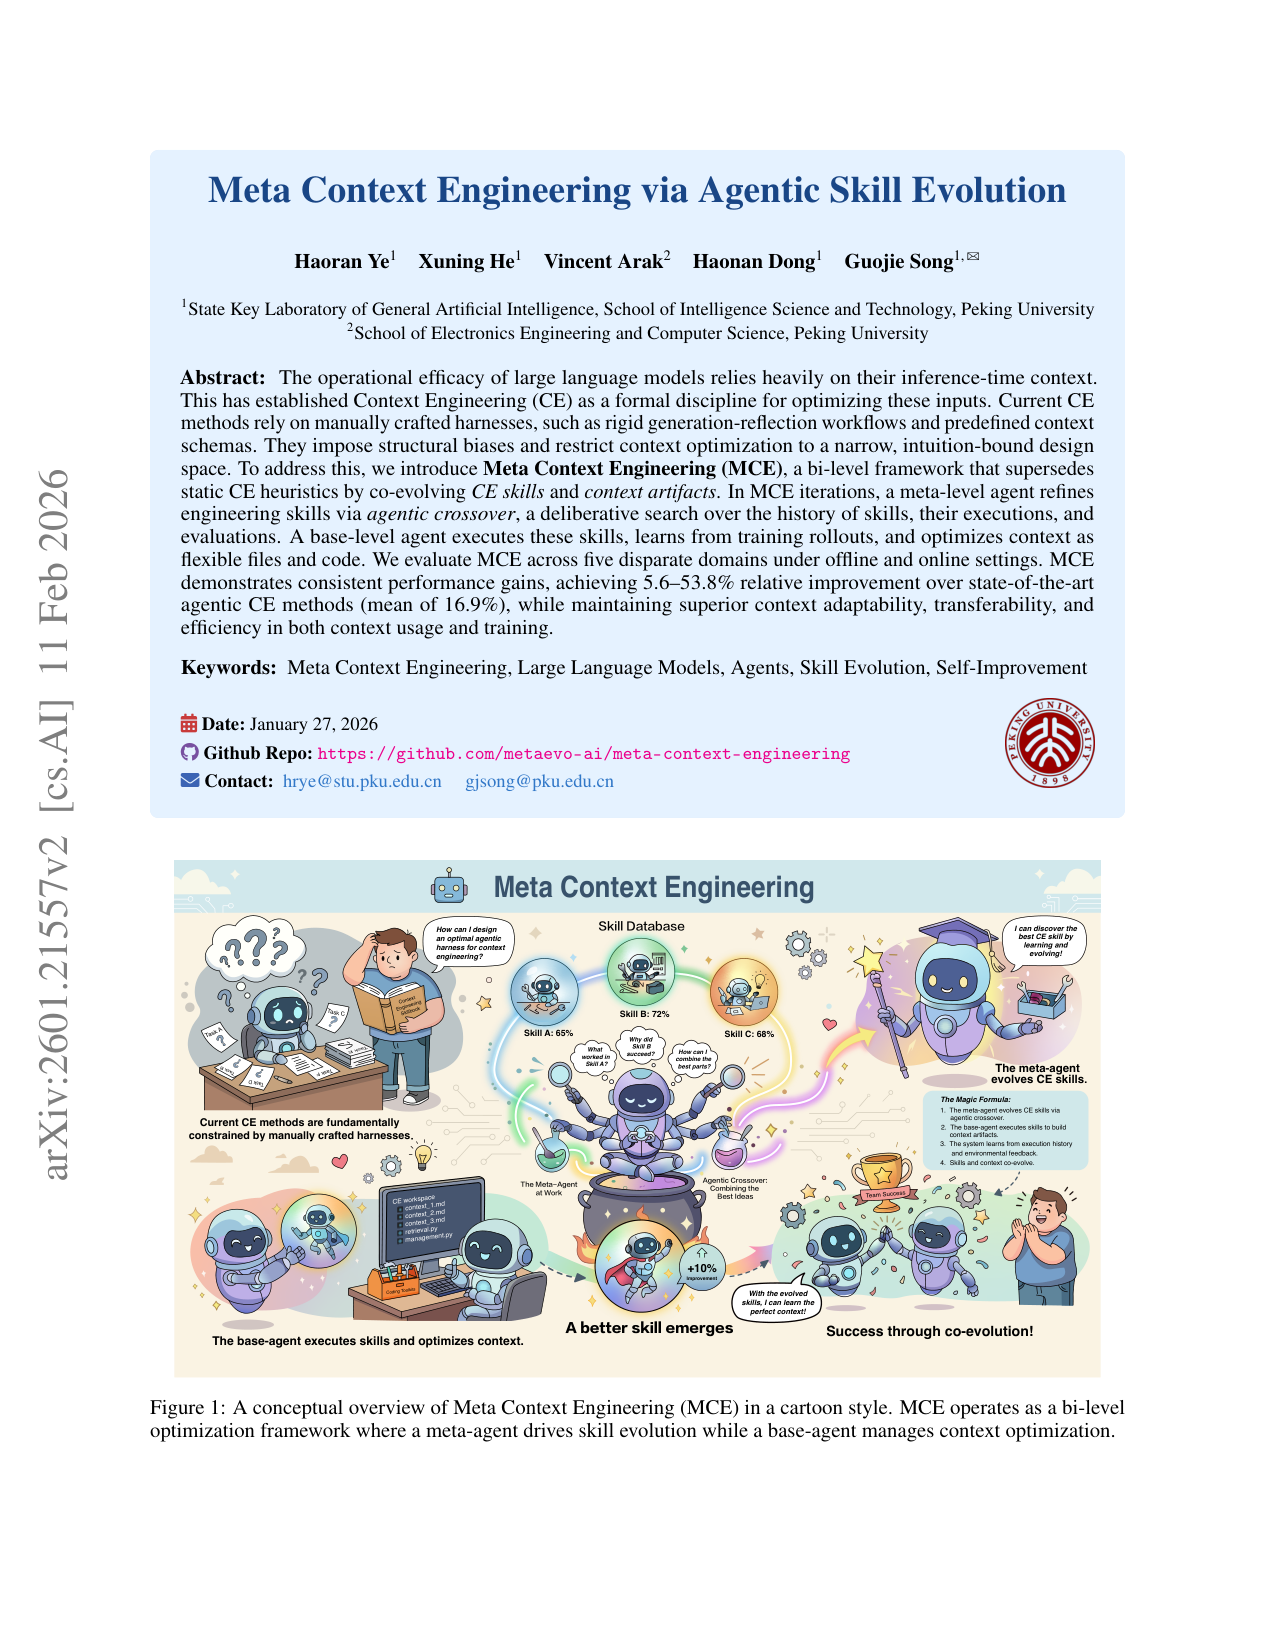
原文 caption:A conceptual overview of Meta Context Engineering (MCE) in a cartoon style. MCE operates as a bi-level optimization framework where a meta-agent drives skill evolution while a base-agent manages context optimization.
用示意图讲清四步:meta agent 经 agentic crossover 进化 skill、base agent 执行 skill 构建上下文工件、系统从执行历史与环境反馈学习、skill 与上下文协同进化。读法:看右侧 skill 数据库(Skill A 65% / B 72% / C 68%)与「怎么把最好部分组合起来」的提问。为什么重要:它给出「+10% 改进」的直觉来源——把已有 skill 里各自成功的部分交叉出新 skill。
上下文效率:MCE 按任务学长度,避开 brevity 与 bloat 两个偏置
原文 caption:Context efficiency on FiNER. We plot context accuracy vs. context tokens. For MCE, we include the context generated in two iterations. For ACE, we include context at Step 20 of Epoch 1, end of Epoch 1, 2, and 5.
证明「长度无偏」:GEPA 固定在约 1–2K token(brevity bias),ACE 膨胀到约 80K token(bloat),MCE 的两个最优上下文落在 1.5K 与 20K——按任务特性选择。读法:看散点的 token 分布与对应准确率。为什么重要:它把「结构偏差」量化成可见的上下文长度轨迹,是 MCE 相对前作的核心差异证据。
连「怎么给模型写上下文」这件事,也让模型自己进化(对话版)
小播:今天聊一篇北大团队的论文,讲上下文工程的升级版。先说结论?
老播:这篇叫 MCE,Meta Context Engineering。一句话:以前的方法优化的是「上下文里有什么」,这篇把「怎么组织上下文」这个机制本身也拿来进化。在五个领域上,相对当前最强的 ACE 平均提升了 16.9%,训练还快了 13.6 倍。
小播:等一下,「怎么组织上下文」不是人设计的吗?这也能量化优化?
老播:这就是它的核心主张:人设计的机制都带偏置。我们从头讲。
问题:每个方法的上下文都有「出厂偏置」
小播:什么偏置?
老播:GEPA 追求简洁,上下文固定压到 1 到 2K token,领域细节全丢——这是 brevity bias。ACE 反过来,条目化 playbook 越养越大,五轮训练后能到 8 万 token——这是 context bloat。Dynamic Cheatsheet 整体重写,长到一定程度直接坍缩。
小播:那「刚好的长度」谁来定?
老播:MCE 说:让机制自己学。它把问题拆成两层——meta 层进化一个叫 skill 的东西,skill 是一份可执行的规格,定义上下文该怎么表示、怎么从数据里学;base 层按这个 skill,把上下文当成文件和代码来优化。
小播:那和 ACE 有什么区别?ACE 不也是内容在进化吗?
老播:区别在这:ACE 的三角色分工、条目结构、更新规则全是人写的,内容在进化、机制是死的。MCE 连机制一起进化。它有个很干净的类比:机器学习里,参数是学出来的,架构和优化器是设计出来的;MCE 让「架构和优化器」也变成学出来的。
机制:双层优化加 agentic crossover
小播:具体怎么跑?
老播:先给公式。上下文函数 c 由两部分组成:静态组件 rho,就是系统提示、知识库、代码库;动态算子 F,就是检索、过滤、格式化这些操作。写成 c(x) 等于 Fk 复合到 F1 再作用在 x 上,参数是 rho。
小播:这个公式 ACE 也有吧?
老播:有,但 ACE 优化的是 rho 和 F 的内容,结构固定。MCE 多了一层:skill s 决定 rho 和 F 该长什么样。于是变成双层优化——内层在给定 skill 下,找训练集上最好的上下文函数;外层找那个让验证集表现最好的 skill。两个 argmax 叠在一起,就是论文的核心公式。
小播:那「进化」怎么实现?
老播:关键算子叫 agentic crossover。meta agent 先读技能历史库——每个 skill、它产出的上下文、它的训练和验证分数——然后像遗传算法交叉一样,把祖先 skill 里各自成功的组件重新组合成新 skill。base agent 在一个编码环境里执行它,用读文件、写文件、跑 bash 这些工具,把上下文函数真的写成代码。外层用一个最简的 (1+1) 精英策略:每次只留比当前最好的更好的那个。
小播:所以是让 agent 自己决定怎么交叉?
老播:对,记住这个记忆锚点:交叉先看历史再选择性重组,把搜索策略的复杂度交给 agent 本身。
数字:全面领先
小播:数字呢?
老播:五个领域,金融、化学、医学、法律、AI 安全。相对 ACE 平均提升 16.9%,范围从 5.6% 到 53.8%。离线设置下相对基座模型的增益是 89.1%,ACE 是 70.7%;在线设置 74.1% 对 41.1%。
小播:有没有更直观的?
老播:先记一个记忆锚点:batch-level 优化——一次 rollout 处理一批样本,这是它比逐样本更新的 ACE 快一个数量级的结构性原因,后面那个 13.6 倍就来自这里。
老播:小模型收益最大。Gemma3-4B 挂上 MCE 学出的上下文,平均相对增益 172.6%。还有一个特别能说明问题的:FiNER 上训 5 轮,MCE 用 1.9 小时,ACE 要 25.8 小时——13.6 倍加速。原因也简单:MCE 一次 rollout 处理一批样本,ACE 是一个样本一个样本地更新。
小播:那上下文长度呢?不是说要有偏置吗?
老播:MCE 学出来的长度是 1.5K 到 86K 不等,按任务定。GEPA 永远 1 到 2K,ACE 五轮后固定 8 万。这就能看出偏置没了。
排除干扰:不是模型更强的功劳
小播:它用的 agentic 模型是 MiniMax M2.1,会不会是模型更强?
老播:作者专门做了这个对照:把 ACE 的反思器和策展器也换成 MiniMax M2.1,结果 ACE 反而从 70% 退到 67%,playbook 还膨胀到 11 万 4 千 token。这说明增益来自 MCE 的方法本身。
小播:那消融呢?
老播:把 meta 层的 skill 进化拿掉,MCE 从 75% 掉到 73%,但仍然超过 ACE 的 71%。也就是说 base 层单独跑也够强,skill 进化是锦上添花,但确实是实打实的提升。
泼冷水:哪些场景它不行
小播:它有什么短板?
老播:作者自己承认三点。第一,推理密集的任务它未必更好——那种需要一步一反思、细粒度归因的长轨迹任务,现有手工 harness 反而合适。第二,它强依赖 agentic 模型的能力,编码和文件操作不行,效果就缩水。第三,skill 进化需要多轮训练,在线单遍处理只能用底层模式,适应性打折。
小播:还有隐藏成本吗?
老播:有,而且论文没给完整账本:双层全 agentic 循环加编码工具调用,token 消耗远大于传统方法。另外评估还是靠标准答案和验证集信号,更开放的任务上 reward hacking 和上下文污染的问题,论文没有讨论。
收尾
小播:最后用一句话总结?
老播:MCE 把上下文工程从「优化上下文内容」升级为「优化管上下文的机制」:meta 层用 agentic crossover 进化 skill,base 层把上下文当文件和代码优化,双层精英循环驱动。最该记住的数字是:相对 ACE 平均 +16.9%,训练快 13.6 倍,上下文长度 1.5K 到 86K 按任务自适应。
小播:而最该记住的边界是:推理密集和长轨迹任务上,它可能比手工 harness 差。
老播:没错。这篇把「机制也进化」这条路走通了一半,读它之前先记住那句类比:参数是学出来的,架构和优化器现在也可以是学出来的。