「会写 harness 更新」和「能从更新获益」是两回事
> 量子位技术拆解 · 一篇能力分析论文:7 个模型 × 3 个 benchmark 的交叉配对。完整结构化数据见「速查」tab。
先看一个现象:自进化 agent 的评测几乎都报「端到端增益」——用一套更新程序 + 一个目标 agent,在某个 benchmark 上提升了多少。但增益可能来自两个完全不同的地方:evolver 写出的 harness 质量,或者执行 agent 使用 harness 的能力。PSU、UCSC 与 Amazon 的这篇论文(arXiv 2605.30621)把这个混在一起的分数拆开,定义了两个独立能力轴,并用 7 个模型 × 3 个 benchmark 的交叉配对回答:哪些模型能产出有用的 harness 更新?哪些模型真正从中获益?
核心思想:两个能力轴
设 agent 在时间 $t$ 的状态为 $A_t = (f, H_t)$,$f$ 是固定权重,$H_t$ 是 harness 状态。evolver $e$ 把执行证据转成更新:$\Delta H_t = e(H_{t-1}, D_t)$,其中 $D_t = \{(x, \tau_{t,x}, y_{t,x})\}$ 是轨迹与输出。pair 增益是 $\Delta(f, e) = J_X(f, H_T^{(f,e)}) - M_{\text{base}}(f)$,即进化后的分数减去该 agent 的基座能力。两个能力轴的定义:
$$\Delta_{\text{update}}(e) = \frac{1}{|F^\star|} \sum_{f \in F^\star} \Delta(f, e), \qquad \Delta_{\text{benefit}}(f) = \max_{e \in E^\star} \Delta(f, e)$$
$\Delta_{\text{update}}$ 是 evolver 在一组 anchor agent 上的平均增益三个指标都以 pass rate 为统一口径、跨 benchmark 可比;anchor 集合的选取(谁当执行者、谁当改壳者)是度量定义的组成部分,读数字时要带上这个限定。——衡量「它写的更新对别人有没有用」;$\Delta_{\text{benefit}}$ 是 agent 在 anchor evolver 集合上能获得的最大增益——衡量「它吃到多少进化红利」。实验里 6 个模型两两配对(再加最小的 Qwen3.5-9B 只当 evolver),在 SWE-bench Verified、MCP-Atlas、SkillsBench 三个 benchmark 上跑,可编辑组件是 skills(SWE/SkillsBench)与 skills+prompts+memories(MCP)。
发现一:harness-updating 与基座能力无关
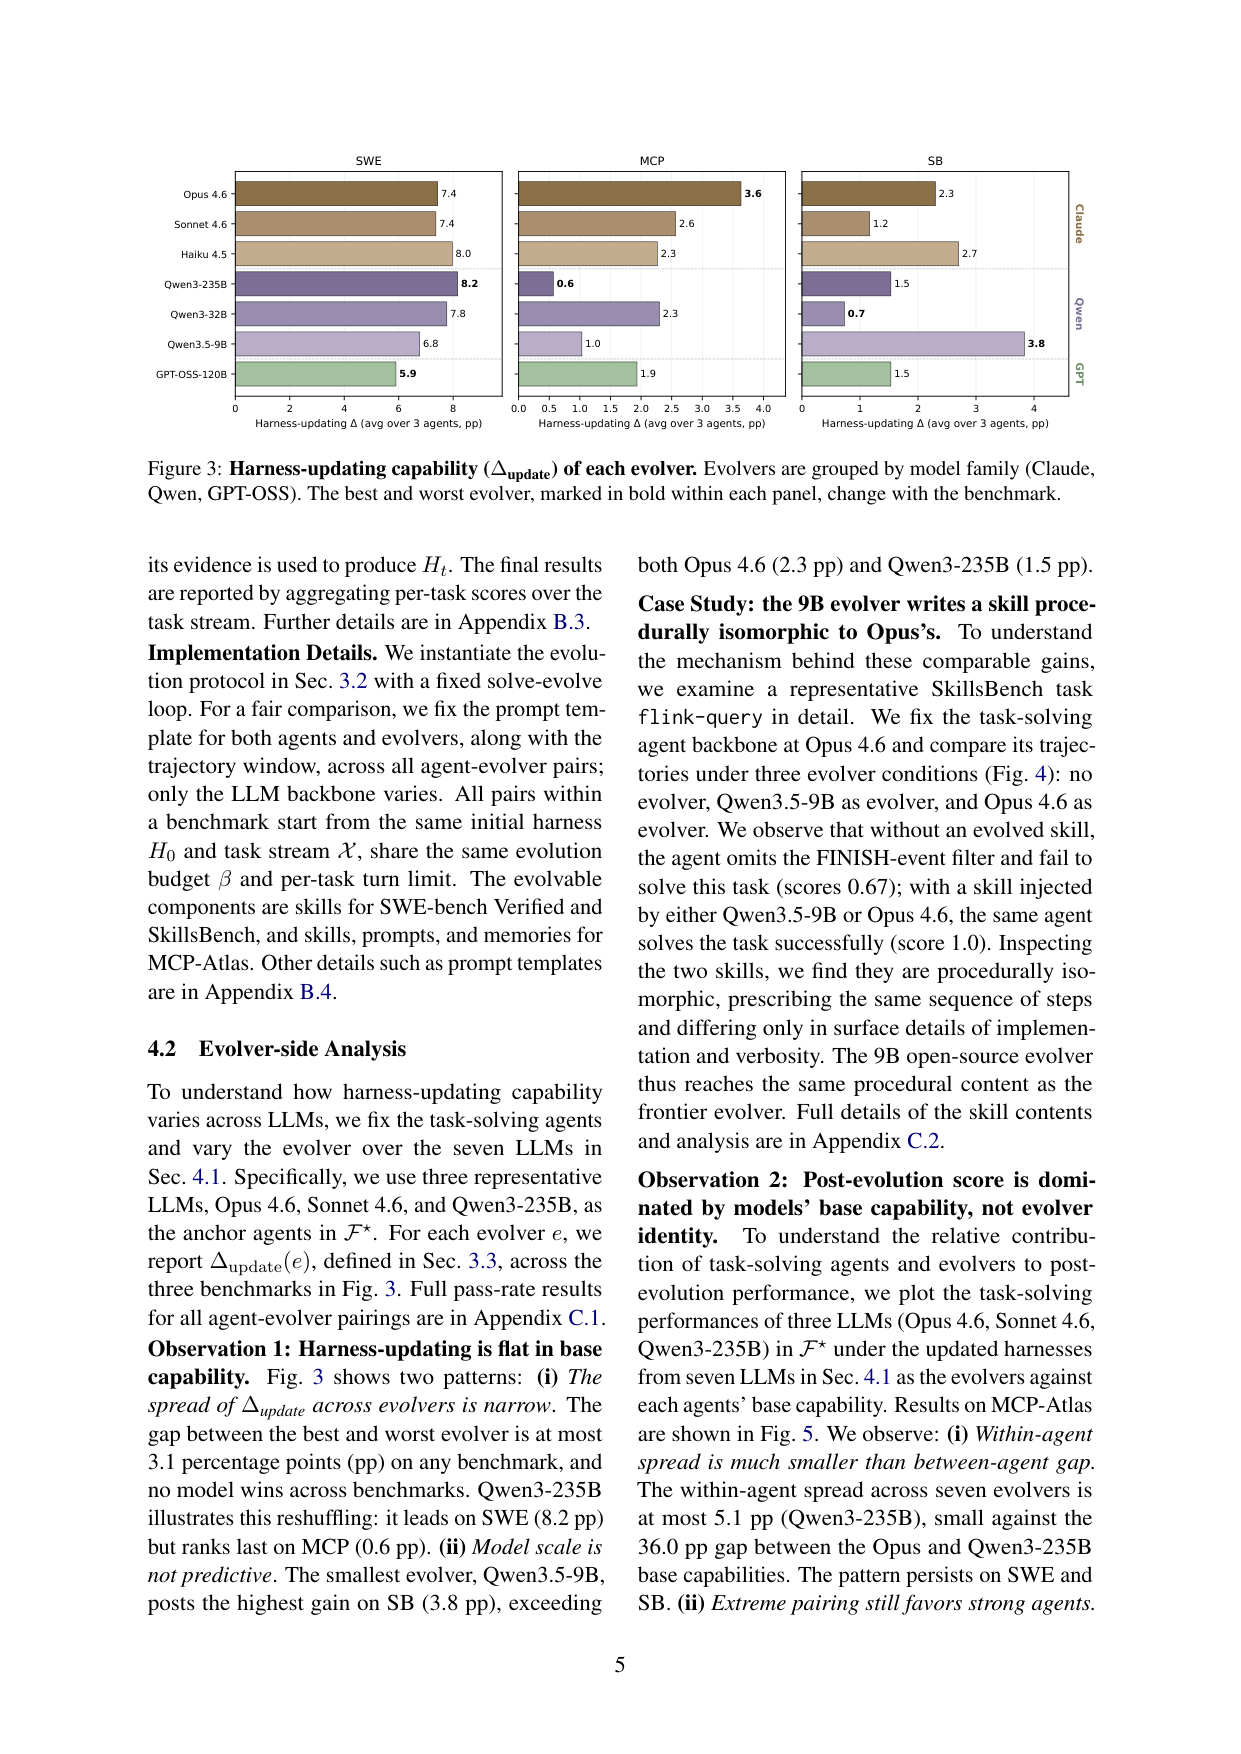
最反直觉的结果:evolver 写 harness 的能力随模型规模几乎平坦。同一 benchmark 上最好与最差 evolver 的 $\Delta_{\text{update}}$ 差距最多 3.1 个百分点,而且没有模型在所有 benchmark 上领先——Qwen3-235B 在 SWE 上 8.2pp 领先、在 MCP 上 0.6pp 垫底。最小最弱的 Qwen3.5-9B 在 SkillsBench 上 3.8pp 全场最高,超过 Claude Opus 4.6 的 2.3pp。论文用 flink-query 案例做了机制层面的验证:固定执行 agent 为 Opus 4.6,无 skill 时 0.67 分,注入 Qwen3.5-9B 写的 skill 或 Opus 写的 skill 都到 1.0——两份 skill 规定同一步骤序列,只在实现细节与冗长度上不同,程序同构。9B 开源模型写到了和前沿模型一样的程序内容。
推论同样重要:进化后的分数由执行 agent 的基座能力主导。同一 agent 配 7 个 evolver,分数波动最多 5.1pp;而 Opus 与 Qwen3-235B 的基座能力差 36.0pp。最弱 anchor agent 配上最好的 evolver,也追不上最强 agent 配上最差的 evolver。作者的建议直白:能力预算花在执行 agent 上,别花在 evolver 上。
发现二:harness-benefit 与基座能力呈倒 U 形
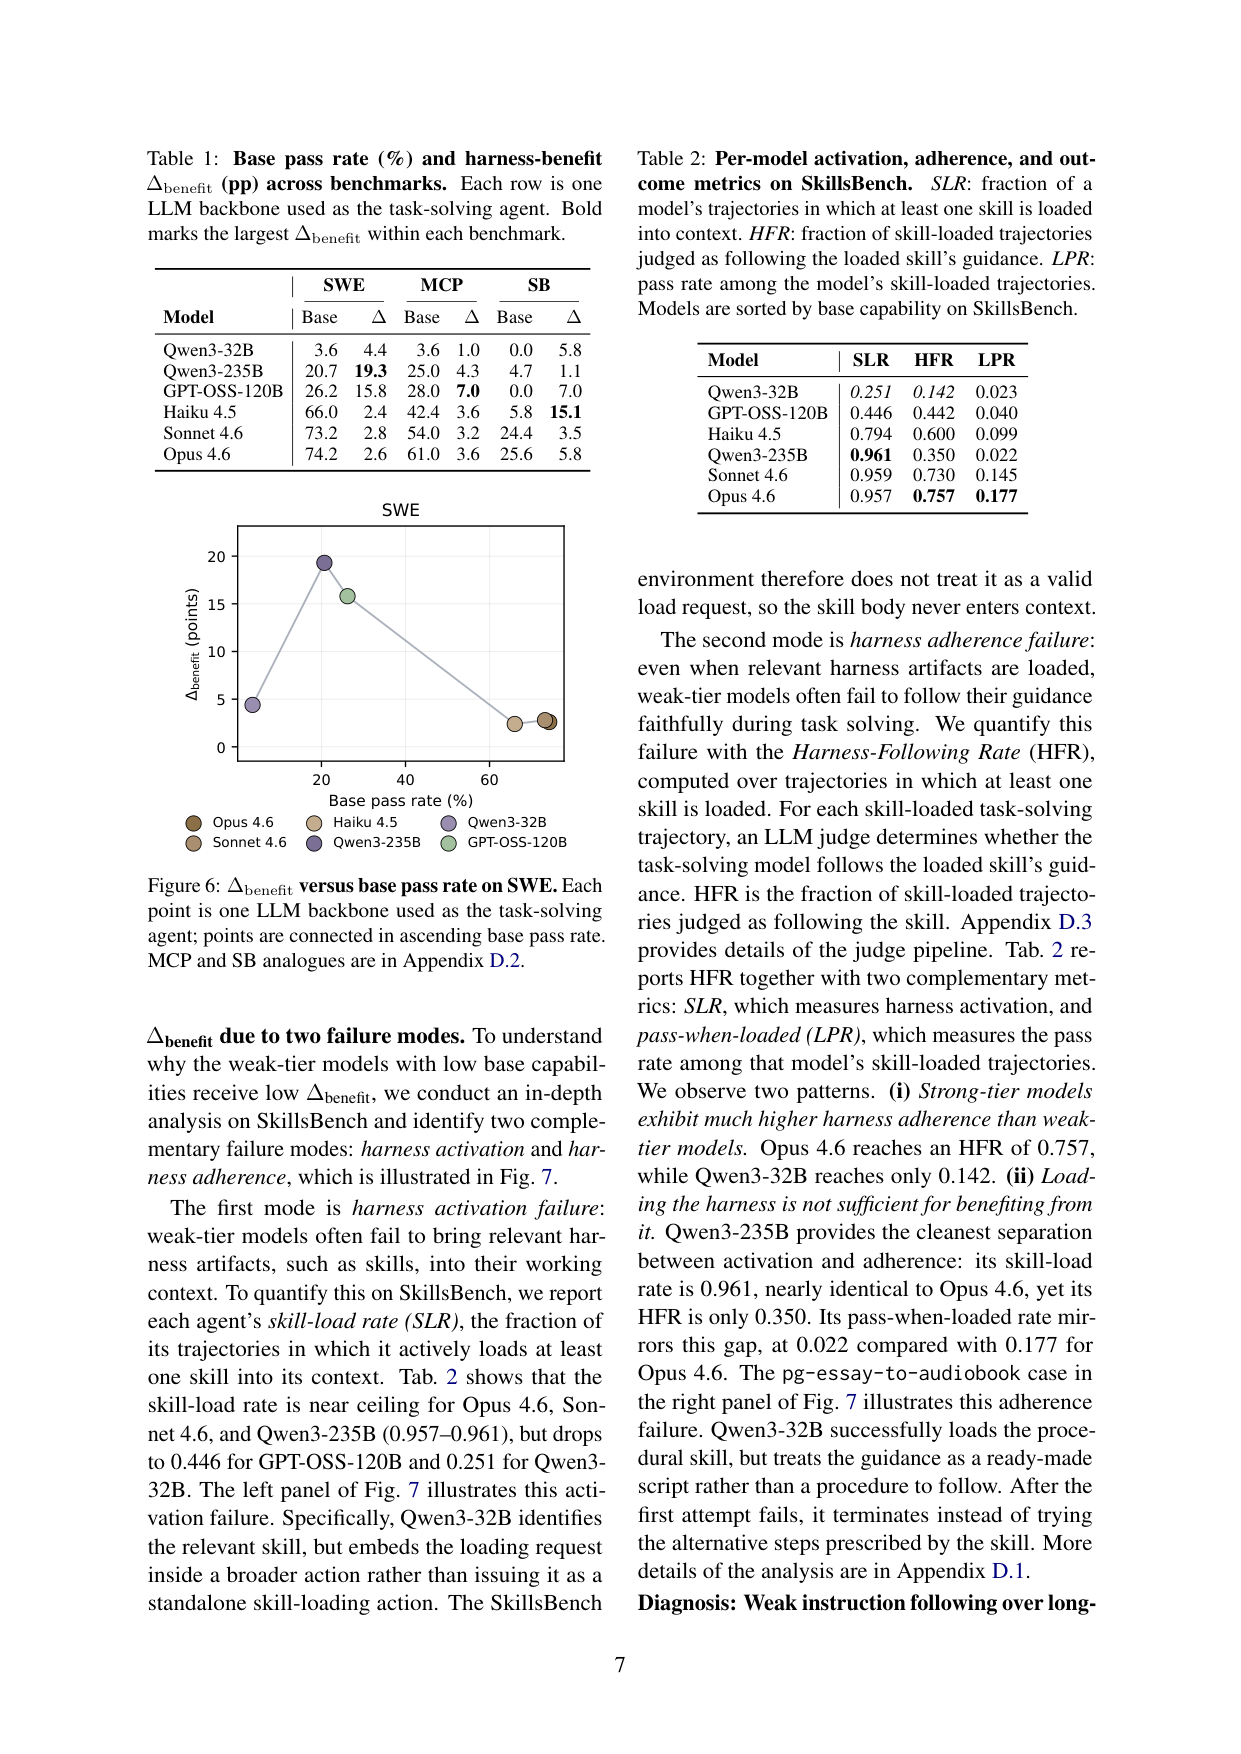
执行侧的图景完全不同:$\Delta_{\text{benefit}}$ 随基座能力非单调。SWE 上峰值在中档的 Qwen3-235B(19.3pp,base 20.7%),GPT-OSS-120B 15.8pp;两端都低——弱模型 Qwen3-32B 只有 4.4pp(base 3.6%),强模型 Opus 4.6 只有 2.6pp(base 74.2%)、Sonnet 4.6 2.8pp。MCP 的峰值移到 GPT-OSS-120B(7.0pp),SkillsBench 的峰值在 Haiku 4.5(15.1pp),但倒 U 形都在。两端的解释不同:强端是天花板效应(本来就会,没剩多少可提升);弱端是能力缺口——而弱模型恰恰是 headroom 最大的,本该获益最多。
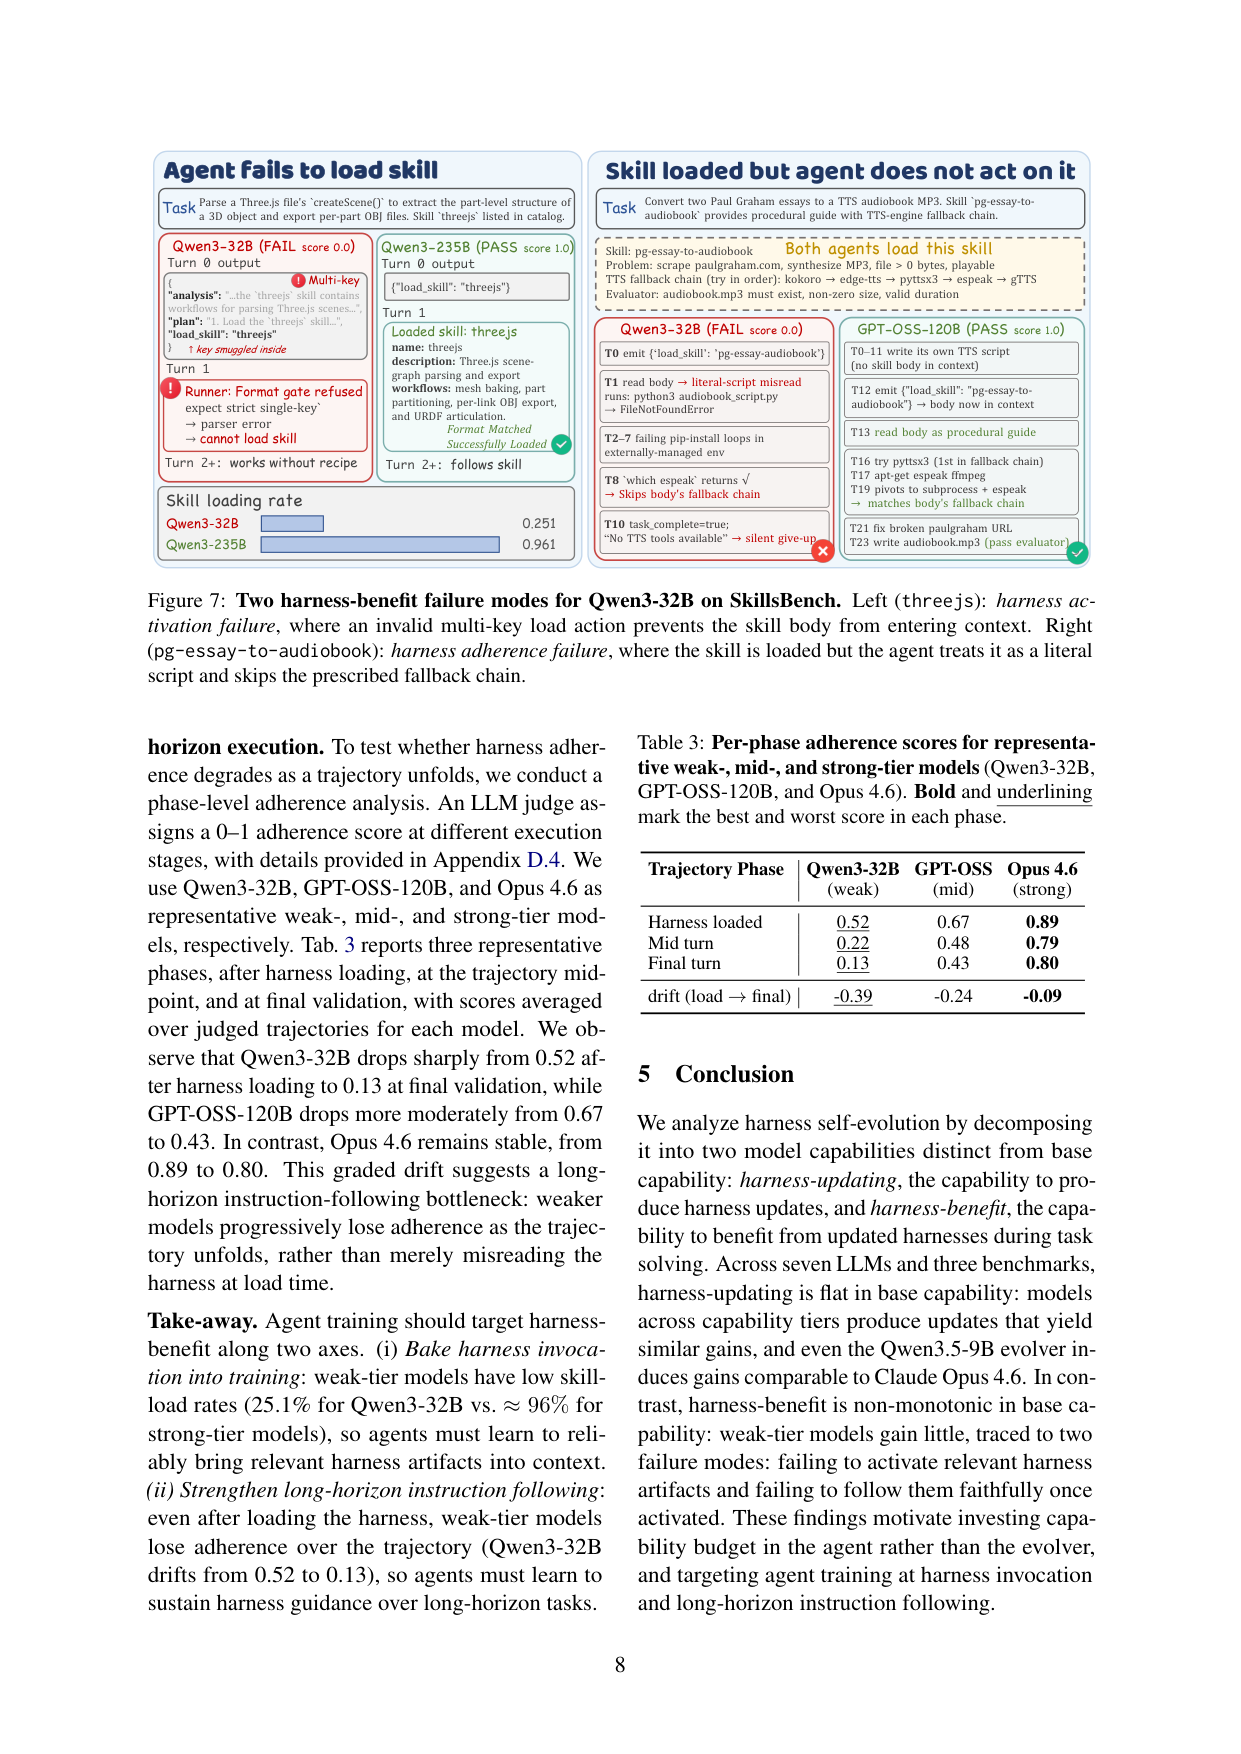
论文把弱端缺口追到两个具体环节。激活失败(activation failure):技能根本没进上下文。SkillsBench 上技能加载率 SLR 对 Opus 4.6 是 0.957,Qwen3-32B 只有 0.251——它的加载请求被嵌进 multi-key 动作,格式门禁拒绝,技能体从未加载。遵循失败(adherence failure):加载成功也未必受益。加载后遵循率 HFR,Qwen3-32B 0.142、Qwen3-235B 0.350,而 Opus 0.757;Qwen3-235B 的 SLR 0.961 几乎与 Opus 相同,HFR 却只有一半不到——激活和遵循被干净地分离。相位分析显示这是长程问题:Qwen3-32B 的遵循分数从加载后的 0.52 一路跌到终局 0.13(漂移 −0.39),Opus 稳定在 0.89→0.80。弱模型不是读不懂 harness,是撑不完长轨迹。
局限与边界
还有一组对照数字值得放进来:同一个执行 agent 配 7 个不同 evolver,post-evolution 分数波动最多 5.1pp(Qwen3-235B),而不同执行 agent 之间的基座能力差高达 36.0pp;即使把最弱 anchor agent 配最好的 evolver,也追不上最强 agent 配最差 evolver(差距 18.6–35.2pp)。MCP 上获益峰值在 GPT-OSS-120B(7.0pp)、SkillsBench 上在 Haiku 4.5(15.1pp)——倒 U 形跨 benchmark 都成立,只是峰值位置随任务分布移动。
局限与边界
论文自承两条:只测 harness 进化(权重固定),不覆盖参数微调、RL 或混合适应;模型集有代表性但非穷尽。我们补三条读出:$\Delta_{\text{benefit}}$ 取 anchor evolver 上的最大值、$\Delta_{\text{update}}$ 取 anchor agent 上的平均值,anchor 集合的选择会影响排序与量级;HFR 依赖 LLM judge,本身有噪声;进化组件只含 skills(SWE/SkillsBench),工具、middleware 等更宽的 harness 表面没有纳入,结论能否外推还不清楚。
一句话记住这篇
「写 harness 更新」与「从更新获益」是两条独立能力轴:evolver 侧最多差 3.1pp、9B 与 Opus 程序同构,执行侧呈倒 U 形、中档模型获益最大。最该记住的数字是弱模型的技能加载率 0.251 对强模型 0.957——自进化系统的短板往往在 agent 会不会用 harness,而 harness 本身写得好不好反而不是瓶颈。
这篇把 harness 自我进化拆成两个独立能力轴:evolver 侧的 harness-updating(产出有用更新的能力)与执行 agent 侧的 harness-benefit(从更新 harness 获益的能力)。跨 7 个模型 × 3 个 benchmark 的交叉配对显示:9B 的 Qwen3.5-9B 写出的 skill 与 Claude Opus 4.6 程序同构、收益相当(最好/最差 evolver 差距 ≤3.1pp),但 harness-benefit 随基座能力非单调——SWE 上中档 Qwen3-235B 获益 19.3pp,弱模型 Qwen3-32B 只有 4.4pp、强模型 Opus 4.6 只有 2.6pp——瓶颈在执行 agent 的 harness 加载率与长程指令遵循。
问题
要解决什么:端到端评测把 harness 自我进化的收益混在一起:增益可能来自 evolver 写出的 harness 质量,也可能来自执行 agent 使用 harness 的能力。作者要把这两个能力解耦,回答两个问题:哪些模型能产出有用的 harness 更新?哪些模型真正从中获益?
为什么 prior work 不够:GEPA、EvoSkill 等自进化方法的评测只报『一套更新程序 + 一个目标 agent + 一个 benchmark』的端到端增益,三个来源(基座能力、evolver 质量、agent 受益能力)纠缠在一起,无法指导『该把钱花在更强的 evolver 还是更强的执行 agent 上』。
进化循环(搜索空间 → 算子 → 评估 → 选择)
搜索空间(什么被进化):harness 状态 H_t 的可编辑组件:SWE-bench Verified 与 SkillsBench 只进化 skills,MCP-Atlas 进化 skills + prompts + memories;工具接口与执行策略固定,模型权重 f 全程固定;prompt 模板、轨迹窗口、进化预算 β 与每任务 turn 上限在所有 agent-evolver 配对间保持一致。
变异/提案算子:
- solve-evolve 迭代循环:agent (f, H_{t-1}) 在任务批 X_t 上求解,收集执行证据 D_t = {(x, τ_t,x, y_t,x)}
- evolver e 用固定 prompt 模板把 (H_{t-1}, D_t) 转成更新 ΔH_t = e(H_{t-1}, D_t),Apply 提交成 H_t
- 能力度量:Δupdate(e) = 在 anchor agent 集 F⋆ 上的平均 pair 增益;Δbenefit(f) = 在 anchor evolver 集 E⋆ 上的最大 pair 增益
评估方式:三个 agentic benchmark:SWE-bench Verified(软件工程)、MCP-Atlas(真实 MCP 服务器工具调用)、SkillsBench(跨领域技能执行);主指标 pass rate;in-situ 评估——任务在 H_{t-1} 下先打分,证据才用于产出 H_t;7 个模型:Claude Opus 4.6 / Sonnet 4.6 / Haiku 4.5、Qwen3-235B / Qwen3-32B / Qwen3.5-9B、GPT-OSS-120B。
选择与归档:本篇是分析性工作:按 T 步循环产出最终 harness H_T 并报告 pair 增益;Δbenefit 取 anchor evolver 集合上的最大值(反映该模型能获得的最好结果),Δupdate 取 anchor agent 集合上的平均值(反映该 evolver 的稳定产出质量);无显式淘汰/多样性控制。
自我改进程度:L1:固定模型 + harness 自进化(本篇不构建新的自改进系统,而是测量不同模型在 harness 进化中两个能力轴的表现;无任何权重更新,属于对 L1 系统的能力分析)。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|
输出
| 名称 | 类型 | 说明 |
|---|
数据集
| 数据 | 规模 | 备注 |
|---|
架构(摘要)
主干与结构
backbone:
参数:
类型:
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| harness-updating 跨 evolver 差距(任意 benchmark 上最好 vs 最差) | ≤3.1pp;Qwen3.5-9B 在 SkillsBench 上 3.8pp 最高,超过 Opus 4.6 的 2.3pp | Opus 4.6 / Sonnet 4.6 / Qwen3-235B 作为 evolver 的增益 | 3 个 anchor agent(Opus 4.6、Sonnet 4.6、Qwen3-235B)× 7 个 evolver × 3 benchmark(SWE/MCP/SkillsBench);pass rate 主指标 |
| flink-query 案例:9B evolver 的 skill 与 Opus 程序同构 | Opus 4.6 agent 从 0.67(无 skill)升到 1.0(9B skill 或 Opus skill),两份 skill 规定同一步骤序列,仅实现细节与冗长度不同 | 无 evolver 时 0.67 | SkillsBench flink-query 任务,固定执行 agent = Claude Opus 4.6,evolver 分别为 Qwen3.5-9B 与 Opus 4.6 |
| harness-benefit(SWE-bench Verified,Δbenefit) | Qwen3-235B 19.3pp(base 20.7%)、GPT-OSS-120B 15.8pp(26.2%)、Qwen3-32B 4.4pp(3.6%)、Opus 4.6 2.6pp(74.2%)、Sonnet 4.6 2.8pp(73.2%) | 无进化 base pass rate | anchor evolver 集 = Opus 4.6 / Sonnet 4.6 / Qwen3-235B;MCP 峰值 GPT-OSS-120B 7.0pp;SkillsBench 峰值 Haiku 4.5 15.1pp |
| 技能加载率 SLR(SkillsBench) | Qwen3-32B 0.251、GPT-OSS-120B 0.446、Opus 4.6 0.957 | 强模型 ~0.96(Opus/Sonnet/Qwen3-235B 0.957–0.961) | 轨迹中至少加载一次 skill 的比例;加载请求必须是无附加 key 的独立动作 |
| 加载后遵循率 HFR 与相位级遵循漂移 | HFR:Qwen3-32B 0.142 vs Qwen3-235B 0.350(SLR 0.961)vs Opus 0.757;相位漂移:Qwen3-32B 0.52→0.13(−0.39)、GPT-OSS-120B 0.67→0.43(−0.24)、Opus 0.89→0.80(−0.09) | Opus 4.6 全程稳定 0.89→0.80 | LLM judge 判断加载后轨迹是否遵循 skill 指引;相位 = 加载后/轨迹中点/终局验证 |
Insights
- evolver 能力随规模平坦:9B 开源模型能写出与前沿模型程序同构的 skill,把算力预算花在执行 agent 上比花在 evolver 上回报更高(§4.2 take-away)
- post-evolution 分数由 agent 基座能力主导:同一 agent 配 7 个 evolver 的分数 spread ≤5.1pp,而 Opus 与 Qwen3-235B 基座能力差 36.0pp;最弱 anchor agent 配最好 evolver 也追不上最强 agent 配最差 evolver(§4.2)
- 弱模型失效在具体环节:加载失败(SLR 0.251,load 请求被格式门禁拒绝)与遵循失败(HFR 0.142;Qwen3-32B 相位遵循 0.52→0.13)——harness invocation 与长程指令遵循应被当作一等训练目标(§4.3)
- 加载≠受益:Qwen3-235B 的 SLR 0.961 几乎与 Opus 相同,但 HFR 只有 0.350、pass-when-loaded 0.022 vs Opus 0.177,把激活与遵循干净地分离开(Table 2)
vs 同类工作
- vs 端到端自进化评测(GEPA/EvoSkill/SkillClaw):那些只报单配对增益,这篇用 7×7 交叉配对把 evolver 与 agent 能力解耦
- vs Meta-Harness/AHE 强调 harness 表示与可观测性:这篇不讨论怎么表示 harness,而是问『哪些模型的哪些能力轴』驱动收益
- vs 单组件进化(prompt/memory/skill 各自为战):这篇统一在 solve-evolve 协议下分析,并给出跨 benchmark 一致的结论
局限
- 只覆盖 harness 进化(权重固定),不评估参数微调、RL 或权重+harness 混合适应(论文自承,§6)
- 模型集代表性有限:7 个模型跨族但非穷尽,无法分离模型族、规模、训练配方与部署成本对两个能力轴的影响(论文自承)
- 我们读出:Δbenefit 取 anchor evolver 上的最大值、Δupdate 取 anchor agent 上的平均值,anchor 集合的选择会影响排序与量级,结论对度量定义敏感
- 我们读出:HFR 依赖 LLM judge 判定『是否遵循了技能』,judge 本身有噪声;进化组件只含 skills(SWE/SkillsBench),没有测工具、middleware 等更宽的 harness 表面
- 我们读出:每对 agent-evolver 的预算与轮数固定,可能系统性偏袒某类配对;Qwen3-32B 在 SkillsBench 上 base 为 0.0%,其 5.8pp 增益在零基线上的解读空间有限
可复现性
- code:论文声明源码公开(abstract 提供链接);进化协议、prompt 模板与轨迹窗口细节在附录 B.4
- weights:Claude Opus 4.6 / Sonnet 4.6 / Haiku 4.5、Qwen3-235B-A22B / Qwen3-32B / Qwen3.5-9B、GPT-OSS-120B
- sim_benchmark:SWE-bench Verified、MCP-Atlas、SkillsBench
Harness-Updating vs Harness-Benefit 架构:7×7 交叉配对实验设计
Mermaid 数据流
flowchart TD
    H0["初始 harness H0"] --> AGENT["执行 agent(f, H_{t-1})\n6 个候选模型"]
    AGENT -->|"任务批 X_t"| TR["轨迹 τ + 输出 y"]
    TR -->|"证据 D_t = {(x, τ, y)}"| EVO["evolver e\n7 个候选模型(含 Qwen3.5-9B)"]
    EVO -->|"ΔH_t = e(H_{t-1}, D_t)"| APPLY["Apply 提交\nH_t = H_{t-1} + ΔH_t"]
    APPLY -->|"下一轮"| AGENT
    APPLY -->|"T 轮后"| HT["最终 harness H_T"]
    HT -->|"in-situ 打分"| RES["pair 增益 Δ(f,e)\n= J_X(f,H_T) − M_base(f)"]
    RES -->|"按 anchor 集聚合"| UPD["Δupdate(e):anchor agent 集上的均值"]
    RES -->|"按 anchor 集取最大"| BEN["Δbenefit(f):anchor evolver 集上的最大值"]
    RES -->|"归因分析"| MODE["失败模式:\n激活失败 / 遵循失败"]
组件详解
- solve-evolve 协议:每轮 agent $(f, H_{t-1})$ 在任务批 $X_t$ 上求解并产出证据 $D_t$,evolver $e$ 用固定 prompt 模板把 $(H_{t-1}, D_t)$ 转成更新 $\Delta H_t$。全篇所有配对共享同一协议、同一初始 harness、同一进化预算 $\beta$ 与每任务 turn 上限,只换模型骨干——这是公平比较的基础。
设计要点- **anchor 限定**:Δupdate 与 Δbenefit 都依赖 anchor 集(F⋆ 三个执行者 / E⋆ 三个改壳者),换 anchor 会改变量级与排序;论文的结论「updating 平坦、benefit 倒 U」在三个 benchmark 上都成立,但具体峰值位置随任务分布移动。
设计要点
- in-situ 评估:任务在 H_{t-1} 下先打分、证据才用于产出 H_t,避免「用进化后的分数反推更新质量」的循环论证;pass rate 为 J_X 的主指标,每对 agent-evolver 共享同一任务流与预算。
设计要点
1. 解耦是全部价值:端到端分数混着三个来源(基座能力、evolver 质量、agent 受益能力),交叉配对把它们拆开——这是本论文与所有「自进化方法评测」的根本区别。
2. 结论一:evolver 平坦——最好/最差 evolver 差距 ≤3.1pp,9B 与 Opus 程序同构,把钱花在执行 agent 上。
3. 结论二:benefit 倒 U 形——弱端卡在激活(SLR 0.251)与遵循(HFR 0.142)两个具体环节,强端是天花板效应,训练目标应指向 harness invocation 与长程指令遵循。
4. 度量依赖 anchor 集合:$\Delta_{\text{benefit}}$ 取最大值、$\Delta_{\text{update}}$ 取平均值,anchor 选择会影响量级——读结果时要带着这个限定。
两个核心发现:updating 平坦、benefit 非单调
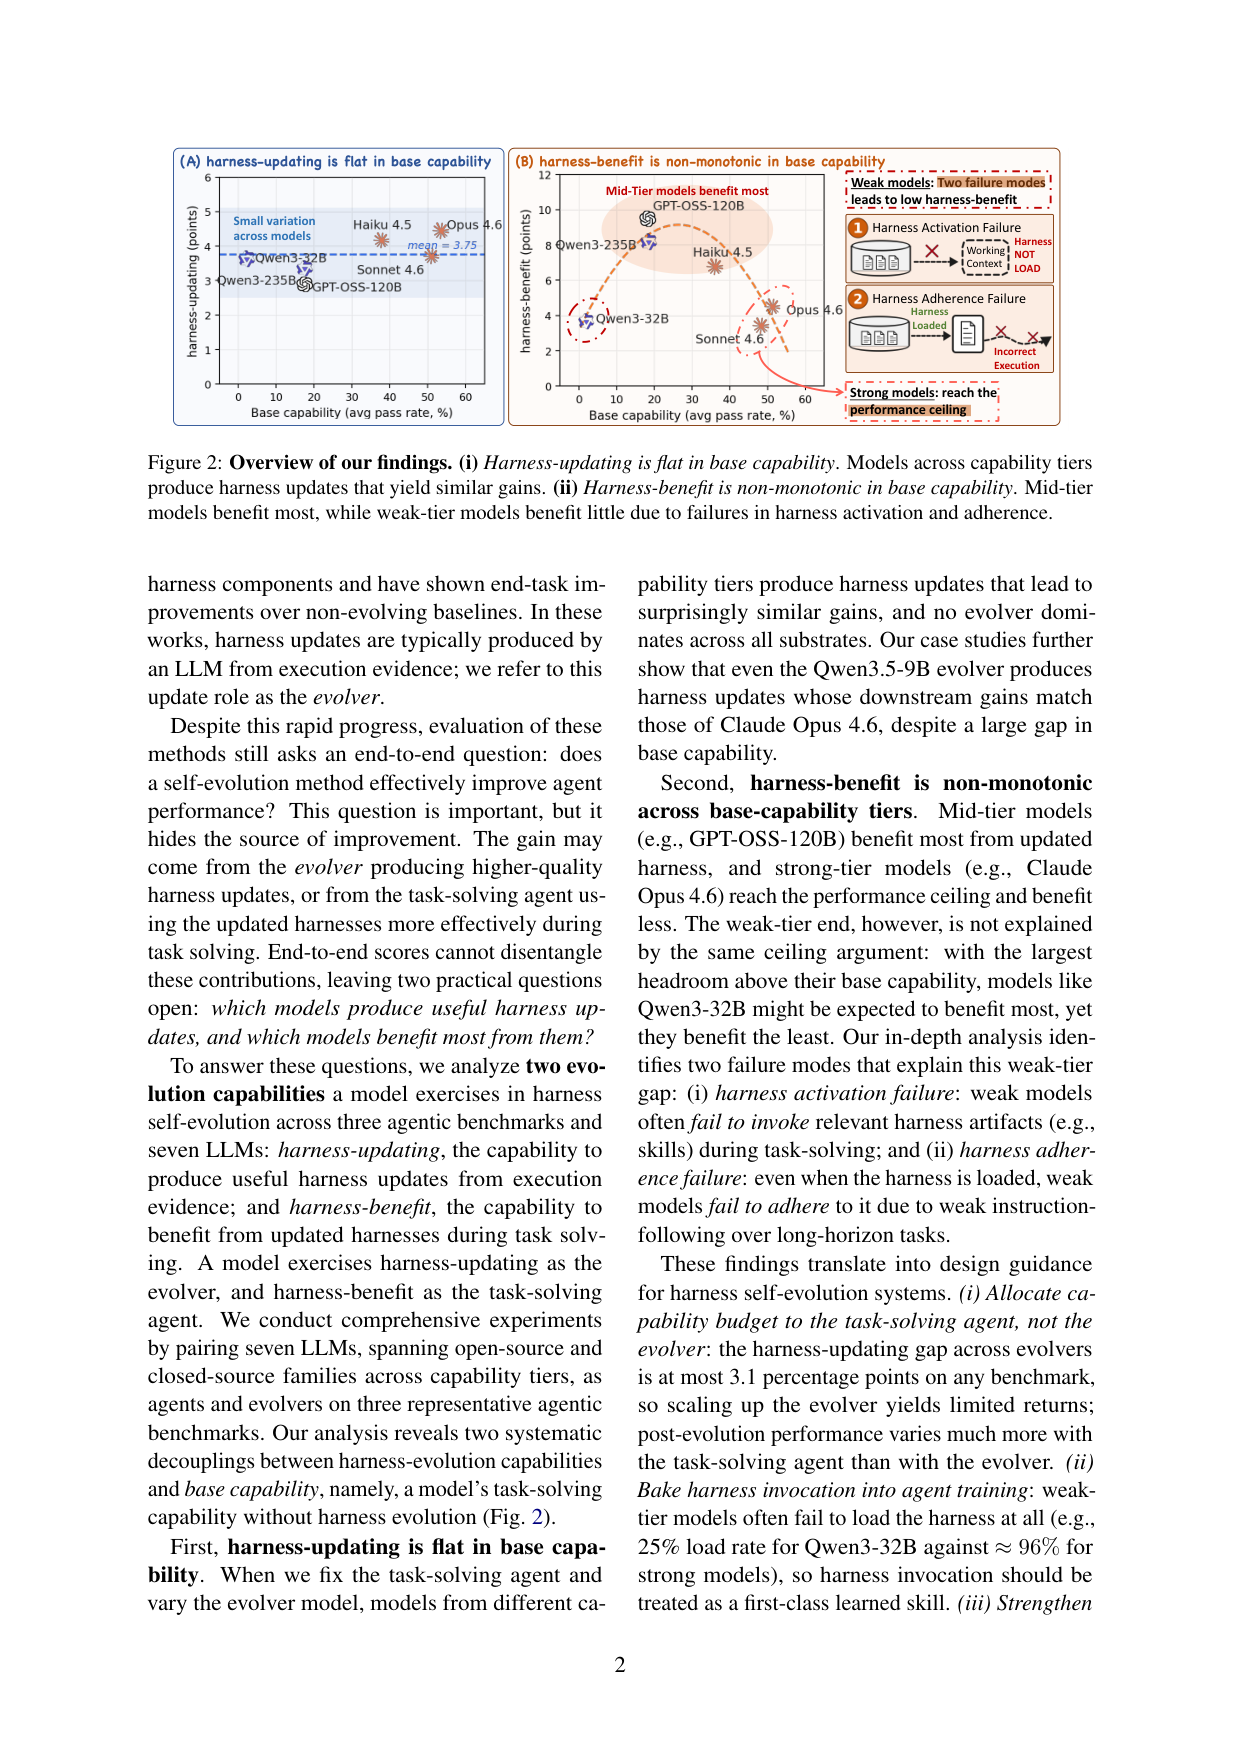
原文 caption:Overview of our findings. (i) Harness-updating is flat in base capability. Models across capability tiers produce harness updates that yield similar gains. (ii) Harness-benefit is non-monotonic in base capability. Mid-tier models benefit most, while weak-tier models benefit little due to failures in harness activation and adherence.
全篇结论图:(A) evolver 间增益差异很小——9B 与前沿模型产出同样有用的 harness 更新;(B) harness-benefit 呈倒 U 形——中档模型获益最大,弱模型卡在激活/遵循两个失败模式,强模型接近能力天花板。读图要抓住『两条曲线形状完全不同』这个核心:同一套自进化管线,瓶颈在不同端。
各 evolver 的 harness-updating 能力:模型间差距小且无全局赢家
原文 caption:Harness-updating capability (Δupdate) of each evolver. Evolvers are grouped by model family (Claude, Qwen, GPT-OSS). The best and worst evolver, marked in bold within each panel, change with the benchmark.
证明 updating 平坦:同一 benchmark 上最好与最差 evolver 的 Δupdate 差距最多 3.1pp,且没有模型在所有 benchmark 上领先——Qwen3-235B 在 SWE 上 8.2pp 领先、在 MCP 上 0.6pp 垫底。最反直觉的点:最小的 Qwen3.5-9B 在 SkillsBench 上 3.8pp 超过 Opus 4.6 的 2.3pp。
SWE 上 harness-benefit 与基座能力呈倒 U 形
原文 caption:Δbenefit versus base pass rate on SWE. Each point is one LLM backbone used as the task-solving agent; points are connected in ascending base pass rate. MCP and SB analogues are in Appendix D.2.
直接展示非单调性:横轴是 base pass rate(能力),纵轴是 Δbenefit。峰值在 Qwen3-235B(19.3pp),两侧都更低——Qwen3-32B(base 3.6%)只有 4.4pp,Opus 4.6(base 74.2%)只有 2.6pp。读图要区分两端的解释:强端是天花板效应,弱端是激活/遵循失败,论文据此给出不同的训练建议。
弱模型的两个 harness-benefit 失败模式:加载失败与遵循失败
原文 caption:Two harness-benefit failure modes for Qwen3-32B on SkillsBench. Left (threejs): harness activation failure, where an invalid multi-key load action prevents the skill body from entering context. Right (pg-essay-to-audiobook): harness adherence failure, where the skill is loaded but the agent treats it as a literal script and skips the prescribed fallback chain.
机制证据:左图 Qwen3-32B 把 load_skill 请求嵌进 multi-key 动作,格式门禁拒绝,技能体从未进入上下文(SLR 0.251 vs Opus 0.957);右图技能加载成功但被当成字面脚本执行,跳过 TTS 回退链导致失败(HFR 0.142 vs Opus 0.757)。读图得出『加载 ≠ 受益』:Qwen3-235B 的 SLR 0.961 接近 Opus,但 HFR 只有 0.350、LPR 0.022。
「会写 harness 更新」和「能从更新获益」是两回事(对话版)
小播:今天聊一篇做「体检」的论文——不造新系统,而是把已有的自进化 agent 拆开体检,找出钱到底该花在哪。
老播:这篇来自宾州州立、UCSC 和 Amazon,标题很长:Harness Updating Is Not Harness Benefit。它回答了自进化领域一个被长期忽略的问题:端到端涨分,到底是 evolver 写得好,还是执行 agent 用得好?答案是:两件事,而且规律完全不同。
小播:先别急,两个词解释一下?
老播:harness 是 agent 的外壳——技能、提示词、记忆、工具。evolver 是负责根据执行经验改写外壳的那个模型;执行 agent 是拿着外壳去干活的那个模型。自进化系统里这两个角色通常是两个模型,但评测从来只报合起来的分数。
小播:那这篇怎么拆开?
老播:交叉配对:7 个模型,两两组合,谁都能当执行者、谁都能当改壳者,在软件工程、工具调用、技能执行三个 benchmark 上全跑一遍。然后定义两个指标——evolver 的「更新能力」取它在三个固定执行者身上的平均增益,执行者的「获益能力」取它能从三个固定改壳者那里拿到的最大增益。拆开之后,两条完全不同的曲线出来了。
第一段:发现一——写外壳的能力,跟模型强弱无关
小播:第一条曲线是什么样?
老播:几乎平的。同一 benchmark 上,最好的改壳者和最差的改壳者,带来的增益差距最多 3.1 个百分点,而且没有一个模型在所有 benchmark 上都能赢。Qwen 的 235B 在软件工程上领先,到工具调用上垫底。最反直觉的是最小的模型:Qwen3.5-9B,9B 参数,在技能执行 benchmark 上拿了全场最高——3.8 个点,超过 Claude Opus 4.6 的 2.3 个点。
小播:9B 超过 Opus?这也太夸张了,怎么验证的?
老播:他们做了一个很干净的案例:让 Opus 4.6 当执行者跑一个技能任务,没有技能时得 0.67 分;分别注入 9B 模型写的技能和 Opus 自己写的技能,都到 1.0。把两份技能摆在一起看——步骤序列完全同构,只是实现细节和话多话少不同。也就是说,写 harness 更新这件事,似乎是一个「会了就会了」的能力,规模不太起作用。
小播:那这意味着什么?
老播:推论很直接:进化后的总分主要由执行 agent 决定。同一个执行者配 7 个不同的改壳者,分数波动最多 5.1 个点;而不同执行者之间,基座能力差着 36 个点。作者的建议是把算力预算花在执行 agent 上,别花在 evolver 上。记住这个判断,后面我们会质疑它一次。
第二段:发现二——获益能力是倒 U 形
小播:那第二条曲线呢?
老播:非单调,倒 U 形。拿软件工程 benchmark 说:中档的 Qwen3-235B 获益最大,19.3 个点,它基座通过率 20.7%;两端的获益都小——弱模型 Qwen3-32B 只有 4.4 个点,它基座只有 3.6%,本来空间最大;强模型 Claude Opus 4.6 只有 2.6 个点,它基座 74.2%,接近天花板。
小播:强端好理解,天花板效应。弱端为什么?空间那么大,怎么吃不到?
老播:这才是论文最值钱的部分,他们把弱端缺口追到了两个具体环节。第一个叫激活失败:技能根本没进模型的工作上下文。测了个指标叫技能加载率——轨迹里真正加载过至少一次技能的占比。Opus 4.6 是 0.957,几乎每次都会加载;Qwen3-32B 只有 0.251。翻轨迹发现,弱模型把加载请求嵌进了一个多字段动作里,格式门禁不认,技能体就没进去。
小播:那加载成功了呢?
老播:第二个失败模式,遵循失败:加载了也白搭。加载后的遵循率,Qwen3-32B 是 0.142,Opus 是 0.757。最干净的对照是 Qwen3-235B——它的加载率 0.961,跟 Opus 几乎一样,但遵循率只有 0.350,加载后通过率 0.022,Opus 是 0.177。加载和遵循被彻底分开了。而且这是长程问题:弱模型的遵循分数从加载后的 0.52 一路掉到终局的 0.13,Opus 稳定在 0.89 到 0.80。
小播:所以弱模型不是读不懂 harness,是撑不完长轨迹?
老播:对,这个归因很重要。所以作者给的训练建议也分两条:把「调用 harness」本身训练成技能——弱模型加载率 0.251 对强模型 0.957;再加强长程指令遵循——弱模型漂移 0.39,强模型只有 0.09。
第三段:局限与争议
小播:现在回来质疑刚才那句「钱花在执行 agent 上」。
老播:好问题。首先要限定:这篇只测了 harness 进化,权重固定——参数微调、强化学习、权重加外壳混合适应都不在讨论范围。其次,模型只有 7 个,跨族但不穷尽,没法分清是模型家族、规模还是训练配方在起作用。
小播:指标本身有没有问题?
老播:有,我们读出来的有三条。一是「获益能力」取的是三个固定改壳者里的最大值,「更新能力」取的是三个固定执行者上的平均值——anchor 集合选谁,排序和量级都会变,结论对度量定义敏感。二是「遵循率」是靠 LLM 裁判判断轨迹有没有按技能走,裁判本身有噪声。三是进化组件只有技能——软件工程和技能执行两个 benchmark 都不动工具、中间件,结论能不能外推到更宽的外壳表面,还不清楚。
小播:那最值得信的是什么?
老播:最稳的是那条结构性的差异:写更新几乎不随规模变强,用更新却高度依赖执行者的加载和遵循能力。这个「拆开看」的视角本身,比任何一个具体数字都重要——以后谁再报自进化的端到端增益,你都该问一句:增益来自 evolver 还是执行者?
收尾:一句话记住这篇
小播:最后用一句话总结?
老播:这篇把 harness 自我进化拆成两条独立能力轴——evolver 的更新能力与执行者的获益能力——前者随规模平坦,后者呈倒 U 形,瓶颈在执行者的加载与长程遵循。
小播:最该记住的数字呢?
老播:技能加载率,0.251 对 0.957——这是弱模型和强模型在「会不会用 harness」上的真实差距。它说明自进化系统的短板常常不在 harness 写得好不好,而在执行 agent 用不用得了。这个数字值得记住。