ShinkaEvolve:把程序进化的样本需求从数千次压到约 150 次
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。
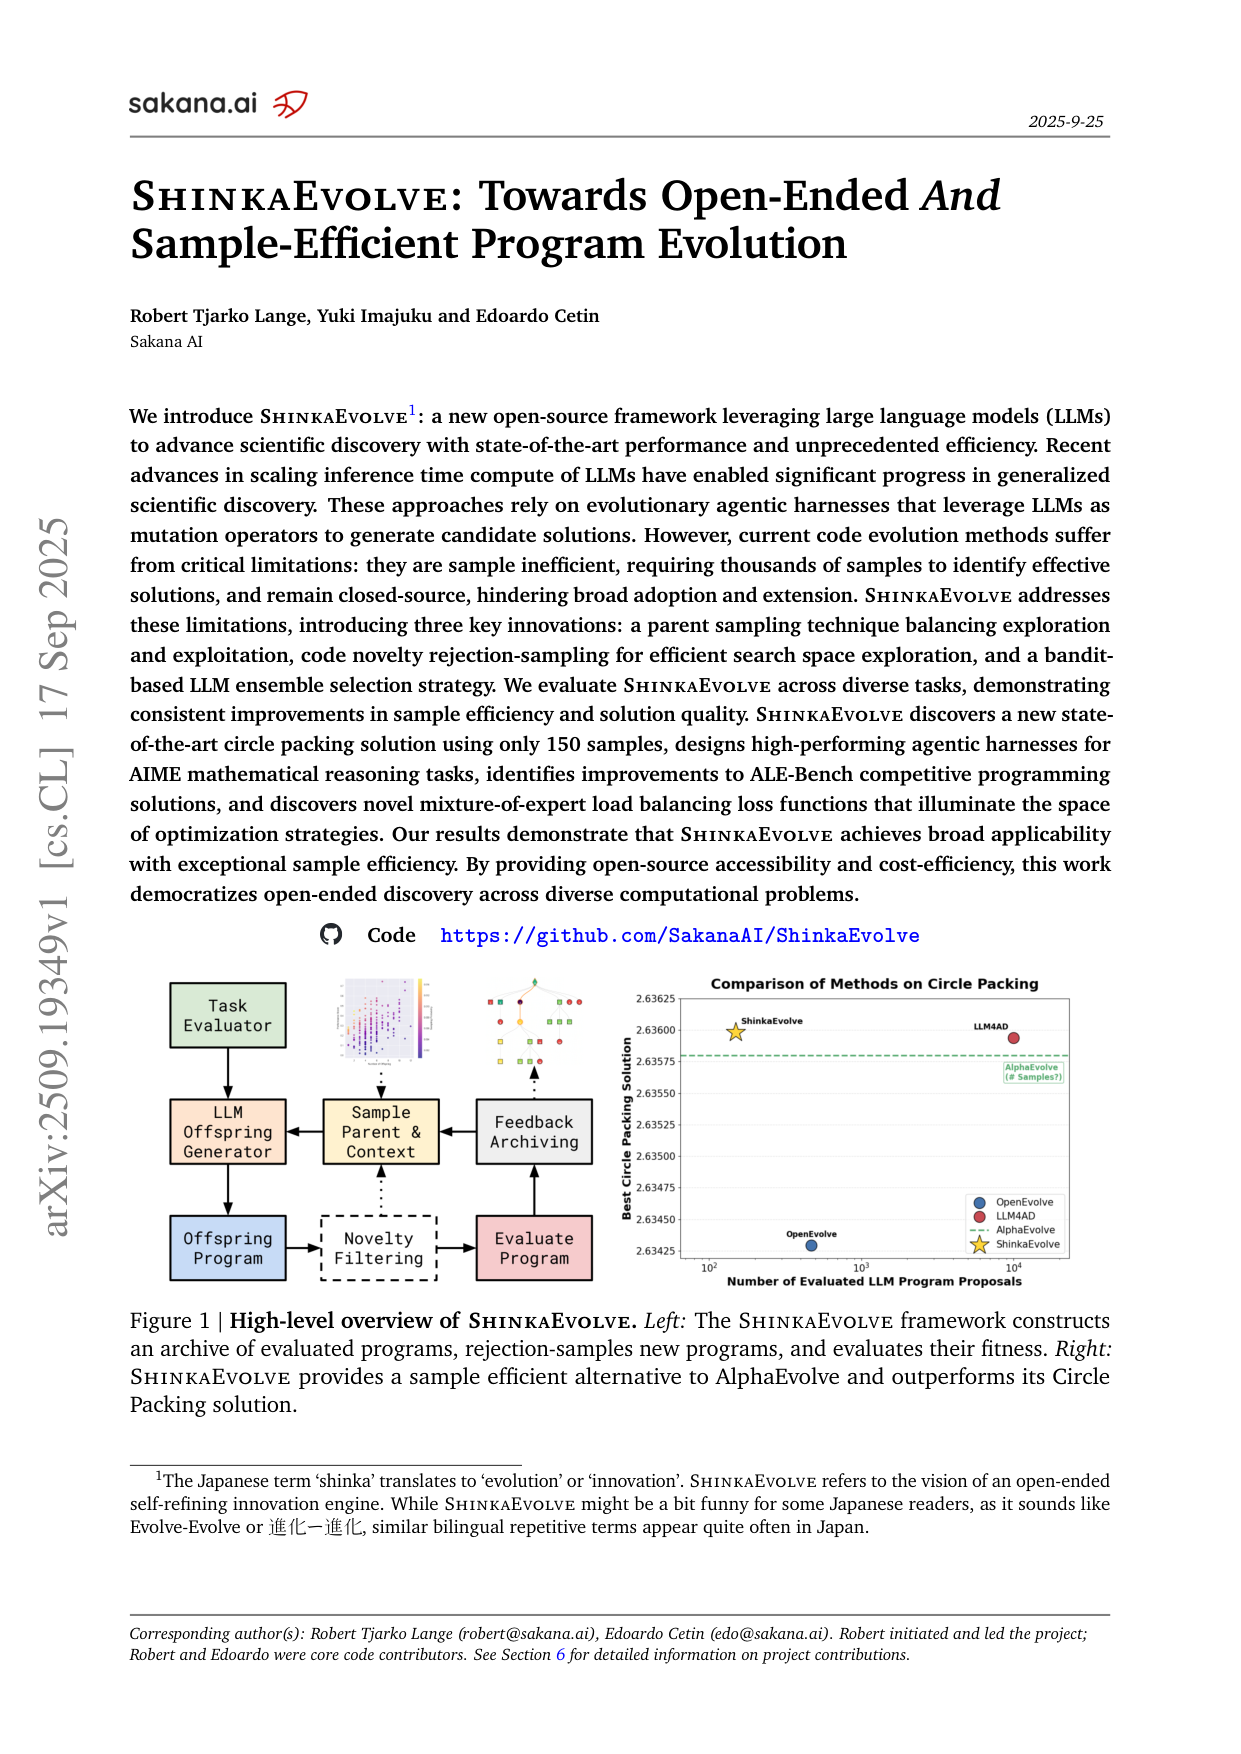
先看一个现象:AlphaEvolve 用进化程序搜索做出 4×4 矩阵乘法改进、刷新多个数学上界,但它是闭源的,而且「要数千次评估才能找到有效解」。Sakana AI 的这篇 ShinkaEvolve 说,样本效率的瓶颈主要不在 LLM,而在采样侧——怎么选父程序、怎么过滤变异提议、怎么挑 LLM。把这三个环节改对,26 圆 circle packing 这个任务,约 150 次程序评估就超过了 AlphaEvolve 的公开解。
背景:进化搜索的采样侧工程
进化循环本身是标准件:档案(archive)存评估过的程序,变异算子由 LLM 承担,评估器打分。ShinkaEvolve 的论文价值在三个组件:parent sampling(选谁当父代)、code-novelty 拒绝采样(变异提议是否够新)、UCB1 bandit + meta-scratchpad(用哪个 LLM、沉淀什么经验)。它的实验也刻意跨了四种任务:circle packing(几何优化)、AIME agent scaffold(推理 agent 设计)、ALE-Bench(AtCoder 启发式竞赛)、MoE 负载均衡损失(LLM 训练本身)。
核心机制:两条公式管住「探索 vs 利用」
再补两个结构细节。第一是岛屿模型:档案分成两个子群(岛屿)各自并行进化,岛内最优程序禁止迁移,其余程序偶尔跨岛流动——隔离保住多样性,迁移扩散知识。第二是 UCB1 与 meta-scratchpad:系统维护一个 8 个 LLM 的池子(Gemini/Claude/GPT 系),每次变异用 UCB1 按「相对改进奖励」选模型,奖励定义为相对父代与初始程序的提升(exp(max(r_i − r_i^b, 0)) − 1),让「敢提高风险高收益变异」的模型被更多地用;meta-scratchpad 每隔 T 代把最近的成功程序总结成「全局洞见 + 实现建议」,追加进变异提示。这两个机制都作用于「怎么进化」,是元层的经验利用。
先看 parent sampling。最朴素的做法是总改当前最优(hill climbing),快但早停;总随机抽(uniform)又浪费已有知识。ShinkaEvolve 提供两种折中。第一种按排名做幂律采样:
$$p_i = \frac{r_i^{-\alpha}}{\sum_{j=1}^{n} r_j^{-\alpha}}$$
$r_i$ 是程序 $i$ 的 fitness 排名(最优为 1),$\alpha$ 控制剥削强度:$\alpha=0$ 退化成均匀采样,$\alpha \to \infty$ 退化成 hill climbing。第二种 weighted 采样把性能和「子代数」相乘:
$$w_i = \sigma\big(\lambda (F_i - \alpha_0)\big) \cdot \frac{1}{1 + N_i}$$
$F_i$ 是 fitness,$\alpha_0 = \text{median}(F)$ 是中位 fitness,$\lambda$ 是选择压力,$\sigma(\cdot)$ 是 sigmoid;$N_i$ 是这个程序已有的子代数,$1/(1+N_i)$ 是 novelty 项——子代越少的程序越优先被再采样,防止少数精英垄断繁殖。
第二个机制是 novelty 拒绝采样:把可变代码段用嵌入模型编码,算档案内两两余弦相似度;最大相似度超过阈值 $\eta = 0.95$ 时,再叫一个 LLM 判断这个提议是否「有意义地不同」,两道关都过才执行。这解决的是 LLM 变异常犯的毛病——反复提议近亲变体。
关键结果:四类任务、四条证据链
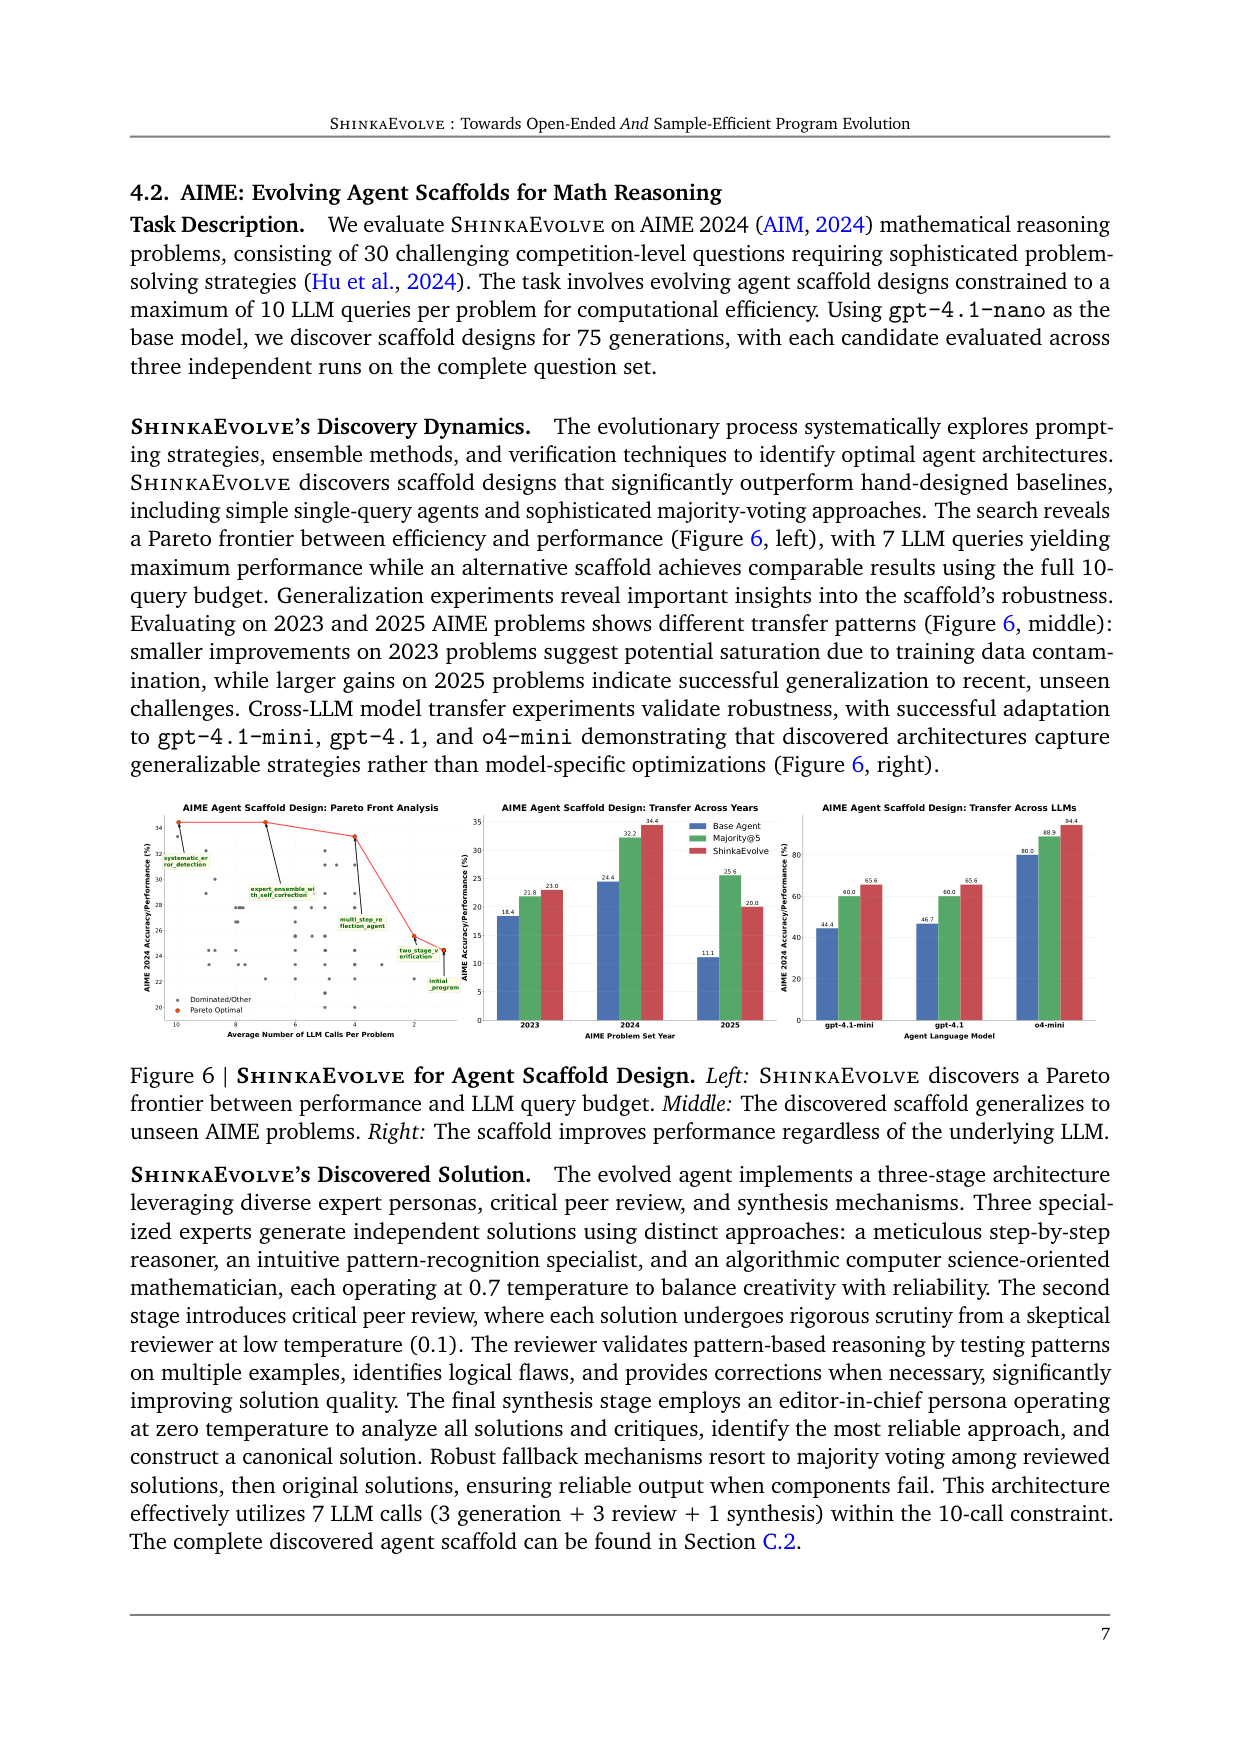
数字全部带 baseline 和 setup。Circle packing(n=26):半径和 2.6359831(1e-6 容差验证器),AlphaEvolve 精确验证器下 2.6359777,此前 SOTA 是 2.634、AlphaEvolve 改进到 2.635;ShinkaEvolve 在约 150 次评估内做到。AIME 2024(gpt-4.1-nano、每候选 3 次运行、10 次 LLM 调用约束):进化出的 scaffold 34.4%,单查询基座 24.4%、Majority@5 32.2%;换模型直接迁移——gpt-4.1-mini 从 44.4% 到 65.6%,o4-mini 从 80.0% 到 94.4%。ALE-Bench LITE(10 个 AtCoder 任务,public test 作 fitness):平均分 1879.3 → 1923.5(private 1932.1),ahc039 从第 5 名升到第 2 名(2880 → 3140)。MoE LBL:在 global-batch LBL(Shazeer 2017,Qwen3 用同款)上加「熵加权 × 低利用率专家惩罚」正则项,556M/82M 活跃参数的 MoE 在 2.1B token 上进化的损失,搬到 2.7B/404M 活跃、约 30B token 训练上,三个 $\lambda$ 下困惑度与 7 项下游任务全面改善。
消融(Fig.9)给出组件归因:novelty 拒绝采样对最终分数的贡献最大;weighted parent 采样稳定优于 hill climbing 与 Best-of-N;bandit 集成只带来小幅提升。
局限:证据有缺口,结论要打折
四条。第一,meta-scratchpad 和 bandit 没有独立消融(Fig.9 只覆盖 parent sampling、novelty rejection、ensemble),「元层经验沉淀有用」的贡献未被单独量化。第二,ALE-Bench 的改进贴近初始解(作者自承),有过拟合初始化的风险。第三,circle packing 主报告用 1e-6 容差验证器,切到精确验证要多花样本(作者自承先跑松弛任务、事后精确化)。第四,MoE 实验的进化与测试架构相近、训练预算有限(作者自承),下游任务截断到 1000 题;AIME 2023 年题的增益小于 2025 年,作者归因于潜在训练数据污染。
还有一条实践层面的提醒:论文把超参数表完整公开(表 1),包括岛屿数 2、阈值 0.95、温度 {0.0, 0.5, 1.0}、嵌入模型 text-embedding-3-small 等,复现门槛低;但 circle packing 主结果仍是单次运行的图线呈现,读结论时把「一次运气好」的可能性算进去。
一句话记住这篇
ShinkaEvolve 把采样侧工程做成了样本效率杠杆:power-law/weighted parent 采样平衡探索与利用,嵌入余弦 + LLM 双重 novelty 拒绝采样控制搜索方向,UCB1 + meta-scratchpad 利用经验。最该记住的数字:约 150 次程序评估发现新的 circle packing SOTA(半径和 2.6359831,对照此前最优 2.634);最该记住的缺口:元层组件的独立消融还没有做。
三个采样效率组件——按性能与子代数平衡的 parent sampling、embedding 余弦相似度的 code-novelty 拒绝采样、UCB1 选择 LLM 加 meta-scratchpad 沉淀成功模式——让 ShinkaEvolve 只用约 150 次程序评估就发现新的 circle packing SOTA(26 圆半径和 2.6359831,超越 AlphaEvolve 的 2.635),并进化出 AIME agent scaffold 与 MoE 负载均衡损失。
问题
要解决什么:让 LLM 驱动的程序进化更省样本:现有方法(如 AlphaEvolve)要数千次评估才能找到有效解,且多为闭源,ShinkaEvolve 用三个采样侧组件把样本需求压到约 150 次并全部开源。
为什么 prior work 不够:朴素探索策略没有利用上一代积累的知识,parent 选择与变异提议都缺少「多样性控制」;导致样本效率低、搜索空间探索浅。
进化循环(搜索空间 → 算子 → 评估 → 选择)
搜索空间(什么被进化):带 EVOLVE-BLOCK-START/END 标记的程序代码(可变区 + 不可变骨架,程序性保证不可变块不被改);Python 为主;同一框架也进化 agent scaffold(受 10 次 LLM 调用约束的 agent 程序)与 MoE 损失函数。
变异/提案算子:
- diff-based edits:LLM 生成 SEARCH/REPLACE 块做定点修改
- full rewrites:整体重写但程序性保护不可变块
- crossover:额外采样一个档案程序,LLM 合并两个程序
- 无效 patch 用 Reflexion 式解析反馈重采样;温度采样 + 多 LLM
- UCB1 bandit 动态选择 LLM(按相对改进奖励更新)
- meta-scratchpad:每 T 代总结成功模式与设计原则,追加进变异 prompt
- 论文未给出:meta-scratchpad 的独立消融
评估方式:多目标评估:标量 fitness + 公开 metrics + 文本反馈,全部存进档案作为后续变异的上下文。任务与 setup:circle packing(OpenEvolve 验证器 1e-6 容差 + AlphaEvolve 精确验证);AIME 2024(30 题、每候选 3 次独立运行、10 次 LLM 调用约束);ALE-Bench LITE(10 个 AtCoder 启发式竞赛,public test 作 fitness、private 报告);MoE LBL(556M/82M 活跃参数 MoE 在 2.1B token 上进化 30 代,2.7B/404M 在约 30B token 上验证)。
选择与归档:岛屿模型(2 岛、岛内最优不迁移);parent sampling 两选一:power-law(按 fitness 排名的 r^-α 概率)或 weighted(sigmoid 性能 × 1/(1+子代数) 的 novelty 项);code-novelty 拒绝采样:嵌入可变代码算余弦相似度,超过阈值 η=0.95 再叫 LLM 判断是否「有意义地不同」。
自我改进程度:L1(LLM 权重固定,进化程序/scaffold/损失):meta-scratchpad 记录成功模式、bandit 调整 LLM 使用概率,但这两层机制本身固定、不参与进化。论文未给出:让 meta 层自身进化的实验。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|
输出
| 名称 | 类型 | 说明 |
|---|
数据集
| 数据 | 规模 | 备注 |
|---|
架构(摘要)
主干与结构
backbone:
参数:
类型:
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| Circle packing 半径和(n=26,越大越好) | 2.6359831(1e-6 容差验证器)/ 2.6359777(AlphaEvolve 精确验证器) | 此前 SOTA 2.634(AlphaEvolve 改进到 2.635);ShinkaEvolve 约 150 次评估内超越 | 26 圆装入单位正方形、最大化半径和;150 代、2 岛;文本附录与 Figure 1/5/10(§4.1) |
| AIME 2024 准确率(gpt-4.1-nano) | 进化 scaffold 34.4% | 单查询基座 agent 24.4%;Majority@5 32.2% | 30 题 AIME 2024;每候选 3 次独立运行;10 次 LLM 调用约束;75 代;Figure 6(§4.2) |
| AIME scaffold 跨模型迁移(AIME 2024) | gpt-4.1-mini 44.4%→65.6%;gpt-4.1 46.7%→65.6%;o4-mini 80.0%→94.4% | 各模型基座 agent | 用 gpt-4.1-nano 进化出的 scaffold 直接换模型评估;Figure 6 右(§4.2) |
| ALE-Bench LITE 平均分(10 个 AtCoder 启发式任务) | 1879.3 → 1923.5(public Top-1)/ 1932.1(private) | ALE-Agent 发现的初始解 1879.3 | 50 代、public test 作 fitness;任务 ahc039 从第 5 名 2880 分升到第 2 名 3140 分;Figure 7(§4.3) |
| MoE 负载均衡损失(LBL) | 在 global-batch LBL 上加熵加权低利用率专家正则项,三个 λ∈{0.001,0.01,0.1} 下困惑度与 7 项下游任务均改善,λ 越大差距越大 | global-batch LBL(Shazeer 2017,Qwen3 等所用) | 进化:556M 参数/82M 活跃、64 专家 K=8、2.1B token;验证:2.7B/404M 活跃、约 30B token;Figure 8(§4.4) |
| 组件消融(circle packing) | weighted parent 采样 > hill climbing > Best-of-N;novelty 拒绝采样影响最大;bandit 集成小幅提升 | Best-of-N(无进化历史)/ hill climbing(纯贪心) | 同一 circle packing 任务、约 140 次评估内对比;Figure 9(§5) |
Insights
- 样本效率来自采样侧的三个协同设计:parent 采样平衡探索/利用、novelty 拒绝采样控制搜索方向、bandit + scratchpad 利用进化经验。
- 拒绝采样把「LLM 提议」变成受控搜索步骤:嵌入余弦阈值(η=0.95)先过滤、LLM 再判断「是否有意义地不同」,两道关都过才执行。
- bandit 用相对改进奖励(相对父代与初始程序的提升)更新,适配程序档案不断变好的非平稳环境。
- meta-scratchpad 把进化经验沉淀为提示内的高层指导(成功策略与实现建议),让后续变异站在前代肩膀上。
- 开源 + 低样本需求把进化发现的门槛降到数十美元 API 成本量级,具备民主化意义。
vs 同类工作
- 相
- 比
- A
- l
- p
- h
- a
- E
- v
- o
- l
- v
- e
- (
- 闭
- 源
- 、
- 数
- 千
- 次
- 评
- 估
- 、
- 手
- 写
- 数
- 据
- 库
- 管
- 理
- )
- ,
- S
- h
- i
- n
- k
- a
- E
- v
- o
- l
- v
- e
- 开
- 源
- 且
- 把
- 样
- 本
- 需
- 求
- 压
- 到
- 约
- 1
- 5
- 0
- 次
- ,
- 明
- 确
- 引
- 入
- p
- a
- r
- e
- n
- t
- s
- a
- m
- p
- l
- i
- n
- g
- 策
- 略
- 、
- n
- o
- v
- e
- l
- t
- y
- 拒
- 绝
- 采
- 样
- 与
- b
- a
- n
- d
- i
- t
- L
- L
- M
- 选
- 择
- ;
- 相
- 比
- O
- p
- e
- n
- E
- v
- o
- l
- v
- e
- 等
- 社
- 区
- 实
- 现
- ,
- 多
- 了
- 元
- 层
- 的
- 经
- 验
- 沉
- 淀
- (
- m
- e
- t
- a
- -
- s
- c
- r
- a
- t
- c
- h
- p
- a
- d
- )
- 与
- 模
- 型
- 自
- 适
- 应
- 。
局限
- meta-scratchpad 与 bandit 选择没有独立消融(Figure 9 只覆盖 parent sampling、novelty rejection、ensemble),其贡献幅度未被单独量化。
- ALE-Bench 的改进在算法上贴近初始解(作者自承),存在对初始化解过拟合的风险,跨初始化稳健性未测。
- circle packing 主报告使用 1e-6 容差验证器;切到 AlphaEvolve 精确验证需要更多样本(作者自承用松弛任务做进化、事后精确化)。
- MoE LBL 实验的进化与测试架构相近、训练预算有限(作者自承),下游任务截断到 1000 题,长期训练收益只做了外推。
- AIME scaffold 在 2023 年题上的增益小于 2025 年,作者将之归因于潜在训练数据污染,说明 benchmark 选择会影响结论。
- circle packing 等主结果以单次运行图线为主,缺少多 seed 统计;API 成本虽低但没有逐任务精确披露。
可复现性
完全开源(github.com/SakanaAI/ShinkaEvolve):给出完整代码、Circle Packing 超参数表(Table 1,含 8 个 LLM 的 bandit 池、温度、嵌入模型、阈值 0.95)、进化树可视化与发现的程序全文;AIME scaffold 代码在附录 C.2;报告了累计 API 成本曲线(Figure 5/11)。
ShinkaEvolve 架构:采样侧工程的数据流
flowchart TD
    A["初始程序(EVOLVE-BLOCK 标注)"] --> B["档案/Archive(岛屿模型:2 岛,精英不迁移)"]
    B --> C["parent sampling:power-law(r^-α)或 weighted(sigmoid 性能 × 1/(1+子代数))"]
    C --> D["bandit 选 LLM(UCB1,按相对改进奖励更新)"]
    D --> E["变异:diff / full rewrite / crossover"]
    E --> F{"novelty 拒绝采样:<br/>嵌入余弦相似度 > 0.95?"}
    F -- 是 --> G["LLM judge 判断「有意义地不同」?"]
    G -- 是 --> H["执行评估:fitness + 文本反馈 + 公开 metrics"]
    G -- 否 --> I["重采样(Reflexion 反馈)"]
    F -- 否 --> H
    H --> J{"改进?"}
    J -- 是 --> B
    J -- 否 --> I
    B --> K["meta-scratchpad:每 T 代总结成功模式"]
    K --> D
    B --> L["输出:最优程序"]
组件详解
档案与岛屿模型:所有评估过的程序带分数与文本反馈入库;档案分成两个岛屿独立进化,岛内最优程序禁止迁移(保护各子群特性),其余程序偶尔跨岛。这层结构直接控制「多样性在哪个粒度被保留」。
Parent sampling:power-law 按排名给概率,一个参数 α 从均匀到 hill climbing 连续调节;weighted 采样把 sigmoid 缩放的性能与「1/(1+子代数)」的 novelty 相乘,惩罚繁殖过度的精英。消融显示 weighted 在 Circle Packing 上最稳。
LLM bandit 与温度:变异从 8 模型池里按 UCB1 概率采样,奖励用相对改进(相对父代与初始程序)归一,适配档案不断变好的非平稳环境;温度在 {0.0, 0.5, 1.0} 里采样。
变异与拒绝采样:diff 定点改、full rewrite 整体重写(程序性保护不可变块)、crossover 合并两个程序;patch 无效时用 Reflexion 反馈重采样。novelty 拒绝采样先用嵌入算余弦相似度,超阈值 η=0.95 再叫 LLM 判断,双重把关把「LLM 提议」变成「受控搜索步骤」。
评估器与反馈回路:多目标评估产出标量 fitness、公开 metrics 与文本反馈,三者都进档案,成为下一轮变异提示的上下文——这是进化经验跨代传递的载体。
Meta-scratchpad:每隔 T 代,把近期成功程序总结成「程序摘要 + 全局洞见 + 实现建议」,追加进变异提示,实现跨代的策略级经验沉淀;它与 bandit 一样作用于「怎么进化」,但论文没有给它独立消融。
与 AlphaEvolve 的分工差异:AlphaEvolve 把多样性管理放在数据库层的 MAP-Elites + 岛屿模型里,变异提议本身少做过滤;ShinkaEvolve 把同一份预算用在采样侧——parent 概率、novelty 拒绝、bandit 选模型——并在任务上证明这种分配在 Circle Packing 上把所需评估从数千次压到约 150 次。它的超参数表(Table 1)完整公开:岛屿 2、阈值 0.95、嵌入 text-embedding-3-small、温度三档、8 模型池,复现门槛明显低于闭源前作。
证据缺口:Figure 9 的三组消融只覆盖 parent sampling、novelty rejection 与 ensemble,meta-scratchpad 与 bandit 的相对贡献没有被单独量化;主结果(Circle Packing)为单次运行图线,多 seed 统计缺失。读架构图时,把「元层机制」和「采样机制」的证据强度分开记。
ShinkaEvolve 总览与 circle packing 样本效率对比
原文 caption:High-level overview of ShinkaEvolve. Left: the framework constructs an archive of evaluated programs, rejection-samples new programs, and evaluates their fitness. Right: ShinkaEvolve provides a sample efficient alternative to AlphaEvolve and outperforms its Circle Packing solution. (caption 精简自原文)
同时展示结构与卖点:左边是「档案 → 拒绝采样 → 评估 → 归档」的循环,右边是样本效率对比——ShinkaEvolve 的曲线在约 150 次评估处越过 AlphaEvolve 解的水平线,而 AlphaEvolve 需数千次评估。读图注意横轴量级差异,这是全篇「sample-efficient」论断的直接证据。
AIME agent scaffold 设计:Pareto 前沿、跨年份与跨模型迁移
原文 caption:ShinkaEvolve for Agent Scaffold Design. Left: ShinkaEvolve discovers a Pareto frontier between performance and LLM query budget. Middle: The discovered scaffold generalizes to unseen AIME problems. Right: The scaffold improves performance regardless of the underlying LLM. (caption 精简自原文)
证明进化出的 scaffold 是通用策略而非模型特定技巧:左图在 2–10 次 LLM 调用预算内找到 Pareto 前沿;中图显示到 2025 年(未见过的题)仍有提升;右图把同一 scaffold 换到 gpt-4.1-mini、gpt-4.1、o4-mini 上,AIME 2024 成绩分别从 44.4%→65.6%、46.7%→65.6%、80.0%→94.4%。读法:三张子图分别回答「效率」「泛化」「迁移」。
组件消融:parent 采样、LLM 集成、novelty 拒绝采样
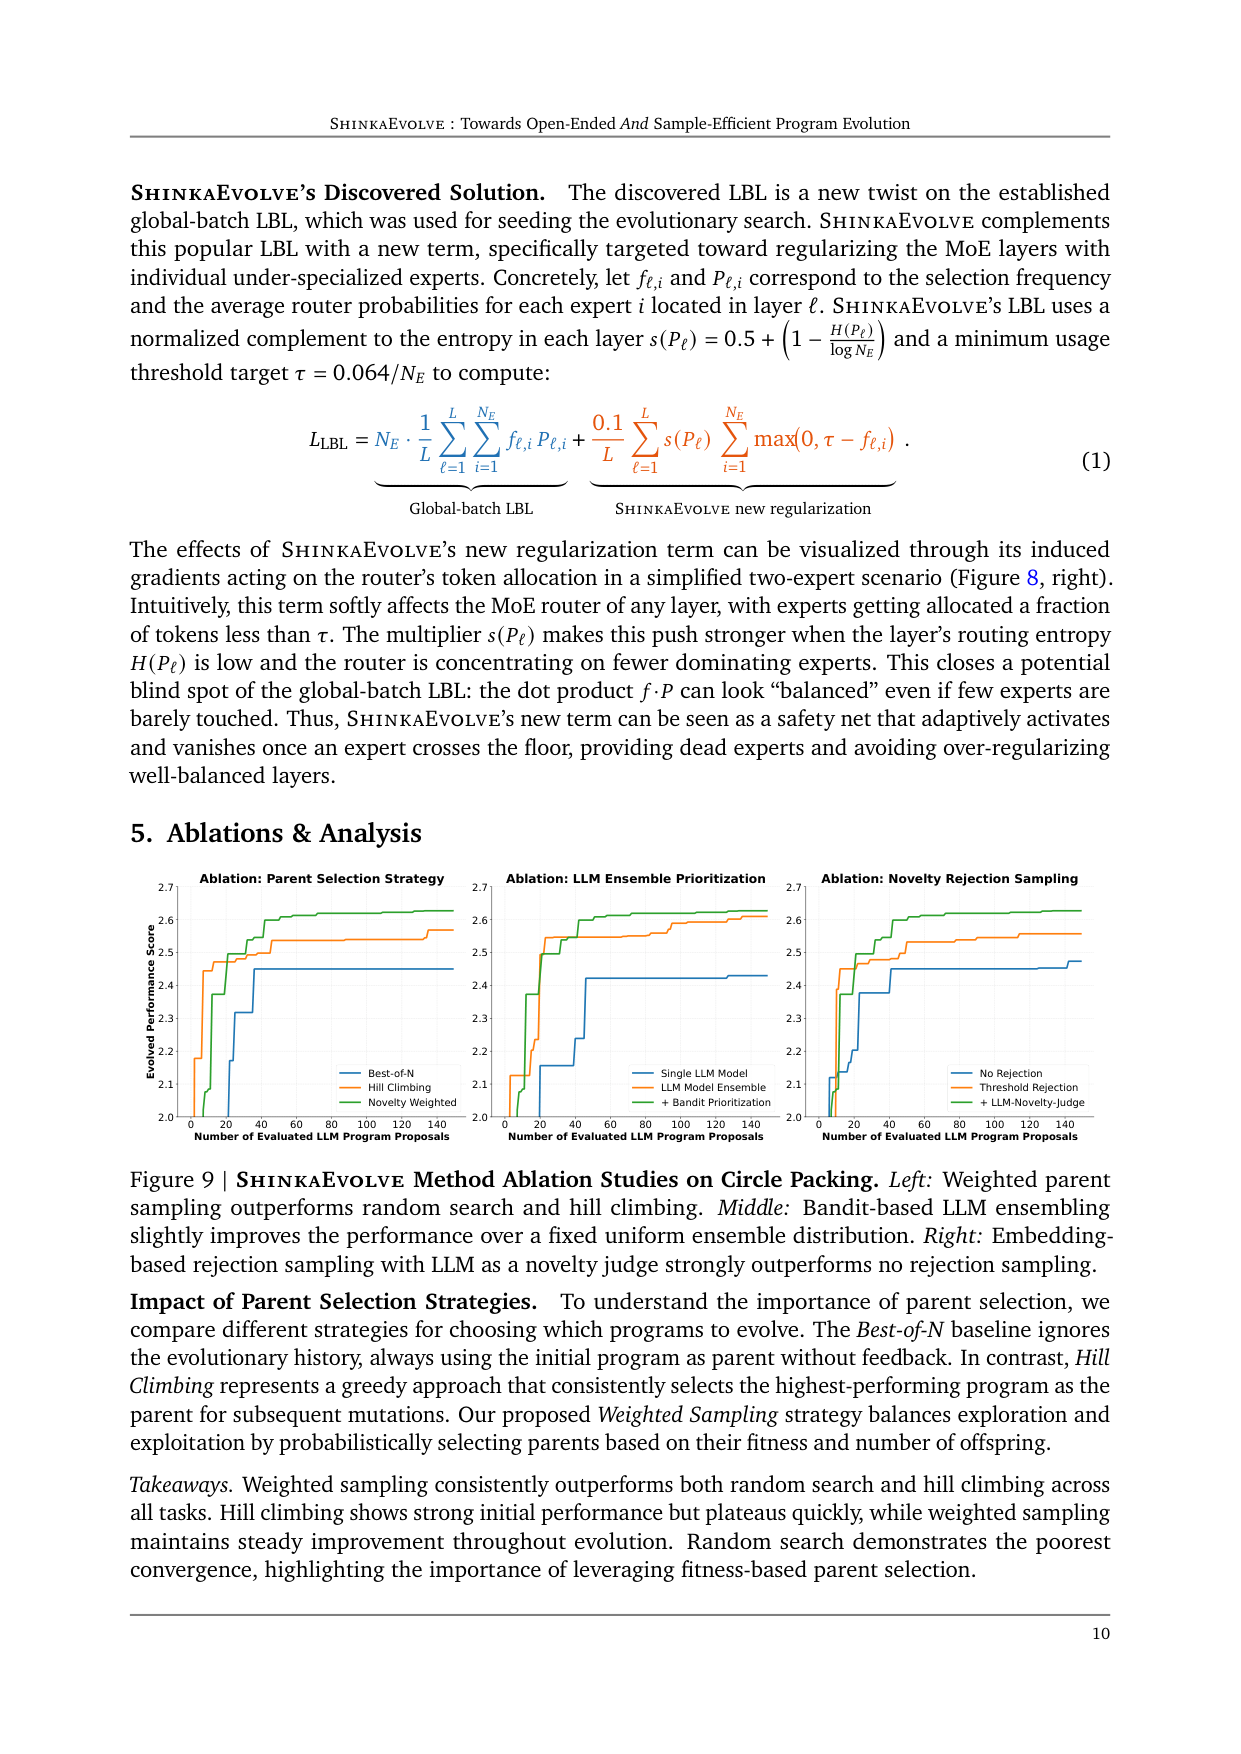
原文 caption:ShinkaEvolve Method Ablation Studies on Circle Packing. Left: Weighted parent sampling outperforms random search and hill climbing. Middle: Bandit-based LLM ensembling slightly improves performance. Right: Embedding-based rejection sampling with LLM as a novelty judge strongly outperforms no rejection sampling. (caption 精简自原文)
逐组件归因:weighted parent 采样稳定优于 hill climbing(后者前期快但早停)与 Best-of-N;novelty 拒绝采样(嵌入阈值 + LLM judge)对最终分数影响最大;bandit 集成只带来小幅提升。读法:三张子图同预算对比曲线高度,回答「哪个组件最该先做」。注意 meta-scratchpad 没有出现在消融里——这是读卡时要留意的证据缺口。
约 150 次评估就超越 AlphaEvolve:ShinkaEvolve 的采样侧工程(对话版)
小播:今天聊 Sakana AI 的 ShinkaEvolve。一句话先给结论:程序进化搜索以前要几千次评估才能找到好解,这篇说,把「选父程序、过滤变异、挑 LLM」这三个采样环节改对,26 圆 circle packing 这个任务,约 150 次程序评估就能超过 AlphaEvolve 的公开解。
老播:而且它全开源,给的超参数表很完整。之前 AlphaEvolve 是闭源的,论文里连数据库种群规模都没写全。
小播:先记第一个记忆锚点:样本效率的瓶颈在采样侧,不在 LLM 本身。
第一段:它要解决什么问题
老播:背景是「用 LLM 当变异算子的进化搜索」。循环本身是标准件:档案存评估过的程序,LLM 生成变异,评估器打分,好程序入库。ShinkaEvolve 的贡献是把三个采样环节做精:第一,parent sampling,决定谁当父代;第二,code-novelty 拒绝采样,决定变异提议够不够新;第三,UCB1 选 LLM 加 meta-scratchpad,决定用哪个模型、沉淀什么经验。
小播:它拿什么任务验证?
老播:四个跨度很大的任务:circle packing 几何优化、AIME 数学推理的 agent scaffold 设计、ALE-Bench 的 AtCoder 启发式竞赛、还有 MoE 模型的负载均衡损失函数。跨度大,是为了说明采样侧工程是通用的。
第二段:机制怎么转
老播:先看 parent sampling 的两条公式。第一种按排名做幂律采样:程序 i 被选中的概率等于它排名的负 α 次方,除以所有程序排名的负 α 次方之和。排名第一的设为 1,α 控制剥削强度——α 等于 0 就是纯随机,α 无穷大就退化成 hill climbing,每次只改最优。
小播:第二种呢?
老播:第二种 weighted 采样,把性能和「子代数」相乘。性能项用 sigmoid 把 fitness 压到中位数附近,子代数项是 1 除以 1 加子代数——子代越少,越优先被再采样。这一项专门防「少数精英垄断繁殖」。
小播:那 novelty 拒绝采样是什么?
老播:LLM 变异常犯的毛病是反复提议近亲变体。ShinkaEvolve 把提议的可变代码用嵌入模型编码,和档案里所有程序算余弦相似度,最大相似度超过 0.95 这个阈值,就叫另一个 LLM 判断这个提议是不是「有意义地不同」,两道关都过才执行。说白了,把 LLM 提议从「来者不拒」变成「受控的搜索步骤」。
小播:第二个记忆锚点:多样性不是靠运气,是靠「parent 概率 + 拒绝采样」两道闸。
小播:档案本身怎么组织?一直存下去不会乱吗?
老播:用了岛屿模型:档案分成两个子群,各自并行进化,每个岛的最优程序禁止迁移,防止好程序把整片搜索空间吸过去;其余程序偶尔跨岛流动,扩散知识。这个设计和 AlphaEvolve 的 MAP-Elites 思路类似,但 ShinkaEvolve 把它和采样侧的三道闸放在一起,并用超参数表全部公开——岛屿数 2、阈值 0.95、嵌入模型 text-embedding-3-small、温度三档、8 个模型的池子,复现门槛低很多。
老播:还有个元层:系统维护 8 个 LLM 的池子,每次变异用 UCB1 选模型,奖励用「相对父代和初始程序的提升」来算,让敢做高风险高收益变异的模型被更多地用;meta-scratchpad 每隔十代把最近的成功程序总结成洞见和建议,追加进变异提示。这两个机制都作用于「怎么进化」。
第三段:关键结果
老播:看数字,全部带 baseline 和 setup。Circle packing,26 个圆装进单位正方形、最大化半径和:ShinkaEvolve 的半径和是 2.6359831,用 1e-6 容差验证器;换 AlphaEvolve 的精确验证器是 2.6359777。此前 SOTA 是 2.634,AlphaEvolve 改进到 2.635。ShinkaEvolve 在约 150 次评估内做到。
小播:AIME 那个呢?
老播:AIME 2024,30 道题,用 gpt-4.1-nano 当底座,每个候选跑 3 次,整个 agent 只允许 10 次 LLM 调用。进化出的 scaffold 拿到 34.4%,单查询基座只有 24.4%,Majority@5 投票是 32.2%。更值钱的是迁移:同一个 scaffold 换到 gpt-4.1-mini 上,从 44.4% 涨到 65.6%;换到 o4-mini 上,从 80.0% 涨到 94.4%。说明进化出来的是通用策略,不绑定模型。
老播:ALE-Bench 那边,10 个 AtCoder 启发式任务,平均分从 1879.3 涨到 1923.5,其中 ahc039 从第 5 名升到第 2 名。MoE 那边,它在 global-batch 负载均衡损失上加了一个「熵加权、惩罚低利用率专家」的正则项,556M 参数的小 MoE 在 21 亿 token 上进化的损失,搬到 27 亿参数、300 亿 token 训练的大模型上,三个权重系数下困惑度和 7 项下游任务全面改善。
小播:消融呢?哪个组件最值钱?
老播:Figure 9 有三组消融:novelty 拒绝采样影响最大,去掉它分数掉得最狠;weighted parent 采样稳定优于 hill climbing;bandit 集成只带来小幅提升。注意这里没有 meta-scratchpad 的消融——这是个证据缺口。
第四段:局限
小播:冷水来了。
老播:四条。第一,meta-scratchpad 和 bandit 的贡献没有独立消融,别把「元层有用」说得太满。第二,ALE-Bench 的改进在算法上贴着初始解,作者自己承认,有过拟合初始化的风险。第三,circle packing 主报告用 1e-6 容差的验证器,切到 AlphaEvolve 的精确验证要多花样本,作者是先跑松弛任务、事后精确化。第四,MoE 实验的进化架构和测试架构很接近、训练预算有限,下游任务还截断到 1000 题;AIME 2023 年的题增益比 2025 年小,作者归因于潜在的数据污染。
小播:第三个记忆锚点:主结果是单次运行的图线,多 seed 统计缺失。
收尾:一句话记住这篇
老播:收尾。ShinkaEvolve 把采样侧工程做成样本效率的杠杆:power-law 和 weighted 的 parent 采样平衡探索与利用,嵌入余弦加 LLM 双重把关的 novelty 拒绝采样控制搜索方向,UCB1 和 meta-scratchpad 利用进化经验。最该记住的数字:约 150 次程序评估,发现 circle packing 新 SOTA,半径和 2.6359831,对照此前最优 2.634。最该记住的缺口:元层组件的独立消融还没做。
小播:这篇值得读,它把「样本效率」从玄学变成了可拆解的工程。我们下期见。