AlphaEvolve:让编码 agent 进化整个代码库,去找科学发现
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。
先看一个现象:4×4 的复矩阵乘法,从 1969 年 Strassen 给出 49 次标量乘法的算法之后,56 年没人改得动。Google DeepMind 的 AlphaEvolve 把这个数压到了 48 次——而且它不是专门为矩阵乘法设计的系统,是一个通用编码 agent:给定评估器和一段初始程序,它用 LLM 当变异算子,进化出更好的程序。这是 2025 年 6 月的 white paper,覆盖矩阵乘法、50 多个数学开放问题,还有 Google 自己的数据中心调度和 TPU 电路。
背景:从 FunSearch 到整库进化
进化式程序搜索的前作是 FunSearch:进化单个 Python 函数,要求评估快(20 分钟内单 CPU),用小模型,靠百万级采样堆结果。AlphaEvolve 把这些限制逐条放开:进化整个代码文件(上百行)、任意语言、评估可以并行跑几小时、用 SOTA 大模型、几千次采样就够。关键是它利用了大模型「读得懂长上下文、能响应反馈」的能力——变异 prompt 里塞满历史程序、评估结果和领域背景。
核心概念:EVOLVE-BLOCK 与「进化搜索算法」
系统怎么知道改哪里?用户用注释标记代码块:
# EVOLVE-BLOCK-START
def heuristic(state): return 0.0
# EVOLVE-BLOCK-END
被标记的块是可变区,其余代码是只读骨架。进化循环每轮:从数据库采样 parent 和 inspirations → 构建富上下文 prompt → LLM 生成 SEARCH/REPLACE diff → 应用得到 child → 用自动评估器打分 → 入库。跑在异步分布式控制器上,吞吐优先。
AlphaEvolve 有个重要设计选择:很多时候进化的对象是「搜索算法」本身,最终解由搜索算法产出。比如找最优构造的数学问题,它进化一个启发式搜索程序,给 1000 秒预算和当前最优解,让它在这段时间里找到更好的构造。于是进化选择的是「擅长改进高质量解的启发式」,系统自动发现了多阶段策略——早期启发式做大增益、后期启发式做精细调优。
再补一个背景细节:为什么「进化搜索算法」比「直接进化解」有效?论文的解释是,很多数学问题的最优构造高度不对称,直接进化构造函数容易卡在局部;而搜索算法可以从小步改进开始,逐步逼近。反过来,对高度对称的问题,进化构造函数更简洁。AlphaEvolve 不预设抽象层级,同一个问题可以换不同方式跑,这也是它通用性的来源之一。
评估端还有两个工程细节值得记住:评估可以跨多个随机初始化并行跑(embarrassingly parallel),把长评估的墙钟时间压下来;数据库同时优化多个分数时,即使只关心单目标,多分数也常带来更好结果——因为不同定义下的优胜程序结构差异大,喂给 LLM 做变异上下文能刺激更丰富的候选。
关键公式:矩阵乘法就是张量分解
矩阵乘法算法等价于矩阵乘法张量的低秩分解。设 $T_{m,n,p}$ 是表示 $m\times n$ 乘 $n\times p$ 矩阵相乘的张量,$E_{i,k}$ 是只在 $(i,k)$ 处为 1 的基矩阵,则:
$$T_{m,n,p} = \sum_{i,j,k} E_{i,k} \otimes E_{k,j} \otimes E_{j,i}$$
一个「用 $R$ 次标量乘法算完」的算法对应一个秩 $R$ 分解:
$$T_{m,n,p} = \sum_{r=1}^{R} u_r \otimes v_r \otimes w_r$$
$u_r, v_r, w_r$ 是三个向量因子,$\otimes$ 是张量积;$R$ 越小,乘法越省。AlphaEvolve 做的就是让 LLM 进化出能找到更小 $R$ 分解的程序——4×4 复矩阵即 $R=48$,对 14 个参数组合刷新了上界。
关键结果:56 年未动的数被动了
矩阵乘法:⟨4,4,4⟩ 从 49 到 48(Table 2);全部 $m,n,p \le 5$ 参数匹配或超越已知最优,其中 14 个刷新上界。数学:50+ 个开放问题里约 75% 匹配已知最优、约 20% 超越 SOTA,包括 Erdős 最小重叠问题与 11 维 Kissing Number。工程:给数据中心进化出更高效的调度启发式、给 TPU 找到功能等价的电路简化、优化了训练 Gemini 的 kernel tiling 启发式与 attention 运行时。
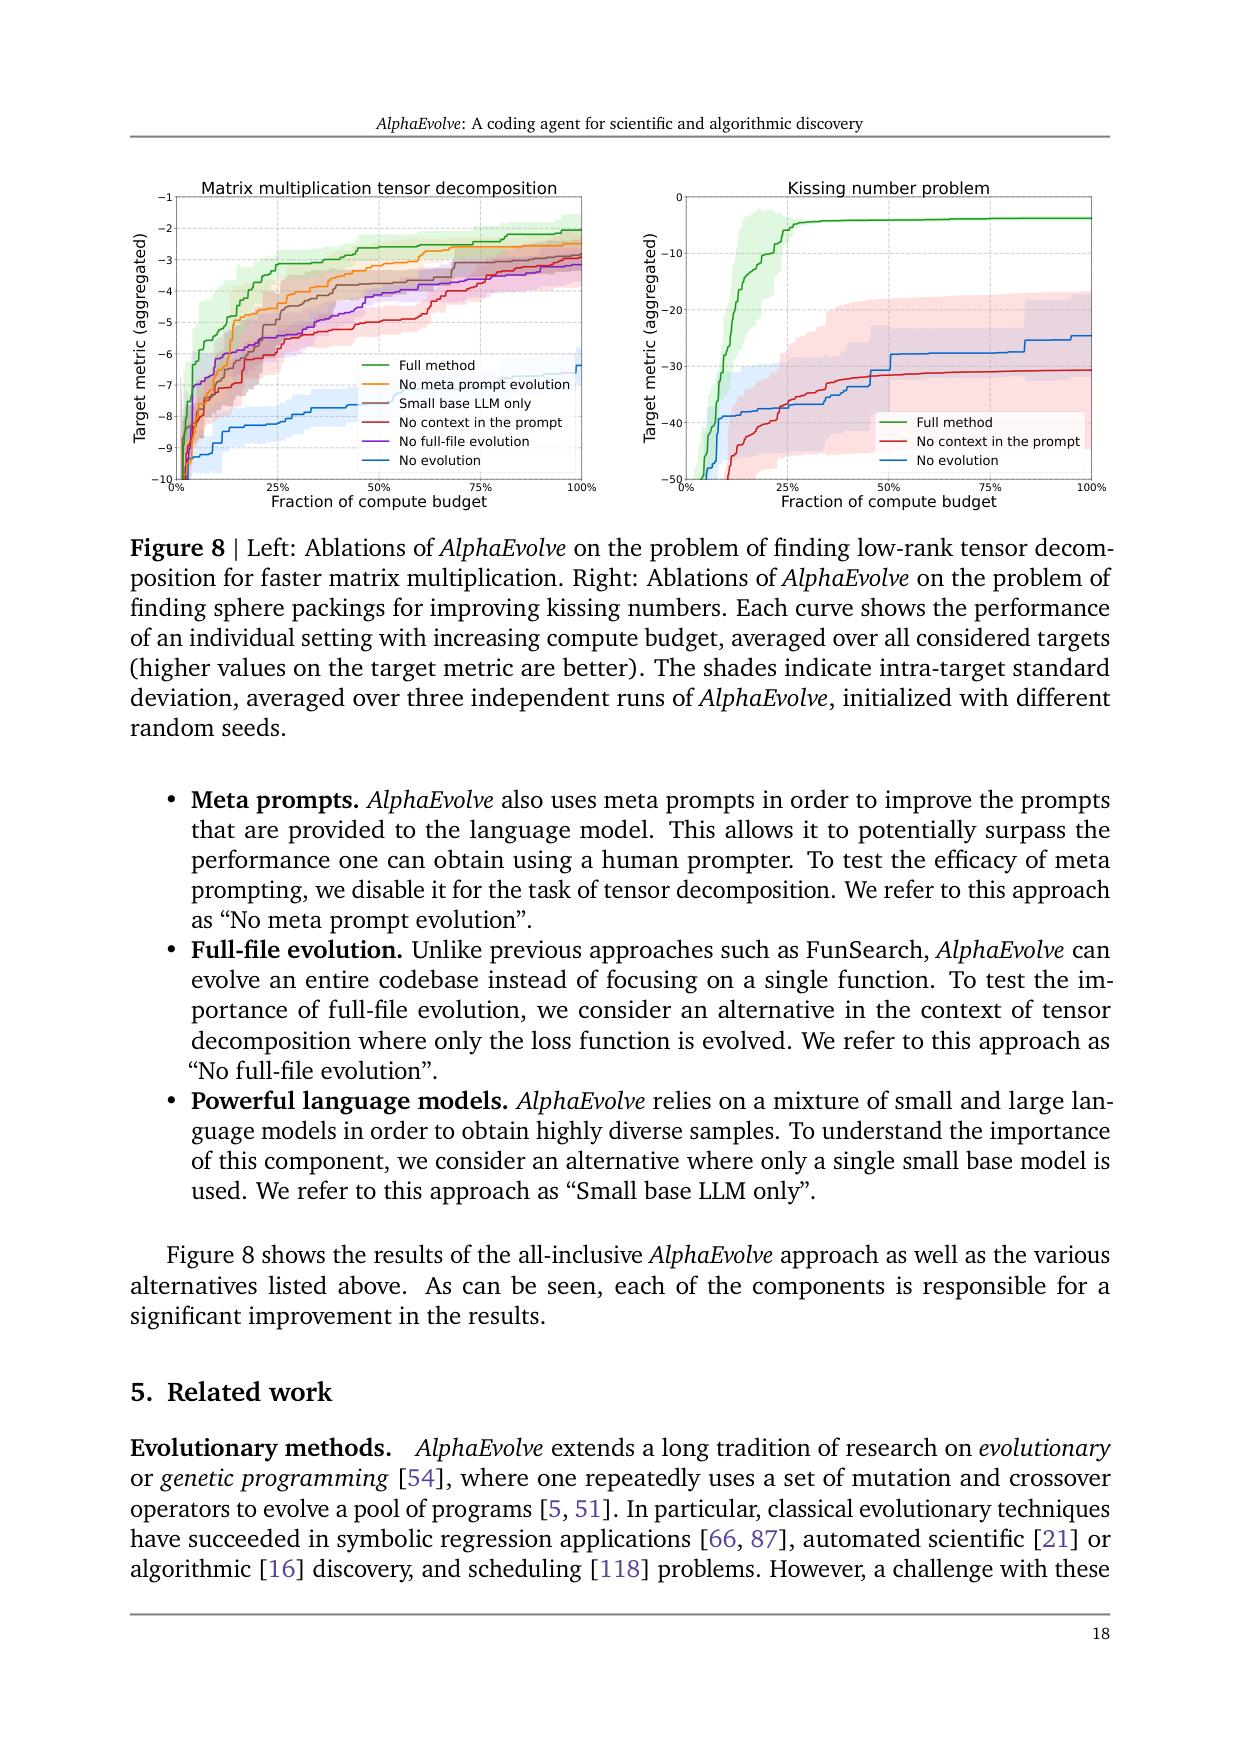
消融实验(Fig.8)把组件逐个去掉:不做 meta-prompt 进化、只用小基座 LLM、不给历史上下文、不做全文件进化,指标都明显变差——每个设计选择都有可测贡献。
局限:边界在「可自动评估」
四条。第一,系统只适用于能自动评估的任务——作者自承这是 white paper 的边界,需要人工实验判断的问题出局。第二,数据库管理细节未公开(population size 等),复现依赖社区实现 OpenEvolve。第三,工程收益多是定性报告,调度、电路、kernel 的具体提升数字没有全部量化公开。第四,评估器脆弱性没被对抗性检验——进化可能钻评估器漏洞,作者用代码执行和自动验证来 grounding,但没有系统性防御。另外单个评估可达约 100 compute-hours,总预算未公开,复现门槛高。
一句话记住这篇
AlphaEvolve 把「要改进的程序」标进代码块,让 LLM 生成 diff 进化整个代码库、自动评估器把关,把进化程序搜索从玩具带进科学发现。最该记住的数字:4×4 复矩阵乘法从 49 次降到 48 次标量乘法,56 年来的首次改进;最该记住的边界:一切成立的前提是评估能自动判定。
把「要改进的程序」用 # EVOLVE-BLOCK 标进代码,让 LLM 生成 diff 进化整个代码库、由自动评估器把关:在矩阵乘法上首次改进 Strassen 的 4×4 复矩阵算法(49→48 次标量乘法,56 年来的首个改进),并在 50+ 个数学开放问题上约 75% 打平已知最优、约 20% 超越 SOTA。
问题
要解决什么:把科学发现与工程优化变成可自动评估的算法搜索:给定评估器与初始程序,让编码 agent 持续生成、批评、进化候选程序。
为什么 prior work 不够:FunSearch 等前作只进化单个函数、限 Python、需快速评估、用小模型;AlphaEvolve 要进化整个代码库、支持多语言与长时并行评估、并用 SOTA LLM 的反馈能力跨出局部改进。
进化循环(搜索空间 → 算子 → 评估 → 选择)
搜索空间(什么被进化):完整代码文件;用户用 # EVOLVE-BLOCK-START / # EVOLVE-BLOCK-END 注释标注可变区,其余代码为只读骨架。任意语言(Python 为主,也用于 TPU kernel、电路描述等);可进化搜索算法本身而非直接进化解。
变异/提案算子:
- LLM 生成 SEARCH/REPLACE diff 应用到 parent program
- prompt sampler 从数据库采样 prior programs 与 inspirations 构建富上下文(含评估结果、随机格式模板)
- meta-prompt 进化:改进提供给 LLM 的提示模板本身
- 多 LLM 集成:小+大模型混合采样提升多样性
- 论文未给出:meta-prompt 进化的详细机制与各算子的配比
评估方式:用户提供 evaluate 函数 h:solution → 标量 metrics 字典,可自动判定;评估可并行、可耗时数小时(论文提到约 100 compute-hours 量级);数学问题用属性检查验证器(如图的约束检查);矩阵乘法用 tensor rank 验证并附可复现 Colab。论文未给出:评估器鲁棒性/被钻空子的对抗性分析。
选择与归档:evolutionary database 用 MAP-Elites 与岛屿模型的思路管理:按分数与多样性保留/淘汰;可同时优化多个分数(多分数反而常改善单目标)。数据库具体规模论文未公开(社区实现 OpenEvolve 用 population=70)——如实标注。
自我改进程度:L1+(固定 LLM 权重):代码 harness 自进化 + meta-prompt 共同进化,属于「改进如何改进」的元层自引用;但评估器、数据库管理、parent 采样机制固定、不可进化。论文未给出:这些固定组件放开后的行为分析。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|
输出
| 名称 | 类型 | 说明 |
|---|
数据集
| 数据 | 规模 | 备注 |
|---|
架构(摘要)
主干与结构
backbone:
参数:
类型:
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| 4×4 复矩阵乘法所需标量乘法次数 | 48 次 | 此前最优 49 次(Strassen 1969 年起 56 年未改进) | ⟨4,4,4⟩ 矩阵乘法张量分解;算法经自动验证并公开在 Google Colab;Table 2(§3.1) |
| 改进的矩阵乘法算法数量 | 14 个参数组合刷新上界(⟨2,4,5⟩ 33→32、⟨3,4,7⟩ 66→63、⟨4,4,8⟩ 98→96 等) | 各参数此前 best known(文献引用) | 全部 m,n,p≤5 的参数组合,匹配或超越已知最优;Table 2(§3.1) |
| 数学开放问题命中率(50+ 个问题) | 约 75% 匹配已知最优;约 20% 超越 SOTA | 此前已知最优构造(多个数学分支) | 分析/组合/数论/几何等 5+ 分支;初始点为简单或随机构造;§3.2 |
| 代表性新结果 | 改进 Erdős 最小重叠问题与 11 维 Kissing Number 的构造 | 此前最优构造 | 自动验证器确认属性后发布;§3.2 与 Figure 5 |
| 工程应用(Google 计算栈) | 数据中心调度启发式、TPU 算术电路等价简化、Gemini 训练 kernel 的 tiling 启发式、attention 运行时优化 | 原有手工/搜索调优方案 | 四个真实生产层;定量收益未全部公开,论文以定性描述为主(§3.3) |
| 组件消融(矩阵乘法与 Kissing Number) | 全方法显著优于去掉任一组件:meta-prompt 进化、大模型集成、富上下文、全文件进化 | 去掉对应组件的变体 | 3 个随机种子的独立运行、按 compute 预算对比聚合目标指标;Figure 8(§4) |
Insights
- 进化对象抽象到「代码块」:EVOLVE-BLOCK 标注让系统能进化整个代码库的多组件协同,跨出 FunSearch 的单函数边界。
- 进化搜索算法而非直接进化解,让系统自动发现多阶段策略——早期启发式做大增益、后期启发式做精细调优。
- meta-prompt 进化把「如何提示 LLM」也纳入优化,理论上可超过人类 prompter(消融中该组件贡献显著)。
- 多分数同时优化常改善单目标结果:不同评估准则下优胜的程序结构差异大,作为变异上下文刺激了多样性。
- 自动评估是前提也是边界:可判定性决定了 AlphaEvolve 的适用范围(数学/CS/系统优化),也决定了评估器脆弱性风险没有在论文内被对抗性检验。
vs 同类工作
- 相
- 比
- F
- u
- n
- S
- e
- a
- r
- c
- h
- (
- 单
- 函
- 数
- 、
- P
- y
- t
- h
- o
- n
- 、
- 快
- 速
- 评
- 估
- 、
- 小
- 模
- 型
- 、
- 百
- 万
- 级
- 采
- 样
- )
- ,
- A
- l
- p
- h
- a
- E
- v
- o
- l
- v
- e
- 进
- 化
- 整
- 个
- 代
- 码
- 文
- 件
- 、
- 任
- 意
- 语
- 言
- 、
- 可
- 并
- 行
- 评
- 估
- 数
- 小
- 时
- 、
- 用
- S
- O
- T
- A
- L
- L
- M
- 、
- 数
- 千
- 次
- 采
- 样
- 即
- 可
- ,
- 并
- 支
- 持
- 多
- 指
- 标
- 与
- m
- e
- t
- a
- -
- p
- r
- o
- m
- p
- t
- 进
- 化
- ;
- 相
- 比
- A
- l
- p
- h
- a
- T
- e
- n
- s
- o
- r
- (
- 专
- 用
- 矩
- 阵
- 乘
- 法
- )
- ,
- A
- l
- p
- h
- a
- E
- v
- o
- l
- v
- e
- 是
- 通
- 用
- 系
- 统
- 但
- 同
- 样
- 刷
- 新
- 了
- 4
- ×
- 4
- 复
- 矩
- 阵
- 乘
- 法
- 上
- 界
- 。
局限
- 适用范围限于可自动评估的任务(作者自承);需要手工实验判断的任务(如部分实证科学)出局。
- 程序数据库的管理算法只给了 MAP-Elites + 岛屿模型的定性描述,population size 等参数未公开,复现依赖社区实现(OpenEvolve)。
- 数学新结果的独立验证成本高:作者提供 Colab 与证明,但论文正文未逐条展开;48 次乘法的算法对应张量分解、可递归放大,而存在更少乘法但不可递归的算法(论文脚注),边界易被误读。
- 工程收益(调度、电路、kernel)以定性描述为主,具体提升数字未量化公开,难以独立评估。
- 单个评估可达约 100 compute-hours,总进化预算未公开,复现门槛高;论文为 white paper,未提供完整开源 pipeline。
- 评估器脆弱性未做对抗性检验:进化可能钻评估器漏洞而非真正改进算法,论文靠「代码执行 + 自动验证」grounding 缓解但没有系统性防御。
可复现性
所有数学结果(含 48 次乘法分解、Kissing Number、最小重叠等)在 google-deepmind/alphaevolve_results 的 Colab 中公开;方法论在 white paper 中描述;完整进化 pipeline 未开源(社区实现 OpenEvolve 可作近似)。评估器与初始程序由用户在任务定义中提供。
AlphaEvolve 架构:整库进化的数据流
flowchart TD
    A["用户输入:初始程序(EVOLVE-BLOCK 标注可变区)+ evaluate 评估代码 + 配置"] --> B["程序数据库(MAP-Elites + 岛屿模型)"]
    B --> C["prompt sampler:采样 parent 与 inspirations,构建富上下文"]
    C --> D["LLM 集成(小+大模型):生成 SEARCH/REPLACE diff"]
    D --> E["apply_diff:应用 diff 得到 child 程序"]
    E --> F["评估器池:evaluate 打分(可并行、可数小时)"]
    F --> G{"分数/多样性达标?"}
    G -- 是 --> B
    G -- 否 --> H["丢弃 / 保留为低分记录"]
    B --> I["meta-prompt 进化:改进提示模板"]
    I --> C
    F --> J["输出:最佳程序 + 评估结果"]
组件详解
任务定义层:用户提供三样东西——含 EVOLVE-BLOCK 标注的初始程序(可变区可退化到单行常数函数)、评估函数 evaluate(solution → 标量 metrics 字典,约定最大化)、可选配置(背景知识、随机格式模板)。边界清晰:可进化区由注释显式圈定,骨架只读。
程序数据库:进化记忆体,存「程序 + 评估结果 + 反馈文本」。管理算法混合 MAP-Elites(按行为特征归档保多样性)与岛屿模型(多子群并行、偶发迁移)。数据库同时承担「未来变异的灵感来源」:采样的 prior programs 直接进 prompt。
Prompt sampler 与 LLM 集成:变异 prompt 由「系统指令 + 历史程序 + 它们的评估结果 + 领域背景 + 随机格式模板」组成;小+大模型混合采样保证候选多样性。meta-prompt 进化把提示模板本身当作可优化对象,构成一层自引用。
评估器池:evaluate 是唯一真值来源。评估可并行(多随机初始化)、可耗时(约 100 compute-hours 量级)。论文强调用代码执行与自动验证 grounding,避免基础 LLM 的错误建议直接进入结果。
进化循环:分布式控制器异步调度,吞吐优先于单次延迟。每个完成节点写回数据库,数据库重排后决定保留/淘汰,形成「候选 → 评估 → 选择 → 归档 → 再变异」的闭环。
与 FunSearch 的关键差异:单函数 → 整文件;快速单 CPU 评估 → 长时并行评估;小模型百万采样 → SOTA 模型数千采样;单指标 → 多指标;无上下文 → 富历史上下文 + meta-prompt 进化。
为什么数据库采样很重要:AlphaEvolve 强调「平衡探索与利用」——总改当前最优会过早收敛,只保留新程序会丢失 stepping stones。MAP-Elites 的行为特征划分与岛屿模型的隔离-迁移,让不同策略的程序各自存活、偶尔交叉,是它能发现「多阶段自适应搜索策略」的结构保证:早期启发式从随机初始点做大增益,后期启发式在近最优解上做精细调优,两类程序在库里共存并被分别采样。
评估器鲁棒性:系统把评估器当作不可置疑的真值,进化压力可能钻评估漏洞。论文用「代码执行 + 属性自动验证」缓解(数学结果还要过独立验证器),但没有对抗性检验;读者评估其结论时,应把「评估器是否可靠」作为第一检查点。
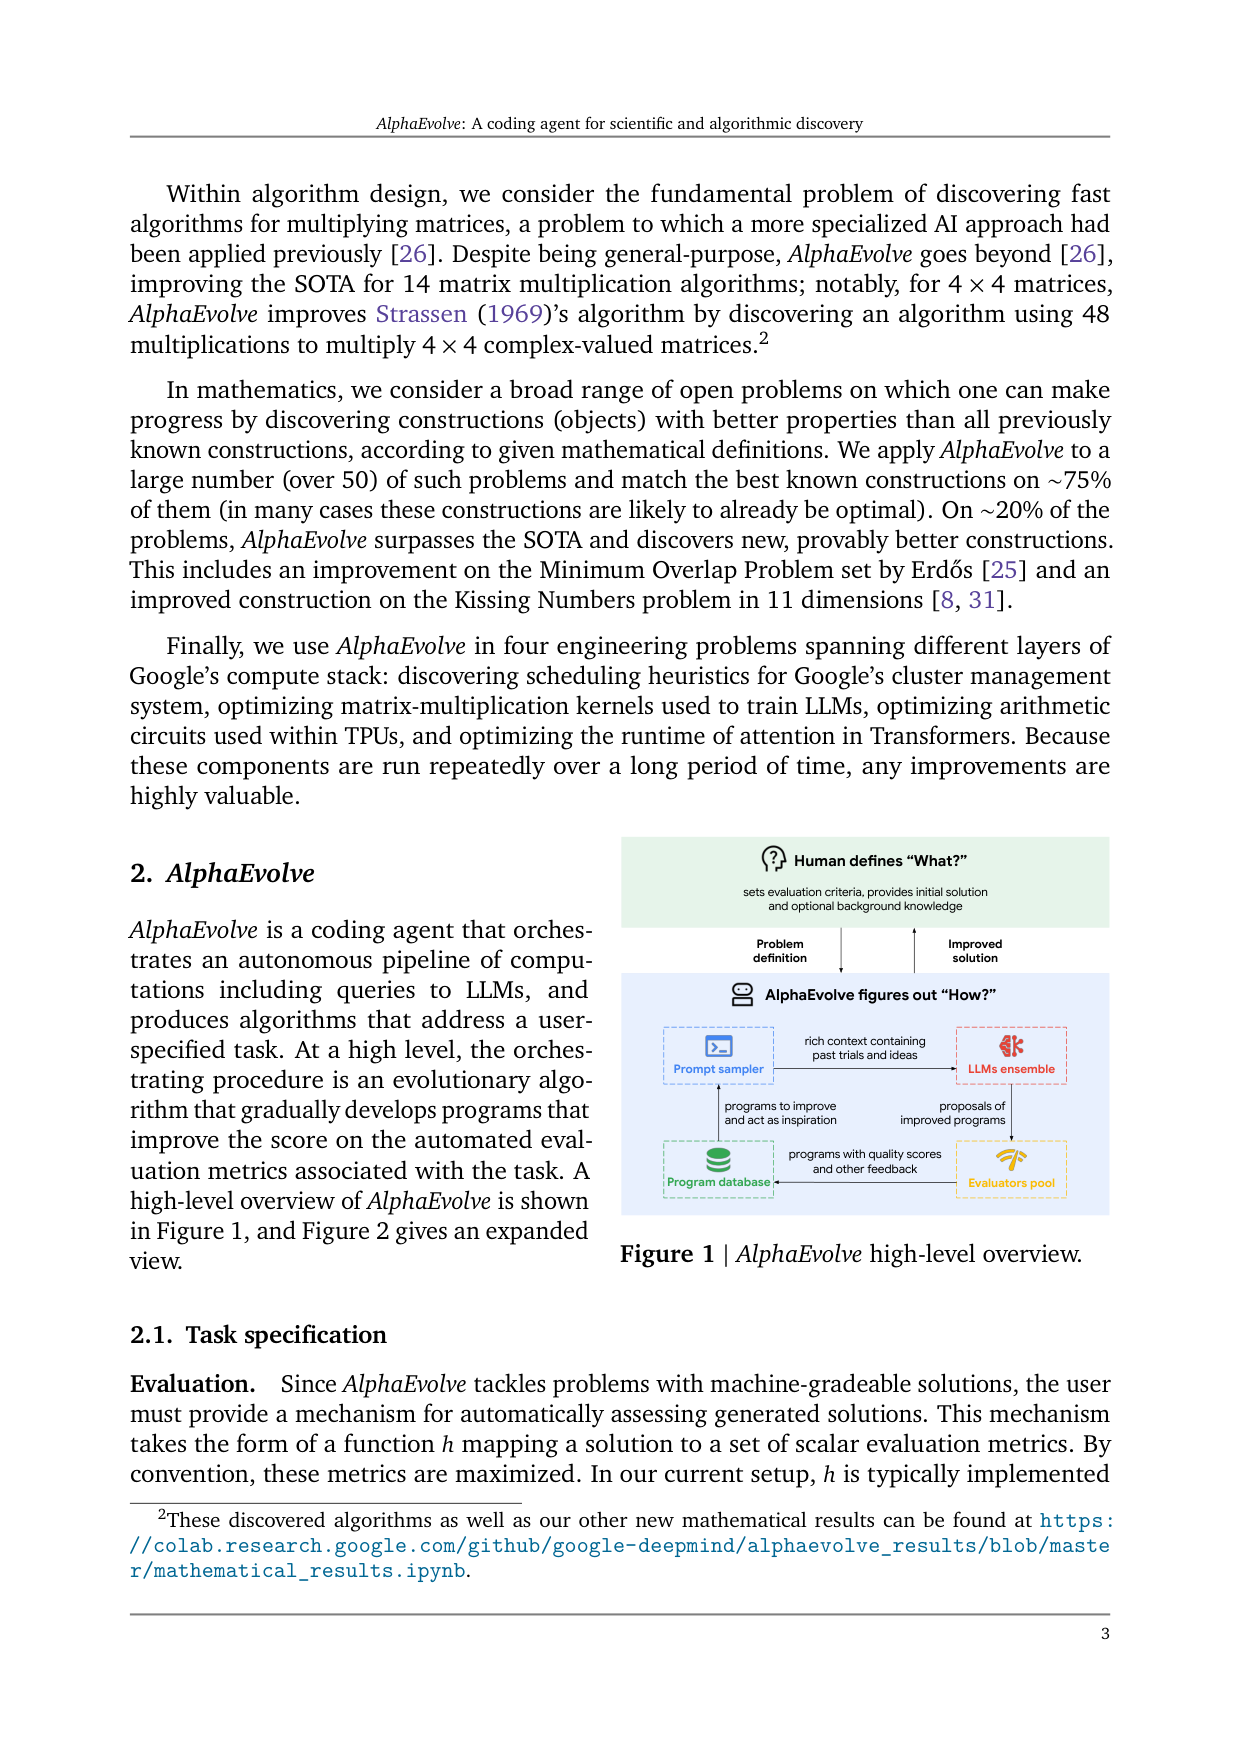
AlphaEvolve 高层总览:人类定 What,系统定 How
原文 caption:AlphaEvolve high-level overview. Human defines 'What?' — sets evaluation criteria, provides initial solution and optional background knowledge. AlphaEvolve figures out 'How?' (caption 精简自原文)
确立分工边界:人类只提供评估标准、初始解与背景知识(What),AlphaEvolve 用 LLM 集成 + prompt sampler + 评估器池 + 程序数据库跑进化循环(How)。读图注意「rich context containing past trials and ideas」这条回流——历史尝试是变异上下文的一部分,这是它能跨出局部改进的结构原因。
分布式进化循环:数据库采样 → 构建提示 → 生成 diff → 评估 → 入库
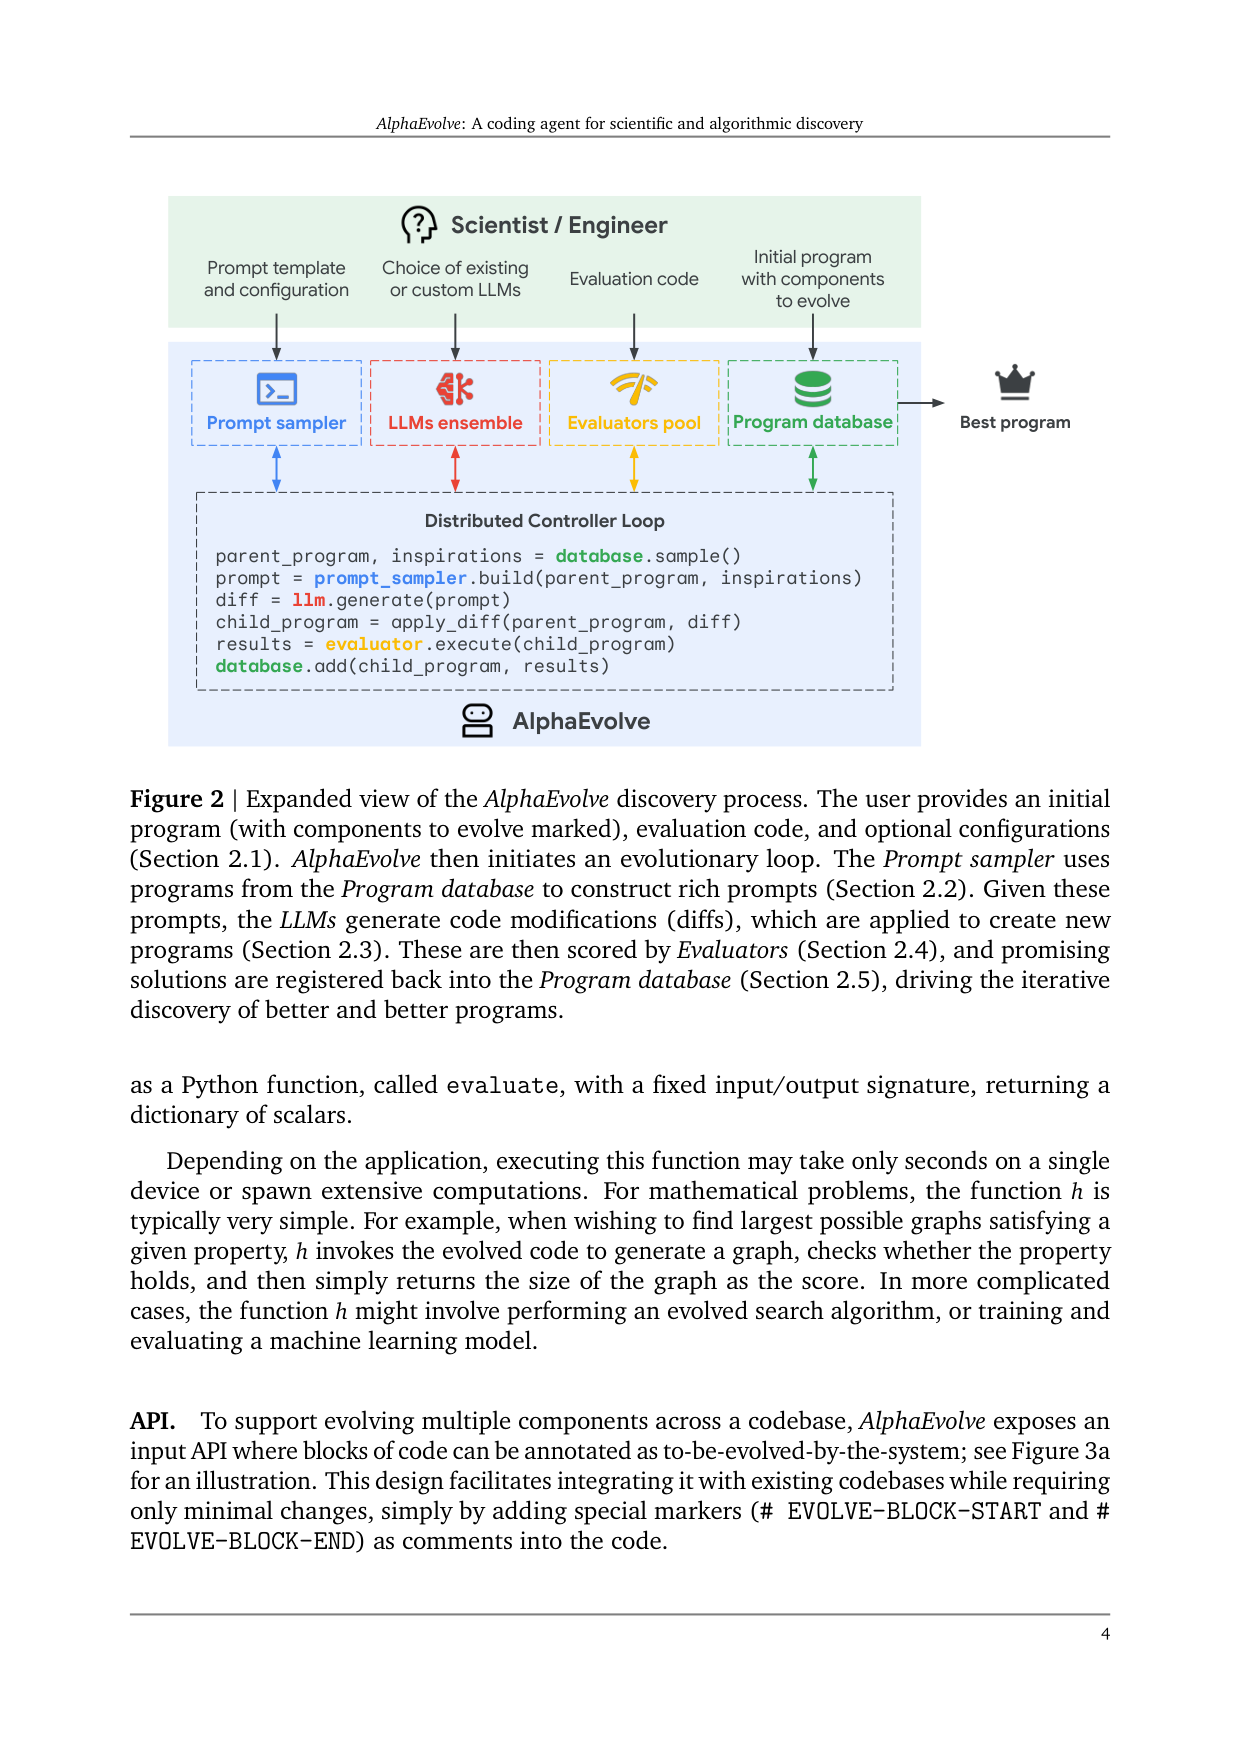
原文 caption:Expanded view of the AlphaEvolve discovery process. The user provides an initial program (with components to evolve marked), evaluation code, and optional configurations. (caption 精简自原文)
给出可落地的循环实现:分布式控制器异步调度 parent 采样、prompt 构建、LLM diff 生成、评估执行与数据库入库。读法:逐节点走一圈就能看清每个环节的输入输出;与 FunSearch 的区别藏在「prompt sampler」与「LLMs ensemble」两个节点——长上下文与多模型是富反馈的来源。
消融:矩阵乘法与 Kissing Number 任务的组件贡献
原文 caption:Ablations of AlphaEvolve on the problem of finding low-rank tensor decomposition for faster matrix multiplication (left) and sphere packings for improving kissing numbers (right). (caption 精简自原文)
证明每个组件都有可测贡献:去掉 meta-prompt 进化、只用小基座 LLM、去掉上下文、不做全文件进化,目标指标都明显变差。读法:同预算横截面对比曲线高度,注意消融在矩阵乘法与 Kissing Number 两个任务上结论一致,说明组件价值跨问题成立。
56 年没人改动的矩阵乘法,被一个编码 agent 动了(对话版)
小播:今天聊一篇 Google DeepMind 的 white paper,AlphaEvolve。一句话先给结论:一个通用的编码 agent,用进化算法搜程序,把 4×4 复矩阵乘法的标量乘法次数,从 1969 年 Strassen 算法保持至今的 49 次,压到了 48 次——56 年来的首次改进。
老播:而且它不是专门做矩阵乘法的系统。同一个系统还去解了 50 多个数学开放问题,其中大约两成超越了已知最优;还给 Google 自己的数据中心进化了调度启发式、给 TPU 简化了电路。
小播:先记第一个记忆锚点:它进化的对象是「程序代码」,不是模型权重,也不是提示文本。
小播:48 次对 49 次,就差一次,为什么这么重要?
老播:因为这是张量分解意义上的下界压缩。矩阵乘法算法可以等价成一个张量的低秩分解,秩就是标量乘法次数,秩越小、算法越省。4×4 复矩阵这个档位,从 1969 年到现在所有团队都在 49 次这个数上碰壁,AlphaEvolve 是第一个把它压下去的系统。论文里也写了脚注:存在少于 49 次但不对应张量分解的算法,那些不能递归放大,所以 48 次的意义在于它是「可递归」的分解结果。
第一段:它要解决什么问题
老播:背景是「用 LLM 做科学发现」。前作 FunSearch 的思路是进化单个 Python 函数,但它限制多:只能改一个函数、只能跑 Python、评估必须快、靠百万级采样堆结果。AlphaEvolve 把这些限制逐条放开:进化整个代码文件,任意语言,评估可以并行跑几小时,用 SOTA 大模型,几千次采样就够。
小播:凭什么能跨出这些限制?
老播:因为它把大模型「读得懂长上下文、能响应反馈」的能力用起来了。变异提示里塞满历史程序、它们的评估结果、领域背景,LLM 生成的是一段代码修改建议,从零写程序的负担被省掉了。
第二段:循环怎么转
老播:先看怎么划定进化边界。用户在代码里用注释标出可变区,一对标记,叫 EVOLVE-BLOCK-START 和 EVOLVE-BLOCK-END,中间的内容可以被改,外面是只读骨架。标完,进化循环就转起来了:从数据库采样父程序和灵感程序,构建富上下文提示,LLM 生成 SEARCH/REPLACE 的 diff,应用得到子程序,自动评估器打分,合格的入库。
小播:数据库管什么?
老播:它是进化记忆体,存程序和评估结果,用 MAP-Elites 加岛屿模型的思路管理——按行为特征归档保多样性,多子群并行、偶发迁移。还有个细节:论文会同时优化多个分数,结果常常是连单目标也变好了,因为不同定义下的优胜程序结构差异大,喂给 LLM 做变异上下文能刺激更丰富的候选。
小播:还有个「meta-prompt 进化」是什么?
老播:就是提示模板本身也参与进化。给 LLM 的变异提示长什么样,由系统自己改进,理论上可以超过人类写提示的水平。消融实验里,去掉这一块指标会明显掉档。
小播:第二个记忆锚点:进化的是「搜索算法」本身,不直接进化答案。
老播:对,这个很关键。很多数学问题的解是高度不对称的构造,直接进化构造函数容易卡住;AlphaEvolve 改成进化一个启发式搜索程序——给它 1000 秒预算和当前最优解,让它在这段时间里找到更好的。于是进化选择的是「擅长改进高质量解的启发式」,系统自动发现了多阶段策略:早期启发式做大增益,后期启发式做精细调优。
第三段:关键结果
老播:看数字,全部带 baseline 和 setup。矩阵乘法:4×4 复矩阵,48 次标量乘法,对照 Strassen 1969 年的 49 次;全部 m、n、p 不超过 5 的参数组合匹配或超越已知最优,其中 14 个刷新上界。数学:50 多个开放问题,约 75% 匹配已知最优,约 20% 超越 SOTA,包括 Erdős 的最小重叠问题和 11 维 Kissing Number。工程:数据中心调度、TPU 电路、Gemini 训练 kernel 的 tiling 启发式、attention 运行时,四项都有产出。
小播:这些结果的可靠性怎么保证?
老播:论文强调「代码执行加自动验证」是地基——评估器把候选程序跑起来、检查属性,数学结果还要过独立验证器,并且公开在 Colab 里可以复现。消融实验也做了:去掉 meta-prompt 进化、只用小基座 LLM、不给历史上下文、不做全文件进化,指标都明显变差,说明每个设计选择都有贡献。
第四段:局限
小播:那工程那块,比如数据中心调度,具体是怎么进化的?
老播:调度启发式在 AlphaEvolve 里就是一段可替换的代码:给定集群状态,它决定任务怎么排队、怎么抢占。Google 的集群管理系统天天跑,哪怕提升几个百分点,乘以全公司的规模都是巨大收益。TPU 电路那边是找功能等价的简化——少一个逻辑门都是钱。这些应用论文只给了定性描述,具体数字没有全部公开,我们读的时候要留个心眼。
小播:冷水。这套东西哪里不行?
老播:第一,适用范围卡在「能自动评估」——需要人工实验判断的任务直接出局,这是作者自己划的边界。第二,数据库的管理细节,比如种群规模,论文没公开,复现要靠社区实现。第三,工程收益大多是定性描述,调度、电路、kernel 的具体提升数字没有全部量化。第四,评估器脆弱性没有对抗性检验:进化压力可能钻评估漏洞,比如让程序在评估函数里作弊,作者靠执行和验证来兜底,但没有系统性防御。另外单个评估可能耗到一百个 compute-hours,总预算没公开,复现门槛不低。
小播:第三个记忆锚点:一切成立的前提是「评估能自动判定」,评估器可靠是读这篇的第一检查点。
收尾:一句话记住这篇
老播:收尾。AlphaEvolve 把「要改进的程序」用注释标进代码块,让 LLM 生成 diff 进化整个代码库、自动评估器把关,把进化程序搜索从玩具带进科学发现。最该记住的数字:4×4 复矩阵乘法从 49 次降到 48 次标量乘法,56 年来的首次改进。最该记住的边界:它适用的一切,都建立在评估可自动判定之上。
小播:这篇值得读,它是「系统本身是优化目标」在科学发现领域的一次实弹演习。我们下期见。