Self-Harness:让 agent 自己改自己的 harness
> 量子位技术拆解 · 模型固定、评估器固定,只有 harness 在进化。完整结构化数据见「速查」tab。
先看一个现象:同一个大模型,配上不同的 harness(system prompt、工具、验证规则、恢复策略),表现可以差很多。但 harness 长期靠人类专家手工设计——每个新模型出来都要重新调一遍,因为不同模型的失败模式差别很大。上海人工智能实验室的这篇论文(arXiv 2606.09498)提出一个更激进的做法:让被固定模型自己改进自己运行所依赖的 harness,不靠人类工程师,也不靠更强的外部 agent。
核心思想:三阶段闭环
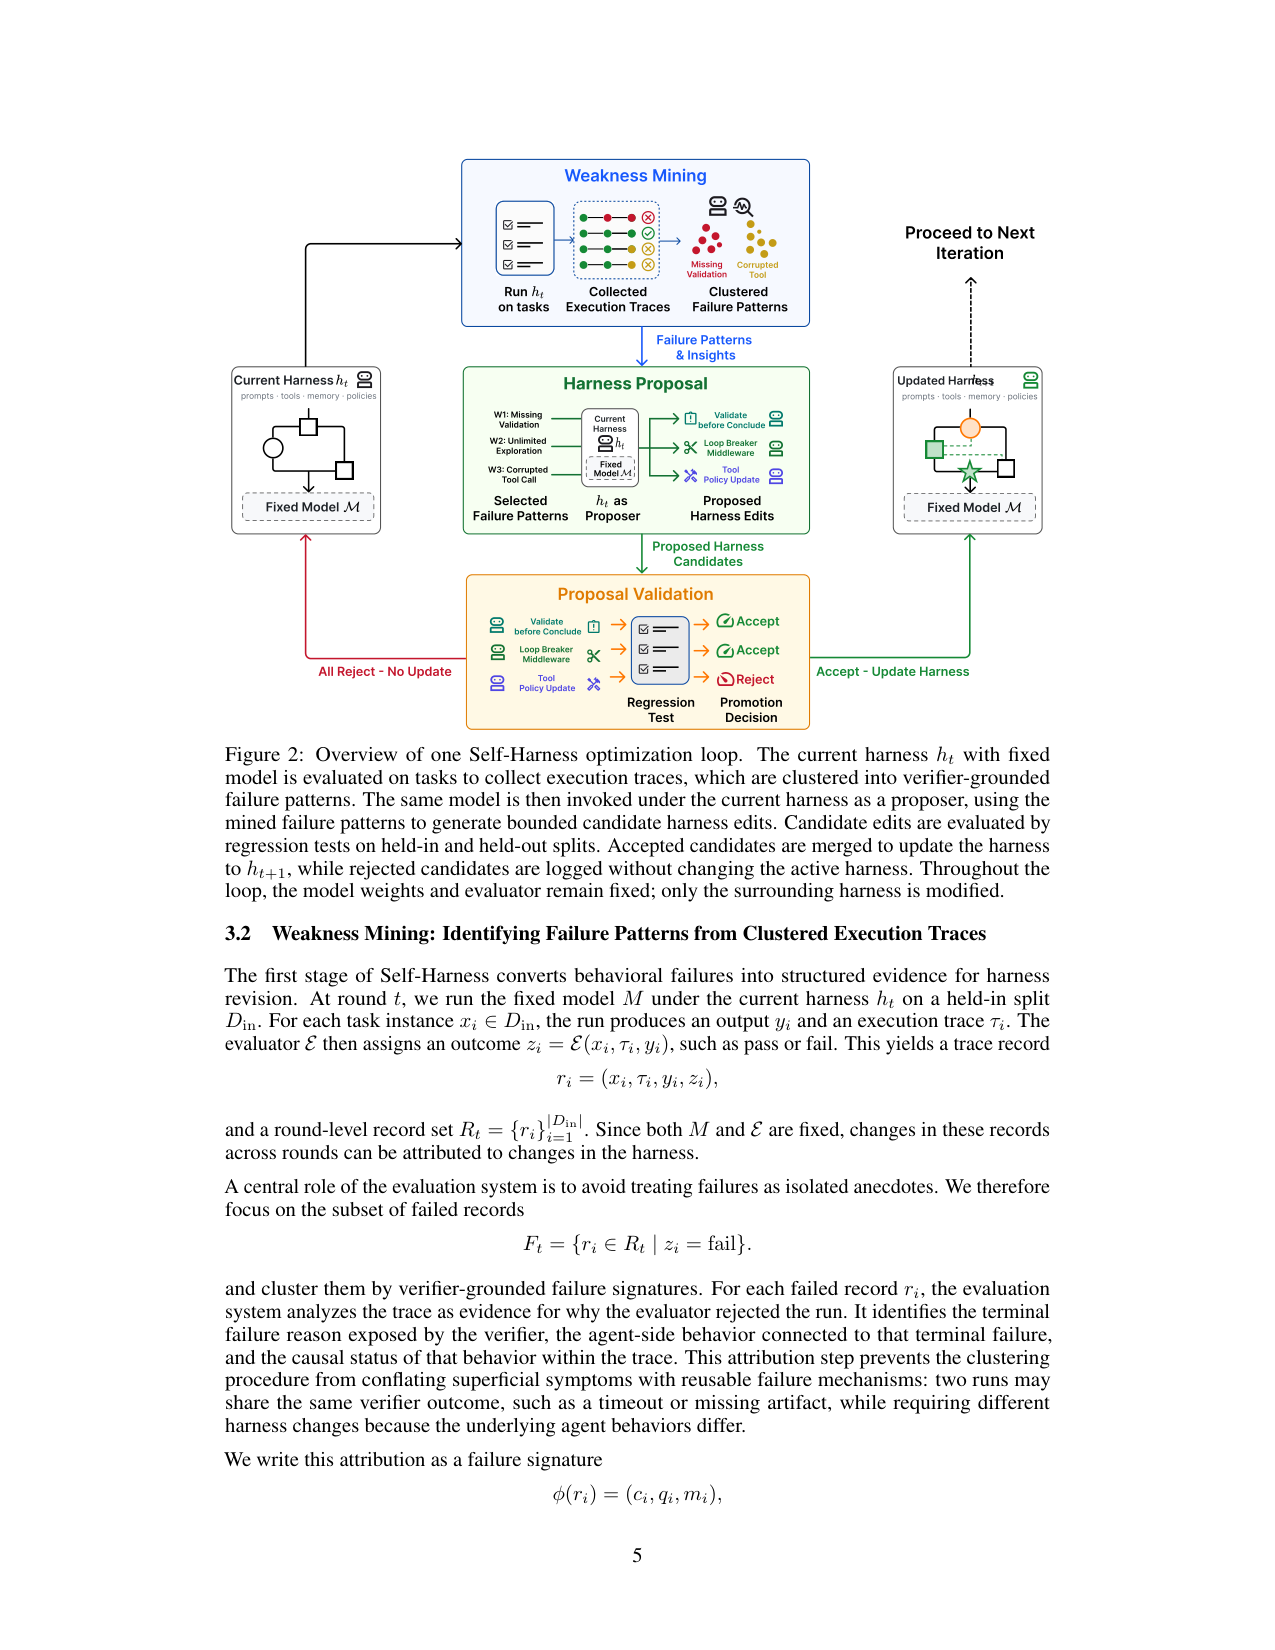
Self-Harness 把一次 harness 进化拆成三个阶段。Weakness Mining(弱点挖掘):用当前 harness 在任务集上跑固定模型,产出执行轨迹与 verifier 判定;失败轨迹按 verifier-grounded 签名
$$\phi(r_i) = (c_i,\, q_i,\, m_i)$$
聚类——$c_i$ 是 verifier 最终拒绝的原因,$q_i$ 是该行为在失败中的因果地位,$m_i$ 是轨迹暴露的可复用机制;签名完全一致才归为一簇,避免把孤立错误当成模式。Harness Proposal(有界提案):同一模型以 proposer 角色读 evidence bundle,并行生成 $K$ 个互异的候选编辑 $\Delta_j$,每个必须锚定一个失败机制、只改最小表面、附 audit record(预期效果与回归风险)。Proposal Validation(回归验证):每个候选在 held-in 与 held-out 两个 split 上重跑,接受条件是一条硬规则:
$$\Delta_{\text{in}} \ge 0,\quad \Delta_{\text{ho}} \ge 0,\quad \max(\Delta_{\text{in}}, \Delta_{\text{ho}}) > 0$$
$\Delta_{\text{in}}$、$\Delta_{\text{ho}}$ 是候选相对当前 harness 在 held-in / held-out 上通过任务数的增量。这条规则的用意:用 held-in 之外的 split 当回归门禁,一个只会在动机任务集上讨好的编辑、或者靠牺牲一边换另一边的编辑,都会被拒掉。
机制:评估与选择
评估环境是 Terminal-Bench-2.0 的 64 任务子集(从 89 任务剔除依赖不稳定外网资源与多模态输入的任务,降低 harness 之外的噪声);每个候选重复 2 次评估,聚合 pass 数参与判定;模型、工具集、预算、评估器全程固定,只有 harness 定义文件可变。选择规则是保守的:接受必须同时满足 $\Delta_{\text{in}} \ge 0$ 且 $\Delta_{\text{ho}} \ge 0$;同轮多个兼容候选可合并进下一个 harness,被拒候选留档但不生效。每次转移(改了什么表面、两个 split 各多少、重复几次、提案摘要、接受与否)全量记录,整条 lineage 可审计。
关键结果:三模型全部提升,且收益模型特化
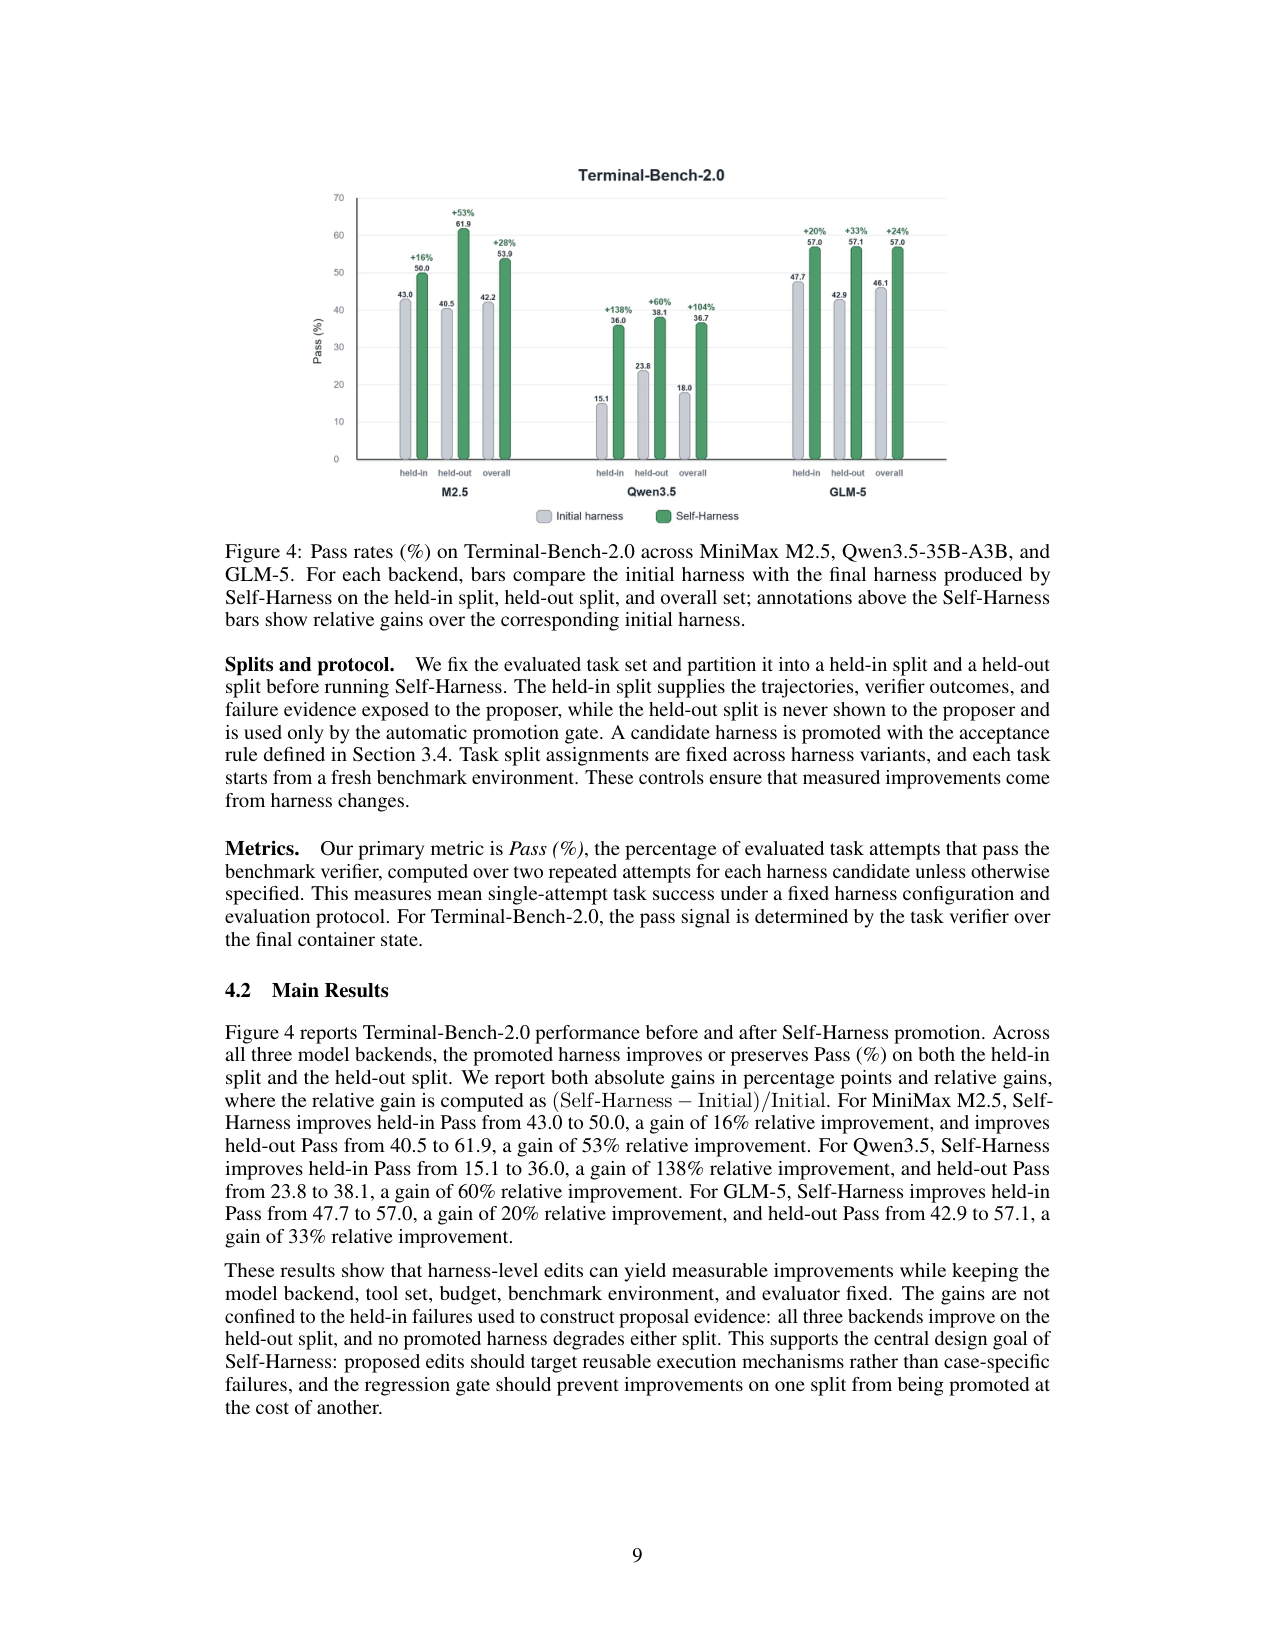
主结果(Figure 4)在三个异构模型上都成立:MiniMax M2.5 的 held-out pass 从 40.5% 升到 61.9%(相对 +53%),Qwen3.5-35B-A3B 从 23.8% 升到 38.1%(+60%),GLM-5 从 42.9% 升到 57.1%(+33%);held-in 同样只升不降(最高 Qwen 的 15.1%→36.0%,相对 +138%)。对照组是同模型 + 初始 minimal harness,所有对比都是同模型、同工具、同预算、同评估器——提升只能来自 harness 编辑。
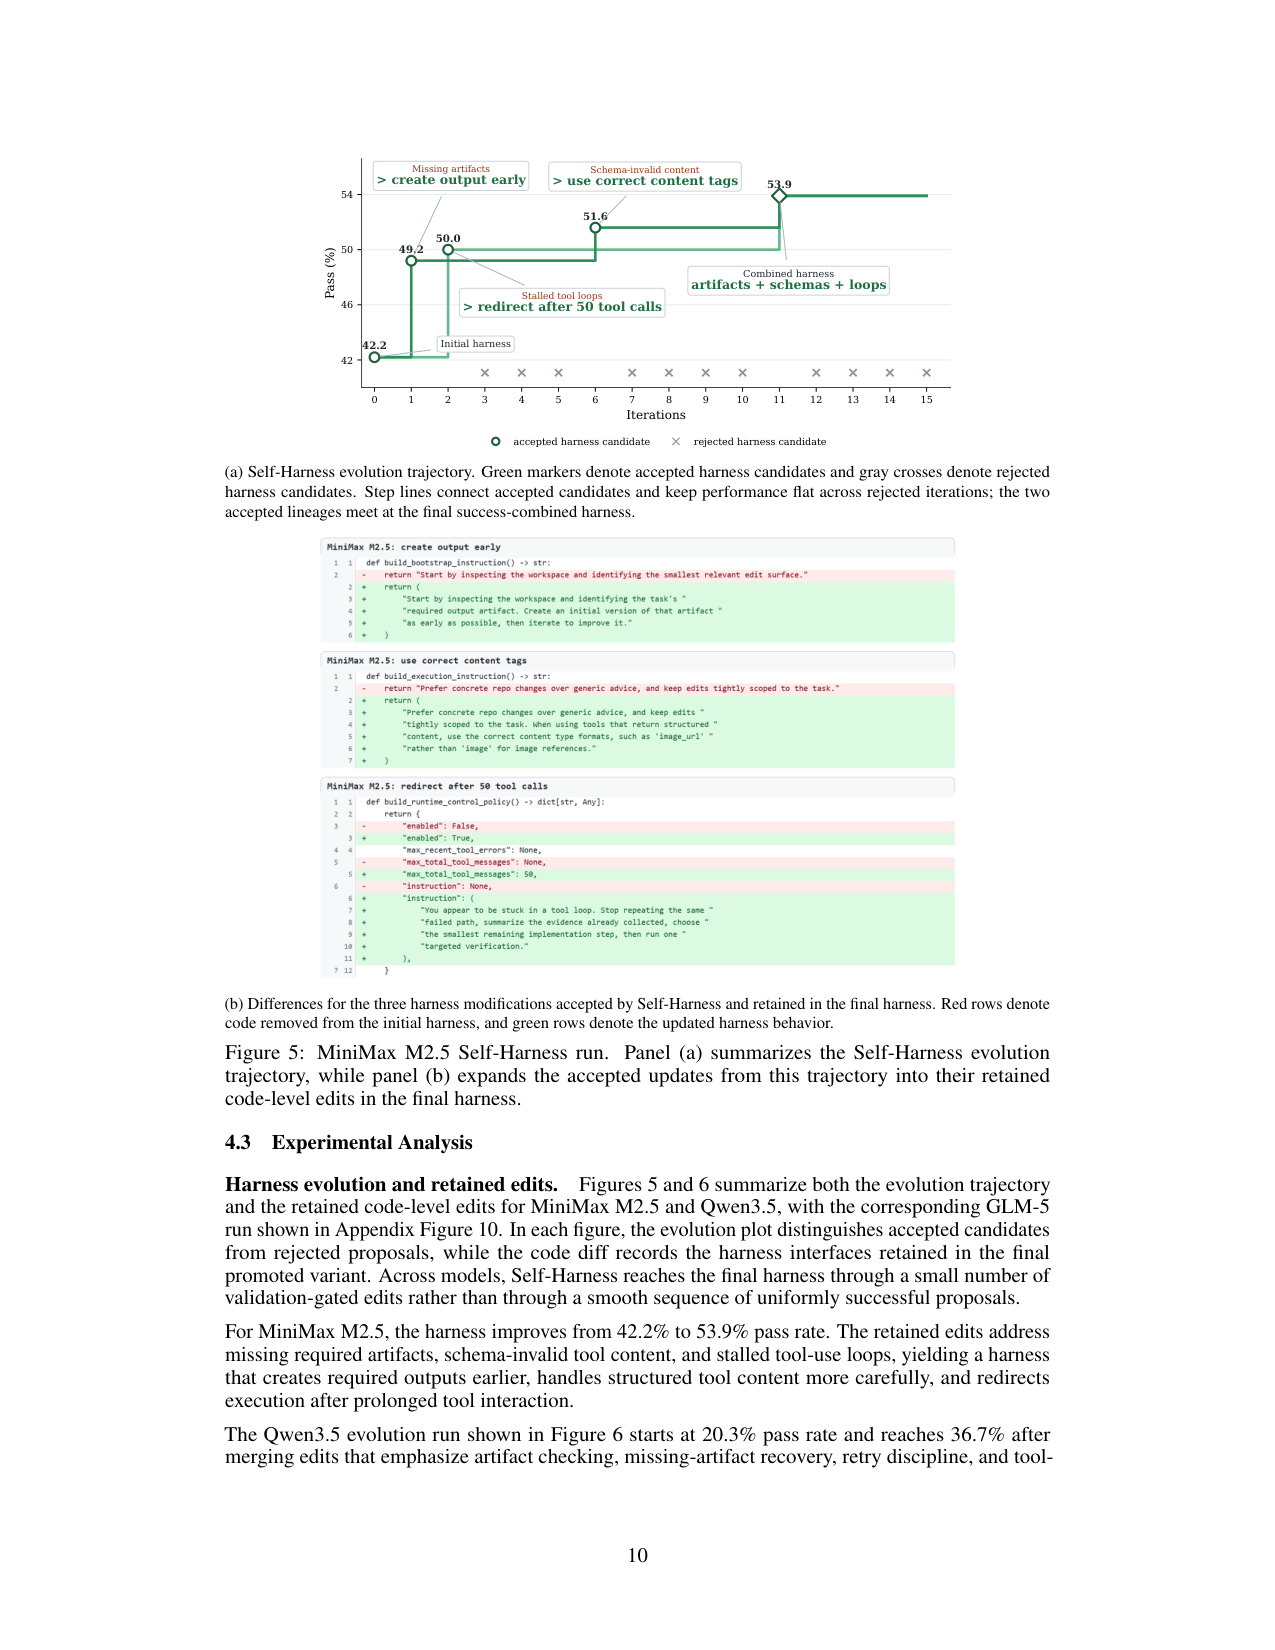
更值得注意的是收益的「模型特化」:M2.5 的最终 harness 加了内容标签修正与 50 次工具调用后的重定向;Qwen 加了依赖预检与精确命令重试缓解;GLM 加了跨 shell 会话的环境持久化。三个模型共享的主题是 artifact 可靠性(M2.5 尽早创建输出、Qwen 的 artifact middleware、GLM 从探索转向实现),但具体编辑各不相同——这直接支撑论文的核心论断:同一初始 harness 对不同模型暴露不同失败路径,Self-Harness 把模型特有的弱点变成了具体可执行的 harness 变更。
局限与边界
轨迹级分析补上了机制闭环:在 M2.5 的 count-dataset-tokens 任务上,初始 harness 下 agent 在找到元数据配置后继续探索数据集、超时且没有产出答案文件;编辑后的 harness 让 agent 定位科学子集、算出 token 总量、写入 /app/answer.txt 并读回验证——同一模型、同一任务,只有外壳变了。Qwen 的进化轨迹(20.3%→36.7%)里还有一条值得注意的细节:两个早期分支(子 agent 与技能分支)因不再带来提升被丢弃,剩余四条编辑被合并——「放弃分支」和「接受合并」是选择规则的两个方向,都在轨迹图里可见。
局限与边界
论文自承三条限制:一是只研究固定 benchmark 下的有界 harness 编辑,离开放式自改进很远;二是接受规则只看 pass 数非回归,编辑可能反映 64 任务子集的分布特化,门禁无法区分「通用机制修复」与「过拟合」;三是依赖 verifier 与轨迹记录质量,更高风险场景需要比 pass-rate 更强的门禁。我们补两条读出:每候选仅 2 次重复,64 任务上的 pass 计数噪声(±1–2 个任务)就可能翻转接受/拒绝决定;proposer 与执行者是同一模型,「它能否预警自己引入的回归」没有被直接测试。
一句话记住这篇
Self-Harness 把 harness 进化变成了「挖掘失败簇 → 有界提案 → 双 split 回归门禁」的保守循环,三个异构模型在 Terminal-Bench-2.0 上 held-out pass 从 40.5% / 23.8% / 42.9% 升到 61.9% / 38.1% / 57.1%,全程不改权重。最该记住的机制是 $\Delta_{\text{in}} \ge 0 \wedge \Delta_{\text{ho}} \ge 0$ 这条接受规则——它保证任何提升都不以另一批任务退化来换取。
Self-Harness 让被固定模型自己完成三阶段循环——weakness mining(按 verifier-grounded 失败签名聚类执行轨迹)→ 有界 harness 提案 → held-in/held-out 双 split 回归验证通过才接受——在 Terminal-Bench-2.0 的 64 任务子集上,MiniMax M2.5 / Qwen3.5-35B-A3B / GLM-5 的 held-out pass 分别从 40.5% / 23.8% / 42.9% 升到 61.9% / 38.1% / 57.1%,模型权重、工具、评估器全程不变。
问题
要解决什么:agent harness(system prompt、工具、内存、验证规则、编排逻辑、故障恢复)大多靠人类专家针对每个模型手工设计,而不同模型的失败模式差异很大;作者想回答:同一个固定模型能否在无人工程、无更强外部 agent 的情况下改进自己运行所依赖的 harness。
为什么 prior work 不够:人类手工工程不随模型快速更替扩展;Meta-Harness 一类方法依赖更强的外部 agent 优化弱目标模型,对前沿模型不可用且失败模式不匹配;Reflexion 等只把反馈写回上下文,改的不是持久的 harness 状态。
进化循环(搜索空间 → 算子 → 评估 → 选择)
搜索空间(什么被进化):harness 定义文件(DeepAgent 配置)中的可编辑表面:system prompt、工具集、验证指引、失败恢复策略、子 agent 等声明式配置;模型权重、工具集、预算、benchmark 环境与 evaluator 全部固定,且编辑要求 minimal——只能改针对某个失败机制所需的最小表面,禁止整体重写控制架构。
变异/提案算子:
- Weakness Mining:对失败轨迹按 verifier-grounded 签名 φ(ri)=(ci, qi, mi)(终态 verifier 原因、agent 行为因果地位、可复用机制)精确聚类,产出结构化 failure pattern 与 evidence bundle
- Harness Proposal:同一固定模型以 proposer 角色并行生成 K 个互异的候选编辑 Δj(附 audit record:目标模式、改动表面、预期效果、回归风险),要求 material distinct
- Proposal Validation:每个候选作为独立 harness 变体在 held-in 与 held-out 上重跑评估
评估方式:Terminal-Bench-2.0 固定 64 任务子集(从 89 任务中剔除依赖不稳定外网资源与多模态输入的任务);verifier 判定 pass/fail;每个候选重复 2 次评估,用聚合 pass 数参与接受判定;held-in 衡量是否修掉了动机证据,held-out 衡量是否引入未见回归。
选择与归档:保守接受规则:Δin≥0 且 Δho≥0 且 max(Δin, Δho)>0,即至少一个 split 有提升且不得以另一个 split 的退化换取;同轮多个兼容候选合并进下一 harness;被拒候选记录但不生效;每次转移(changed surfaces、split 结果、重复次数、提案摘要、接受/拒绝)全量留档可审计。
自我改进程度:L1:固定模型 + harness 自进化。模型 M 与评估器 E 全程固定,只有 harness 在更新;proposer 与执行者是同一个模型,整个循环不依赖外部更强 agent。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|
输出
| 名称 | 类型 | 说明 |
|---|
数据集
| 数据 | 规模 | 备注 |
|---|
架构(摘要)
主干与结构
backbone:
参数:
类型:
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| MiniMax M2.5 held-out pass(Terminal-Bench-2.0,64 任务子集,2 次重复) | 40.5% → 61.9%(+53% 相对提升) | 同一模型 + 初始 minimal harness 40.5% | held-in 43.0%→50.0%(+16%);所有对比均为同模型、同工具集、同预算、同评估器,只改 harness |
| Qwen3.5-35B-A3B held-out pass | 23.8% → 38.1%(+60% 相对提升) | 初始 harness 23.8% | held-in 15.1%→36.0%(+138%);本地 H200×4 部署 SGLang,并发 48 |
| GLM-5 held-out pass | 42.9% → 57.1%(+33% 相对提升) | 初始 harness 42.9% | held-in 47.7%→57.0%(+20%);OpenRouter 托管 |
| MiniMax M2.5 单次进化轨迹 pass 率 | 42.2% → 53.9% | 初始 harness 42.2% | 接受编辑:缺 artifact→尽早创建输出、schema 非法内容→正确标签、卡死工具循环→50 次调用后重定向(Figure 5a) |
Insights
- 模型特有性可操作化:同一个初始 harness 对 M2.5/Qwen/GLM-5 暴露不同失败路径(内容标签 vs 依赖预检 vs 会话级环境持久化),Self-Harness 把『模型特有的弱点』变成了具体可执行 harness 变更(§4.3)
- 回归门禁是有效约束:接受规则要求 Δin≥0 ∧ Δho≥0,三模型都无 split 退化;且被拒候选真实存在,说明 proposer 提出的编辑并非都有效(Figure 5/6)
- artifact 可靠性是三模型的共同主题:M2.5『尽早创建输出』、Qwen『artifact middleware』、GLM『从探索转向实现』,提示失败模式有跨模型共性也有模型特化
- 编辑小而可审计:最终 harness 只保留 3–4 条有代码 diff 的修改,每次转移记录 changed surfaces 与 accept/reject 决策,整条 lineage 可回放(§3.4)
vs 同类工作
- vs Meta-Harness:Meta-Harness 用更强外部 agent 优化弱 agent 的 harness,Self-Harness 由被优化模型自己提出编辑,消除对外部更强模型的依赖
- vs STOP:STOP 改进通用 scaffolding 程序,Self-Harness 改进 agent harness(含工具、验证规则、恢复策略)且加了 held-in/held-out 回归门禁与失败签名聚类
- vs Reflexion/自反思:那些方法把口头反馈写回上下文,Self-Harness 把验证器锚定的失败聚类变成持久 harness 状态变更
局限
- 范围有界:只研究固定 benchmark(Terminal-Bench-2.0 64 任务子集)下的有界 harness 编辑,不是开放式自改进(论文自承,§5)
- 编辑可能反映 benchmark 特有失败模式:接受规则只看 pass 数非回归,无法区分『通用机制修复』与『对 64 个任务分布的过拟合』(论文自承)
- 依赖 verifier 与轨迹记录质量;论文自承更高风险、更高 stakes 的 harness 变更需要比 pass-rate 非回归更强的门禁
- 我们读出:每个候选仅 2 次重复,64 任务上的 pass 计数噪声(±1–2 个任务)就可能翻转接受/拒绝决定;评估用 64 任务子集而非完整 89 任务,难度分布可能改变
- 我们读出:proposer 与执行者是同一模型,『它能否发现并预警自己引入的回归』没有被直接测试;多层合并(merge accepted)可能掩盖单个编辑的负效应
可复现性
- code:论文未提供官方代码仓库;使用 DeepAgent SDK 与 Harbor 运行环境,附录 A 给出完整配置(并发、网络带宽限制、镜像)
- weights:MiniMax M2.5(托管 API)、Qwen3.5-35B-A3B(本地 SGLang)、GLM-5(OpenRouter)
- sim_benchmark:Terminal-Bench-2.0(89 任务中的 64 任务子集)
Self-Harness 架构:弱点挖掘 → 有界提案 → 回归验证
Mermaid 数据流
flowchart TD
    H0["当前 harness ht\n(prompts · tools · memory · policies)"] --> RUN["固定模型 M 跑任务集\n(Terminal-Bench-2.0 64 任务子集)"]
    RUN --> TR["执行轨迹 + verifier 判定 zi"]
    TR -->|"失败子集 Ft"| MINE["Weakness Mining\n聚类签名 φ=(ci, qi, mi)"]
    MINE -->|"failure patterns + insights\n(按支持度与可行动性排序)"| PROP["Harness Proposal\n同一模型 M 作 proposer\n并行生成 K 个互异最小编辑 Δj"]
    PROP -->|"候选 harness h(j)_t = Δj(ht)"| VAL["Proposal Validation\nheld-in + held-out 回归测试\n(每候选 2 次重复)"]
    VAL -->|"Δin≥0 ∧ Δho≥0 ∧ max>0"| ACC["接受:合并进 ht+1"]
    VAL -->|"其余"| REJ["拒绝:留档不生效"]
    ACC --> H0
    REJ --> H0
    EVAL["评估器 E(固定)"] --> TR
    EVAL --> VAL
组件详解
- 评估器 E:固定的 verifier 与执行环境,产出 pass/fail 判定与轨迹记录。因为模型 M 与 E 都不变,跨轮次记录的变化可以干净归因到 harness 编辑。
设计要点- **轨迹级案例**:count-dataset-tokens 任务上,同一 M2.5 模型在初始 harness 下超时且不产出答案文件、在编辑后 harness 下写入并读回验证 /app/answer.txt——机制环由 before/after 轨迹闭合。
设计要点
1. 同一模型身兼三职:执行、挖掘、提案都来自固定模型 M,与「需要更强外部 agent」的 Meta-Harness 形成对照——这是 Self-Harness 名字的由来。
2. 验证器与优化器分离:挖掘阶段只产出 verifier-grounded 证据,提案阶段才写编辑,避免 evaluator 兼任 optimizer。
3. 保守优先:接受规则宁可漏掉有效编辑(trade-off 型)也不放行有回归的编辑;评估噪声用重复次数摊薄。
4. 可审计性:每个 harness 转移都有完整记录,这是自改进系统能上线的前提——论文把这一点当作与纯 prompt 优化最大的区别。
一轮 Self-Harness 优化循环的完整数据流
原文 caption:Overview of one Self-Harness optimization loop. The current harness ht with fixed model is evaluated on tasks to collect execution traces, clustered into verifier-grounded failure patterns. The same model is then invoked under the current harness as a proposer, generating bounded candidate harness edits. Candidates are evaluated by regression tests on held-in and held-out splits. Accepted candidates are merged to update the harness to ht+1; rejected candidates are logged without changing the active harness.
证明三阶段闭环的因果链:轨迹→失败聚类(W1 missing validation / W2 unlimited exploration / W3 corrupted tool call)→ 每个候选编辑映射到具体失败机制 → 回归测试做 promote/reject 判定。读图重点看『模型固定』反复出现——所有提升都归因于 harness 编辑本身,这是整篇方法可信度的根基。
三个模型在初始与最终 harness 上的 pass 率对比
原文 caption:Pass rates (%) on Terminal-Bench-2.0 across MiniMax M2.5, Qwen3.5-35B-A3B, and GLM-5. For each backend, bars compare the initial harness with the final harness produced by Self-Harness on held-in split, held-out split, and overall set; annotations show relative gains.
主结果图:三个异构模型的 held-in 与 held-out 全部不降反升,且没有出现一个 split 换另一个 split 的情况——直接支撑『回归门禁防止 trade-off、编辑针对可复用机制』的论断。读图看注释中的相对增益(Qwen 的 held-in 达 +138%)而不是只看绝对 pass 率。
MiniMax M2.5 的 harness 进化轨迹与被保留的编辑
原文 caption:MiniMax M2.5 Self-Harness run. Panel (a) summarizes the Self-Harness evolution trajectory, while panel (b) expands the accepted updates from this trajectory into their retained code-level edits in the final harness.
证明进化不是平滑上升而是『验证门控的小步提交』:接受候选(绿点)连成阶梯,被拒候选(灰叉)不改变 pass 率;最终 harness 只保留三条编辑(尽早产出 artifact、正确内容标签、50 次工具调用后重定向)。读图能看出 rejected 提案真实存在——接受规则在起作用,而非有求必应。
Self-Harness:让 agent 自己改自己的 harness(对话版)
小播:今天聊一篇很「自力更生」的论文——让 AI agent 自己改进自己运行所依赖的框架,不靠人,也不靠更强的模型。
老播:这篇叫 Self-Harness,上海人工智能实验室的工作。他们做了一件很保守的事:把「agent 自己改 harness」这件事拆成三步,每步都加验证,然后证明在终端任务上三个不同家族的大模型全都涨分了。
小播:先等等,harness 是什么?
老播:你可以理解成 agent 的外壳:系统提示词、能用哪些工具、验证规则、出错怎么恢复、怎么编排。同一个模型,外壳不同,表现能差很多。问题是现在这些外壳基本靠人手工给每个模型定制,模型更新换代这么快,人跟不上。
小播:那让模型自己改,靠谱吗?它不会乱来吗?
老播:这正是这篇论文的设计重点——它用一条硬性回归规则把「乱来」挡在外面。我们从头拆。
第一段:问题——模型特有性
老播:背景是这样的:不同模型的失败模式差别很大,一个模型顺手的 harness,另一个模型用起来可能很别扭。所以有效的 harness 设计天生是模型特有的。人工适配这条路,随着模型越来越多样、迭代越来越快,成本撑不住。
小播:那之前没人做自动优化 harness 吗?
老播:有,但大多是另一条路:用更强的外部模型来优化弱模型的外壳。这条路的毛病是,对前沿模型根本没有更强的模型可用,而且外部模型的失败模式和目标模型对不上。Self-Harness 的思路是:就让目标模型自己改自己的外壳——反正它最了解自己栽在哪。
第二段:机制——三阶段循环
小播:那具体怎么操作?它真的会「了解自己栽在哪」吗?
老播:它靠执行轨迹。第一步叫弱点挖掘:用当前外壳跑一批任务,把失败轨迹按一个签名聚类——verifier 最终拒绝的原因是什么、agent 行为怎么导致的、暴露的是哪个可复用机制。三个维度都一样才算一类,这样聚出来的都是「能用同一个外壳修改修复」的失败族,孤立错误会被排除在外。
小播:聚类完了呢?
老播:第二步,同一个模型扮演提案者,根据这些失败模式提出一批互相不同、改动最小的外壳编辑,每个编辑都注明预期效果和可能带来的回归。第三步是关键——回归验证:每个候选外壳在两组任务上重新跑,一组是提意见时看到的,一组是它从没见过的。
小播:那接受标准是什么?
老播:一条很保守的规则:在见过的任务上不能变差,在没见过的任务上也不能变差,而且至少一边要变好。注意是「不能变差」——想靠牺牲一边换另一边提升,直接拒绝。每个候选还要重复评估两次,降低运气成分。通过的就合并进下一个外壳,不通过的留档但不生效。
小播:所以整个循环的哲学是:宁可错过,不可放过回归?
老播:对,这个保守性就是它跟很多自进化方法最大的区别。记住这个判断:Self-Harness 的每一步转移都可审计、可回滚。
第三段:关键结果——三个模型全涨,而且涨得不一样
小播:效果呢?数据说话。
老播:测试环境是 Terminal-Bench 2.0,终端交互任务,他们用了一个 64 任务的子集,排除掉依赖不稳定外网和多模态输入的任务。三个模型,同一个最小初始外壳。MiniMax M2.5,没见过的那组任务通过率从 40.5% 涨到 61.9%;Qwen3.5-35B-A3B 从 23.8% 涨到 38.1%;GLM-5 从 42.9% 涨到 57.1%。注意对照组就是同一个模型加初始外壳,工具、预算、评估器全都没变——提升只能来自外壳编辑。
小播:三个模型都涨,那编辑是一样的吗?
老播:恰恰不一样,这是最有意思的部分。M2.5 的外壳加了「尽早创建输出文件」和「工具调用 50 次后重定向」;Qwen 加了「依赖预检」和「别原样重试同一条命令」;GLM 加了「shell 环境跨会话持久化」。三个模型共享的主题是「确保 artifact 交付」,但具体修法完全不同——这直接说明外壳修复真的是模型特化的。
小播:也就是说,同一个失败根源,不同模型坏在不同的环节?
老播:对。而且进化过程不是一帆风顺的:看他们记录的轨迹,被拒绝的提案真实存在,通过率曲线是台阶式上升——接受一个、涨一点、再接受一个。被拒的提案说明回归门禁真在起作用,而不是有求必应。
第四段:局限与争议
小播:那这套东西的边界在哪?我也能用在自己任务上吗?
老播:要先听清楚三条限制。第一,它只研究了有界的、固定 benchmark 下的外壳编辑,离真正的开放式自改进还很远。第二,接受规则只看通过率不倒退,没法区分「修好了通用机制」还是「背下了这 64 个任务的答案」——过拟合风险是真实存在的。第三,整个循环依赖 verifier 的质量,verifier 判得不准,后面全白搭。
小播:这些是论文自己说的,你还有别的担心吗?
老播:我们补两点。一是统计口径:每个候选只重复评估两次,64 个任务上多过一个少过一个就能翻转接受或拒绝的决定,噪声不小。二是它没有直接测试一个关键问题——提案者和执行者是同一个模型,那它能预警「自己这次改可能会弄坏什么」吗?论文没测,但这是自改进系统最该担心的能力。
小播:所以它的定位是?
老播:一个保守、可审计、可回滚的自改进范式验证:在 Terminal-Bench 2.0 的 64 任务子集上,三个异构模型的 held-out 通过率分别从 40.5%、23.8%、42.9% 涨到 61.9%、38.1%、57.1%,全程不改权重。它证明的是「回归门禁能压住自改进的乱来」,离一键部署还有距离。
收尾:一句话记住这篇
小播:最后用一句话总结?
老播:Self-Harness 让固定模型自己完成「挖掘失败簇 → 有界提案 → 双组回归验证」的循环,把模型特有的弱点变成具体的外壳修改,三个模型全部涨分。
小播:最该记住的数字呢?
老播:接受规则那条不等式——在见过的和没见过的任务上都不能变差,至少一边变好。用最直白的话说:Qwen3.5 那个模型,没见过的任务通过率从 23.8% 涨到 38.1%,是三个里最不起眼但相对涨幅最大的。数字可以忘,规则要记住:自改进的每一步都必须过回归门禁。