Hyperagents:让「修改自己的机制」也参与进化
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。
先看一个现象:DGM 让编码 agent 改自己的代码,越改越强——但它的「自改进指令生成机制」是手工写死的。更麻烦的是,DGM 能自我加速,靠的是一个隐蔽的对齐假设:下游任务(改代码)和自我改进(也是改代码)是同一件事。换个领域,比如论文评审,任务表现和能力提升就断了。Meta 与 UBC 的这篇 Hyperagents 把最后一层也打开:把 task agent 和 meta agent 合成一个可编辑程序,让「生成未来改进的机制」本身也能被改,并且证明这在编码之外的任务上真的work。
背景:无限递归的出口
自改进系统有个经典两难。方案一:固定一个 meta agent 去改 base 系统——base 只能在 meta 划定的边界内改进。方案二:加 meta-meta 去改 meta——问题只是被推高一层,最后陷入无限递归。Hyperagents 的出口是把元层融进同一个可编辑程序:这个程序同时是 task agent(解任务)和 meta agent(修改 agent、生成新 agent),而 meta agent 的修改机制本身也是程序的一部分,可以被 meta agent 自己改。
核心机制:metacognitive self-modification
定义上,hyperagent 是「集成 task agent 与 meta agent 于单一可编辑程序的自我指称 agent」。循环沿用 DGM 的开放探索:档案存所有 hyperagent,parent 按「性能分正比、有编辑能力的孩子数反比」采样,全部保留非零概率;每轮 parent 分析过去表现,决定改哪块代码——可以改 task 逻辑,也可以改 meta agent 自身。后者就是 metacognitive self-modification:改进「如何提出未来改进」的机制。
论文用一个指标量化「meta agent 会改进 task agent」这件事:
$$\text{imp@}k = \text{测试性能}\big(\text{best of } k \text{ 次生成}\big) - \text{测试性能}\big(\text{初始 task agent}\big)$$
$k$ 是生成次数上限,best 按验证分选。保持 meta agent 固定、只让它改 task agent,imp@k 就隔离出「meta 层的生成能力」。对比 DGM-H(meta 可编辑)与 DGM-H w/o self-improve(meta 固定)的 imp@k,就能看出元层自修改的增量价值。
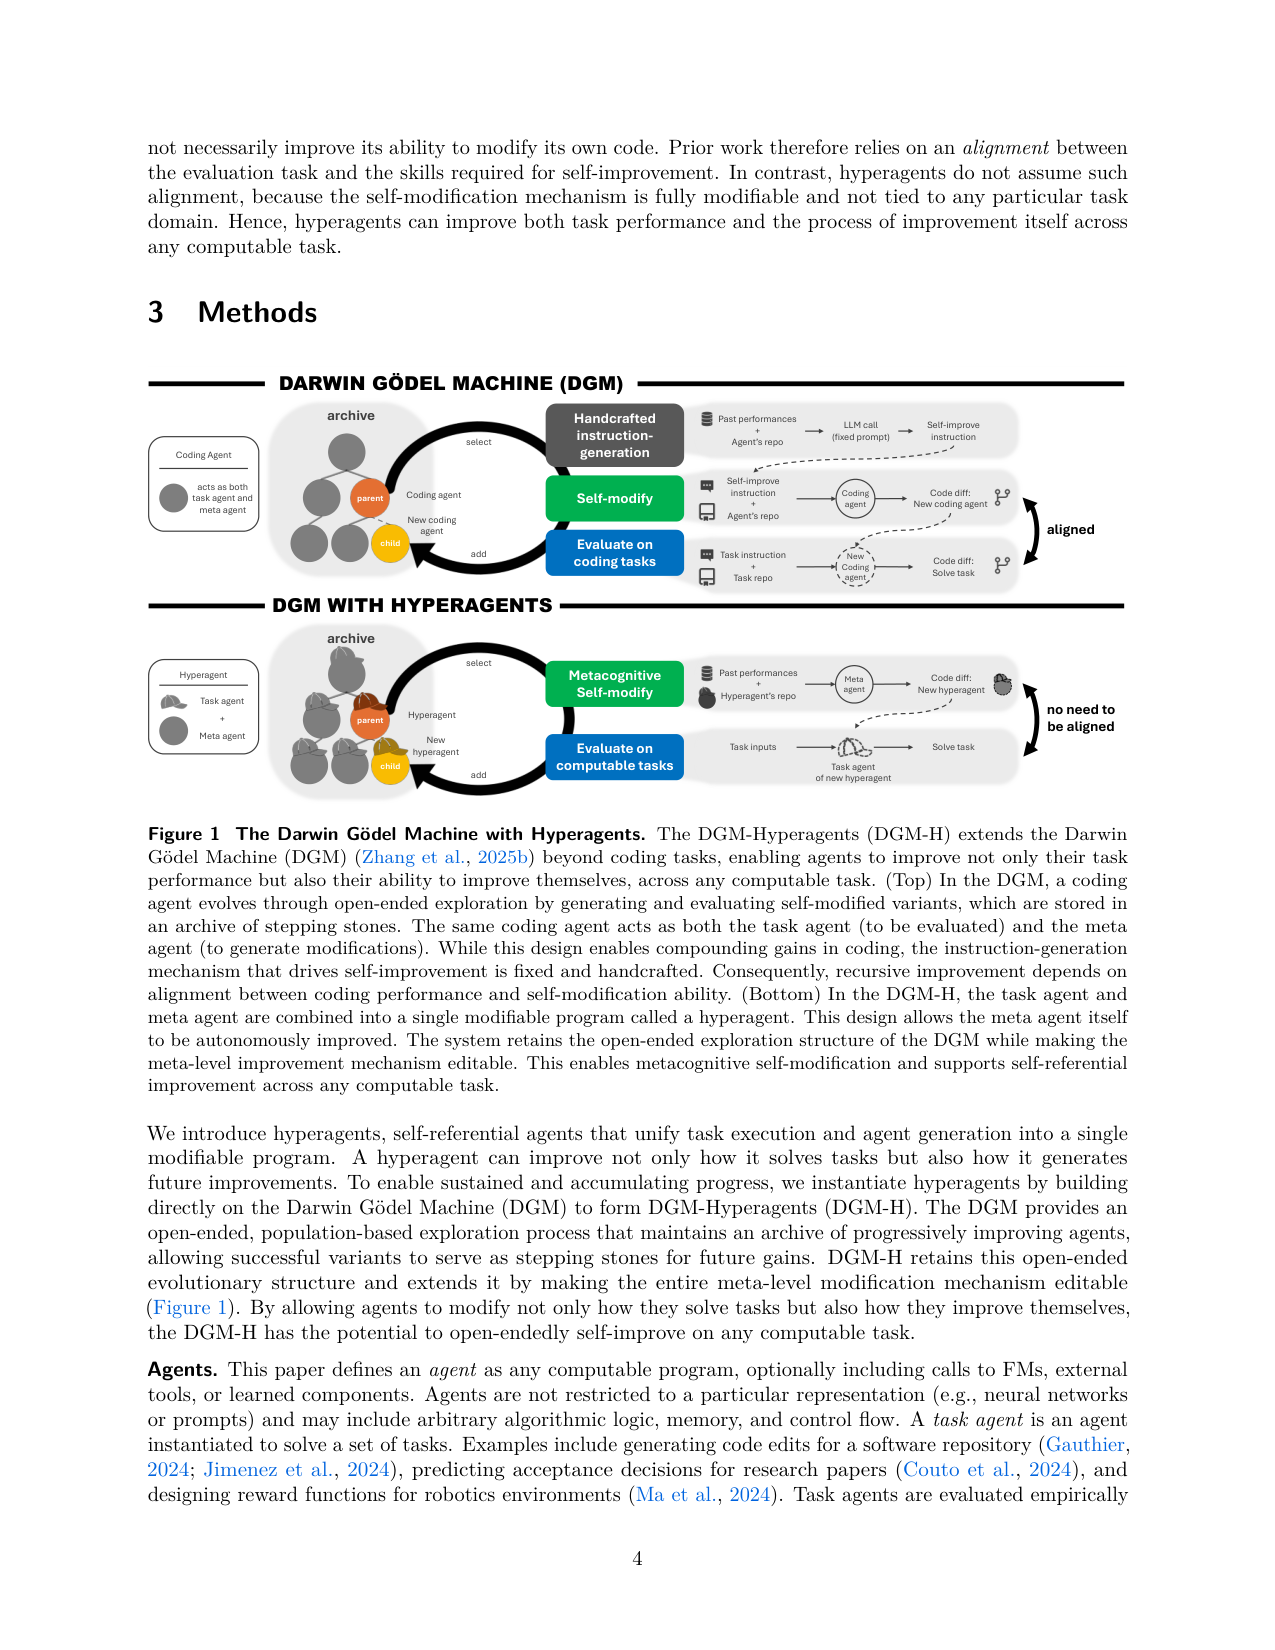
再展开一个机制上的关键点:为什么「meta 层可编辑」能消除对齐假设。在 DGM 里,自改进能力依赖「任务 = 编码」,因为生成自改进指令的机制是编码专用、手工写死的;一旦任务换成论文评审,这套机制产出的指令对不上任务。DGM-H 里没有单独的指令生成机制——meta agent 就是被进化的对象,它自己会学着针对当前领域生成有用的修改。所以系统不需要「任务表现 → 自改进能力」的预设等式,任务改进本身就会重塑 meta agent,这是 Hyperagents 的论文级主张。
补充一个质量细节:论文评审里 DGM-H 的改进路径很有代表性——从「换个严谨 persona」这类表面提示调整,进化成「多阶段评估管线 + 检查清单 + 决策规则」的结构化决策机制;奖励设计那边则是逐步构建环境约束、合法状态变量、奖励缩放的内部知识库,先消掉编译失败,再减少奖励误设。这解释了为什么元层改进可迁移:它们沉淀的是「如何为任务构建决策结构」的通用方法,与某个任务的具体答案解耦。
关键结果:四个领域,跨域累积
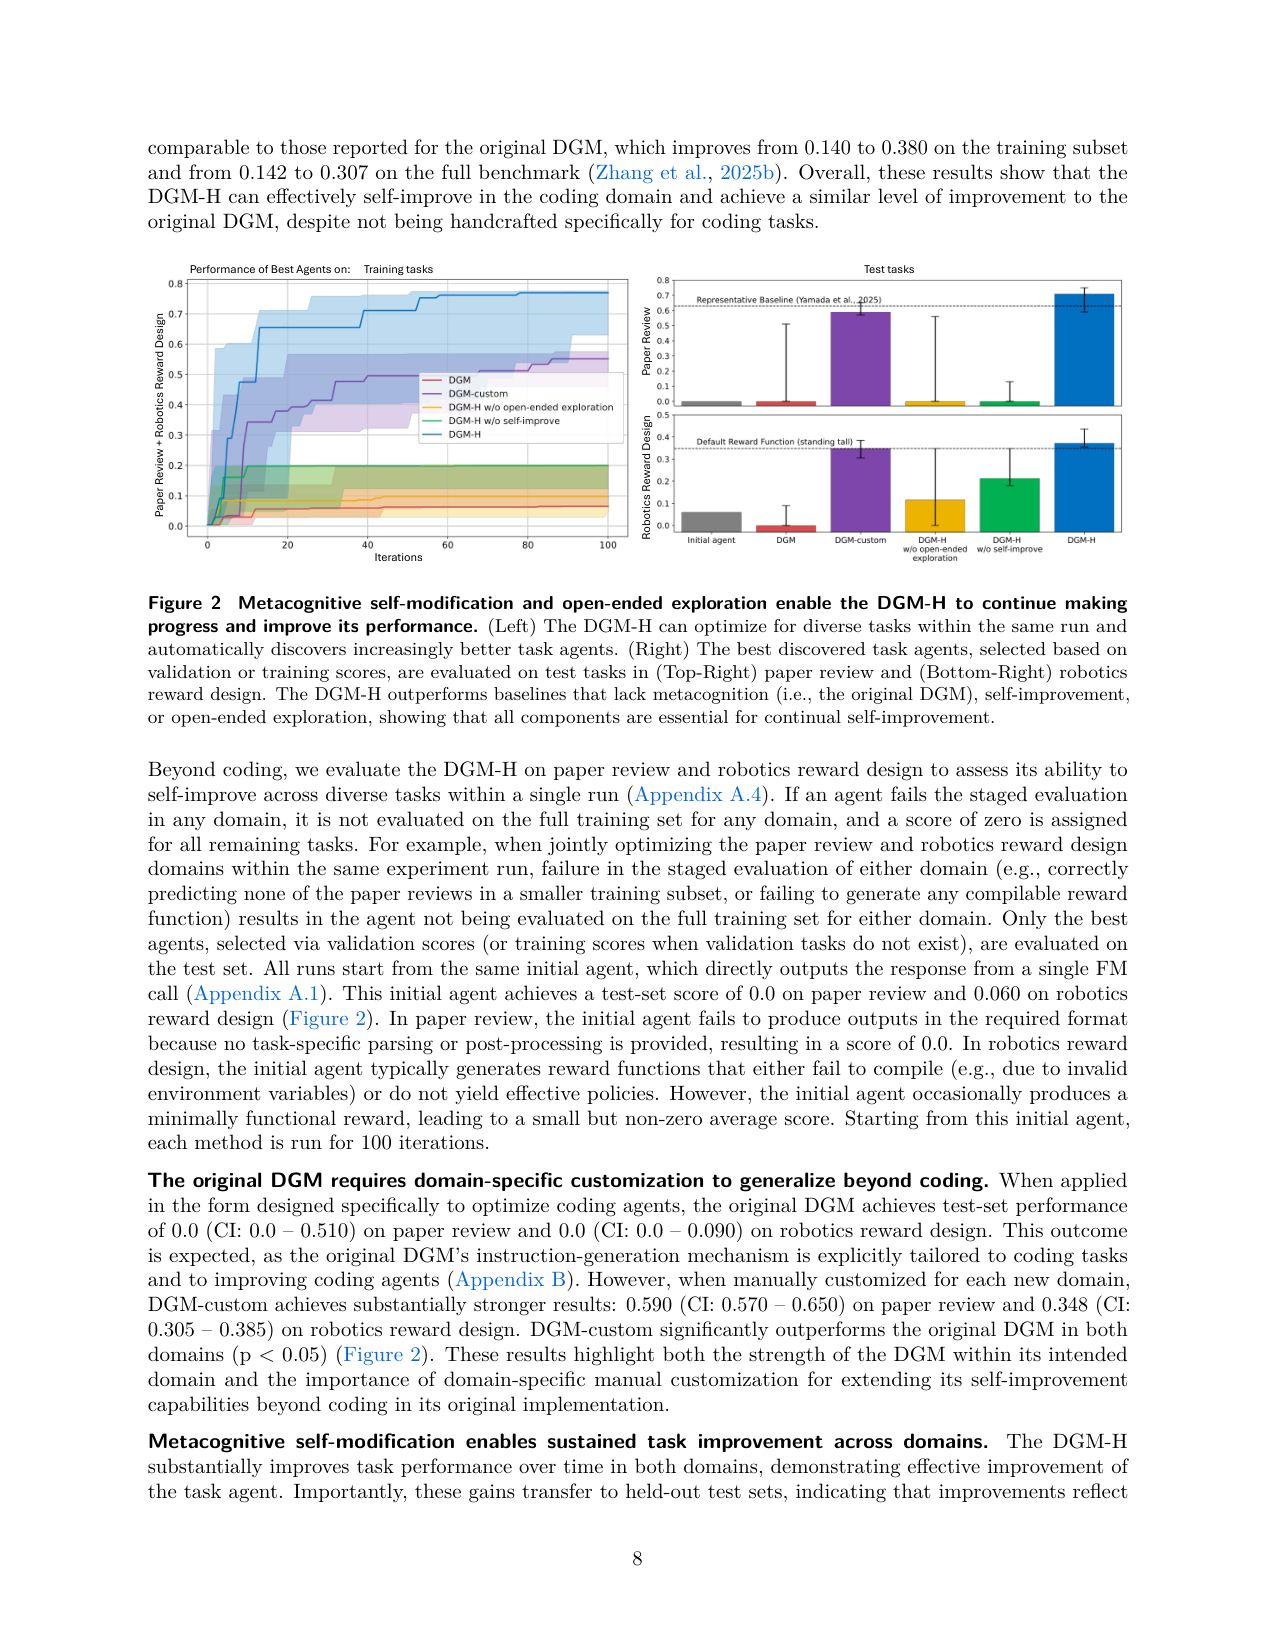
数字全部带 baseline 和 setup。编码(Polyglot,50 任务子集,5 runs,80 迭代):0.140 → 0.340(CI 0.300–0.380),对照原始 DGM 的 0.140 → 0.380——没为编码做任何特化,效果接近。论文评审(100 迭代):测试集 0.0 → 0.710(CI 0.590–0.750),静态基线(Yamada 2025)0.630、为领域手工定制机制的 DGM-custom 0.590、原始 DGM 0.0。机器人奖励设计(Genesis,100 迭代):0.060 → 0.372(CI 0.355–0.436),默认奖励 0.348、DGM-custom 0.348、原始 DGM 0.0。原始 DGM 在两个非编码域都是 0.0——它的固定指令机制换域即失效,这正好是 Hyperagents 要修的病。
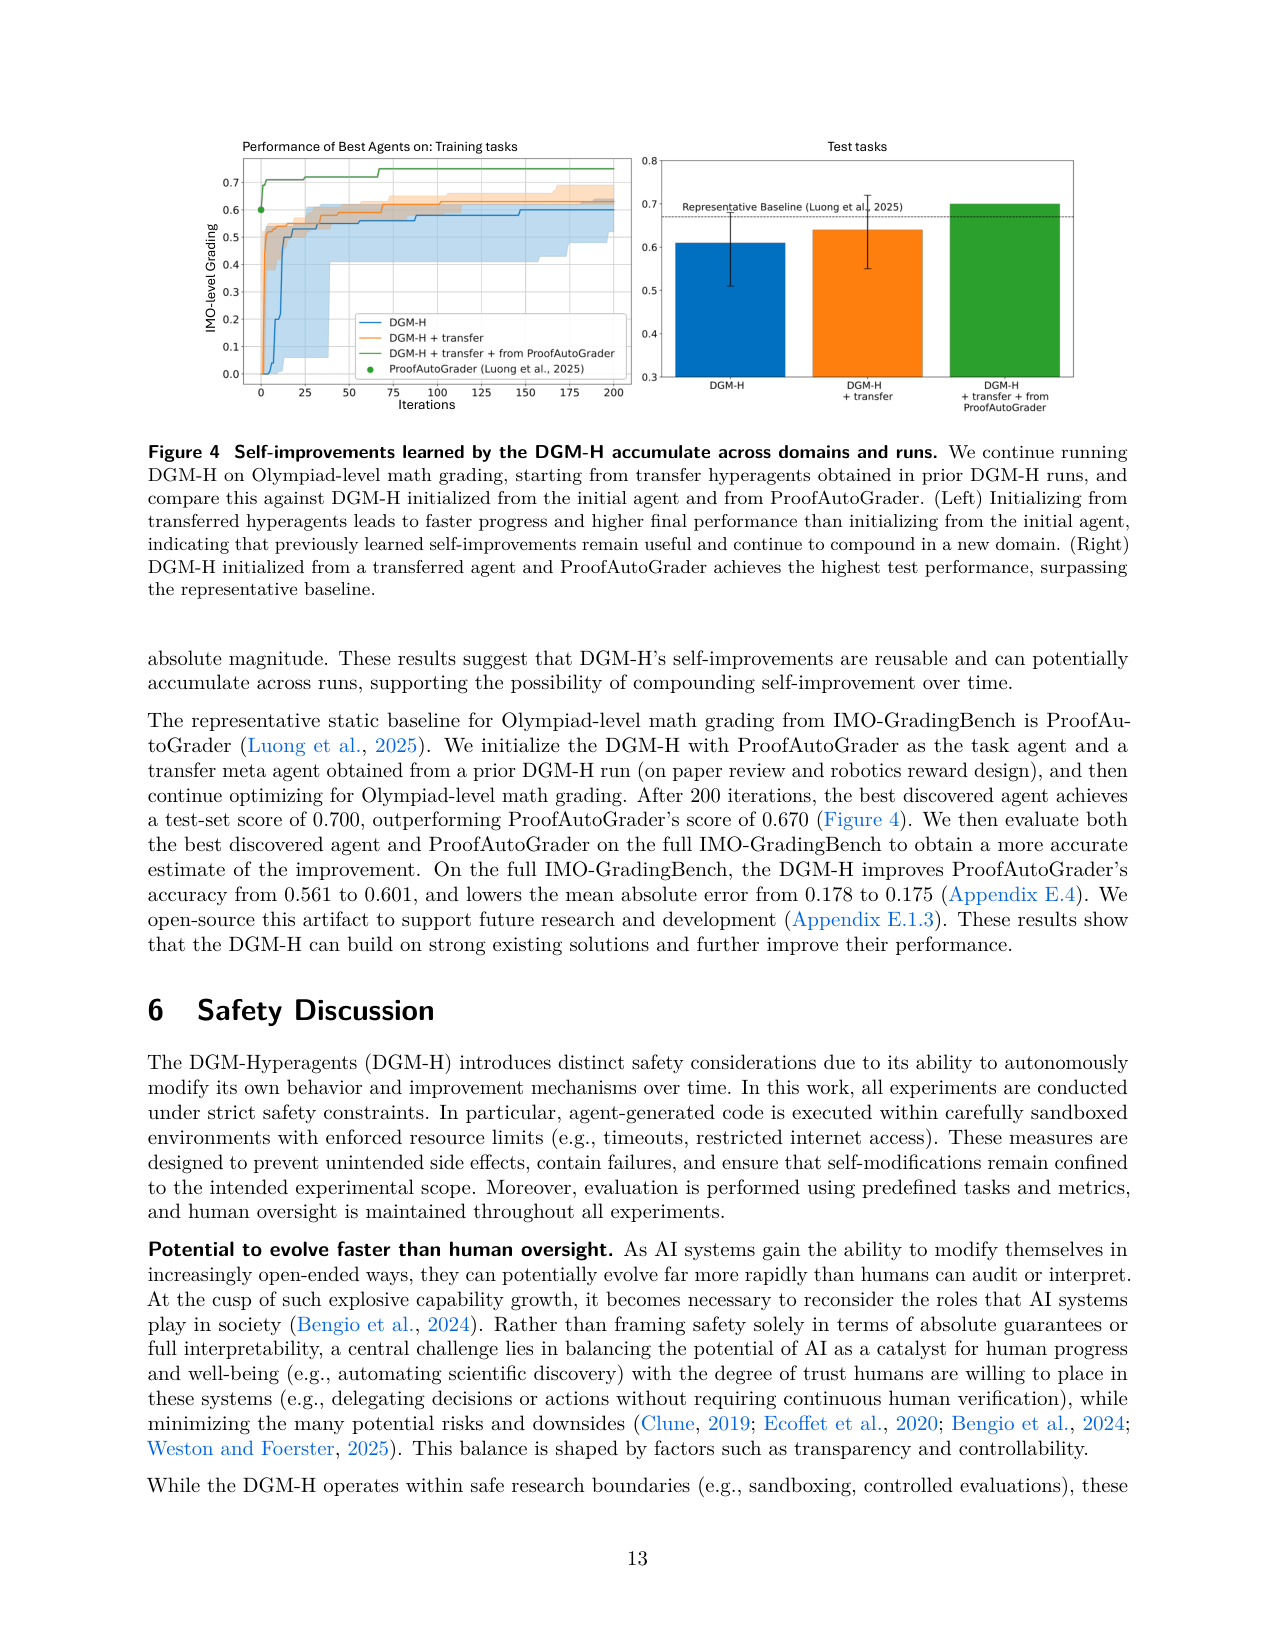
元层改进还能带走:在论文评审 + 奖励设计上跑出的 transfer hyperagent,启动 IMO 级数学评分的新 run,200 迭代后测试分 0.640(CI 0.550–0.720),从初始 agent 起步是 0.610;把 ProofAutoGrader 当 task agent 接入后 0.700,超过基线 0.670(full IMO-GradingBench 上准确率 0.561 → 0.601)。它自动长出的元层工具也很有代表性:性能追踪器(记录每代分数、算改进趋势)和持久记忆(存「哪几代最好、哪些改动过度纠正」的因果笔记,后续自修改主动查阅)。
局限:机制仍半固定,显著性有限
四条。第一,主实验的 parent selection 和评估机制仍手工固定(论文自承,为隔离变量),附录 E.5 对自动改进 parent selection 只有初步探索——「全栈自进化」还没实现。第二,统计显著性有限:DGM-H 对 DGM-custom 的中位数优势、transfer 的 0.640 vs 0.610,都是 p>0.05。第三,FM 能力是天花板:所有改进都在冻结模型的能力圈内,自我加速的极限受基座约束。第四,安全:沙箱、超时、人工监督覆盖当前实验,但「自我修改可能加速到超过人类审计速度」的风险论文在安全节明确讨论,没有自动防护。
一句话记住这篇
Hyperagents 把 task agent 和 meta agent 合成单个可编辑程序,让「生成未来改进的机制」本身进入进化循环,解开了固定元层的死结,也把自改进从编码域推广到任意可计算任务。最该记住的数字:论文评审测试集 0.0 → 0.710,对照手工定制机制的 DGM-custom 0.590;最该记住的保留:parent selection 仍是手工固定的,元层自进化的主实验还没跑。
把 task agent 与 meta agent 合成单个可编辑程序(hyperagent),让「生成未来改进的机制」本身也可被编辑:在编码、论文评审、机器人奖励设计、IMO 级数学评分四个领域持续改进(论文评审测试集 0.0→0.710、奖励设计 0.060→0.372),并证明元层改进(持久记忆、性能追踪)可跨领域转移、跨 run 累积。
问题
要解决什么:突破自改进系统的固定元层:让系统能修改「修改自己的机制」本身,从而在任意可计算任务上持续改进,而不依赖「任务表现 ≈ 自改进能力」的编码对齐假设。
为什么 prior work 不够:DGM 等系统把产生自改进指令的机制做成手工固定——改进上限被这条机制锁死;加 meta-meta 层只是把问题往上推,导致无限递归。
进化循环(搜索空间 → 算子 → 评估 → 选择)
搜索空间(什么被进化):hyperagent 的完整代码库:task agent(解目标任务)与 meta agent(修改 agent、生成新 agent)合成在一个可编辑程序里;meta 层的修改机制本身可编辑。FM 权重冻结只读;主实验中 parent selection 与评估机制固定(论文为隔离变量,附录 E.5 有初步的自动改进 parent selection 探索)。
变异/提案算子:
- metacognitive self-modification:meta agent 修改自身代码与 task agent 代码,改进「如何生成未来改进」
- 继承 DGM 的开放探索:archive 采样 + parent 概率 ∝ 性能 / 孩子数,非零概率保留所有路径
- 工具:bash + 文件查看/编辑工具
- 论文未给出:meta agent 修改自身时的失败回滚策略细节
评估方式:四领域、每个都有任务特定评估器:Polyglot(50 任务子集 + 全量复核);论文评审(10→100 训练 staged 评估,失败记 0 分,验证集选 best 上测试集);机器人奖励设计(Genesis 环境、奖励可编译 + 训练策略);IMO 级数学评分(IMO-GradingBench,100/100/100 切分)。Polyglot 80 次迭代、其余 100–200 次迭代。
选择与归档:archive 保留所有 hyperagent;parent selection 与 DGM 相同(性能分正比、有编辑能力的孩子数反比、全部非零概率);每领域用验证分(无验证集用训练分)选 best 上测试集;imp@k 指标量化「meta agent 在 k 次迭代内生成改进 task agent 的能力」。
自我改进程度:L1.5(固定 FM;meta agent 本身可被编辑):比 DGM 的 L1 多出「修改自我修改机制」的能力,但主实验中 parent selection 与评估器仍未开放给自进化——论文自承并给出附录 E.5 的初步探索。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|
输出
| 名称 | 类型 | 说明 |
|---|
数据集
| 数据 | 规模 | 备注 |
|---|
架构(摘要)
主干与结构
backbone:
参数:
类型:
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| Polyglot 编码(50 任务子集,5 runs) | 0.140 → 0.340(CI 0.300–0.380) | 原始 DGM 0.140 → 0.380(子集) | 80 次迭代、5 runs;全量 benchmark 0.084 → 0.267(CI 0.231–0.280),原始 DGM 0.142→0.307;§5.1 |
| 论文评审测试集分数 | 0.0 → 0.710(CI 0.590–0.750) | 静态基线(Yamada 2025)0.630;DGM-custom 0.590(CI 0.570–0.650);原始 DGM 0.0 | 100 次迭代;训练 10→100 题 staged 评估;验证分选 best 上测试集;§5.1 |
| 机器人奖励设计测试集分数 | 0.060 → 0.372(CI 0.355–0.436) | 直接优化评估指标的默认奖励 0.348;DGM-custom 0.348(CI 0.305–0.385);原始 DGM 0.0 | Genesis 环境、奖励可编译 + 策略训练;100 次迭代;§5.1 |
| IMO 级数学评分测试集(200 次迭代) | DGM-H + transfer 0.640(CI 0.550–0.720) | DGM-H 从初始 agent 起步 0.610(CI 0.510–0.680);ProofAutoGrader 0.670 | IMO-GradingBench 100/100/100 切分;transfer hyperagent 来自论文评审+奖励设计 run;§5.3 |
| 接入 ProofAutoGrader 的 full IMO-GradingBench | 准确率 0.561 → 0.601;MAE 0.178 → 0.175 | ProofAutoGrader 静态基线 | transfer meta agent + ProofAutoGrader 作 task agent;200 次迭代;附录 E.4(§5.3) |
| 对照消融(论文评审 / 奖励设计测试集) | DGM-H w/o self-improve:0.0 / 0.213;DGM-H w/o open-ended:0.0 / 0.116;均显著差于 DGM-H(p<0.05) | DGM-H 0.710 / 0.372 | 100 次迭代、同域评估;§5.1 |
Insights
- meta 层可编辑终结了「固定元层」与「meta-meta 无限递归」的两难:改进机制的机制就在同一个程序里,无需额外层级。
- metacognitive self-modification 让「改进如何改进」成为可搜索对象——元层改进(持久记忆、性能追踪)本身是跨领域可迁移的资产。
- 消除对齐假设:任何可计算任务都能把「任务表现提升」转化为「自改进能力提升」,编码不再是特例。
- 开放探索树的价值在非编码域同样成立:去掉 self-improve 或 open-ended 的对照都显著变差。
- 跨 run 累积(transfer hyperagent 在 IMO 评分上更快更高)为「复合自改进」提供了初步证据,尽管 p>0.05。
vs 同类工作
- 相
- 比
- D
- G
- M
- (
- 固
- 定
- 指
- 令
- 生
- 成
- 机
- 制
- 、
- 仅
- 编
- 码
- 域
- )
- ,
- D
- G
- M
- -
- H
- 让
- m
- e
- t
- a
- 层
- 可
- 编
- 辑
- 、
- 扩
- 展
- 到
- 任
- 意
- 可
- 计
- 算
- 任
- 务
- ;
- 相
- 比
- D
- G
- M
- -
- c
- u
- s
- t
- o
- m
- (
- 为
- 每
- 个
- 域
- 手
- 工
- 定
- 制
- 指
- 令
- 机
- 制
- )
- ,
- D
- G
- M
- -
- H
- 无
- 需
- 领
- 域
- 定
- 制
- ;
- 相
- 比
- A
- D
- A
- S
- 等
- 固
- 定
- m
- e
- t
- a
- -
- a
- g
- e
- n
- t
- 框
- 架
- ,
- m
- e
- t
- a
- a
- g
- e
- n
- t
- 本
- 身
- 是
- 进
- 化
- 对
- 象
- ;
- 相
- 比
- S
- T
- O
- P
- /
- A
- H
- E
- 等
- ,
- 多
- 了
- 元
- 层
- 机
- 制
- 的
- 自
- 进
- 化
- 。
局限
- 主实验的 parent selection 与评估机制仍手工固定(论文自承,为隔离变量);附录 E.5 对自动改进 parent selection 只有初步探索。
- 统计显著性有限:DGM-H vs DGM-custom 在论文评审/奖励设计上中位数更高但 p>0.05;transfer 增益(0.640 vs 0.610)同样 p>0.05。
- staged 评估规则(任一域失败记 0 分)可能惩罚多域联合优化的探索,作者在方法节说明了该规则的保守性。
- FM 能力是天花板:所有改进都发生在冻结 FM 的推理能力之内,自我加速的极限受基座模型约束。
- 5 runs 的统计只对 Polyglot 报告;论文评审与奖励设计的 CI 来自多次 run(附录),但主文未给逐域 run 数与随机种子清单。
- 安全边界:沙箱、超时、人工监督覆盖当前实验,但「自我修改可能加速到超过人类审计速度」的风险论文在安全节明确讨论,无自动防护机制。
可复现性
代码开源(github.com/facebookresearch/Hyperagents);附录给出初始 hyperagent 定义(A.1)、parent selection 与开放探索设置(A.2)、评估协议与 staged 规则(A.4)、元层修改日志与代码片段(E.3)、imp@k 与 transfer 选择机制(D.3/D.4);实验日志随仓库公开。
DGM-Hyperagents 架构:元层可编辑的进化循环
flowchart TD
    A["初始 hyperagent:task agent + meta agent 合成一个可编辑程序(冻结 FM + bash + 文件工具)"] --> B["档案 archive(单 agent 起步)"]
    B --> C["parent 采样:概率 ∝ 性能 / 孩子数,全部非零"]
    C --> D["分析过去表现与评估日志"]
    D --> E{"metacognitive self-modification:<br/>改 task agent 代码,还是改 meta agent 代码?"}
    E --> F["改 task 逻辑:提升目标任务表现"]
    E --> G["改 meta 机制:改进「如何生成未来改进」"]
    F --> H["分域 staged 评估(失败记 0 分)"]
    G --> H
    H --> I{"通过?"}
    I -- 是 --> B
    I -- 否 --> J["记 0 分 / 淘汰"]
    J --> B
    B --> K["输出:验证分最高的 task agent(imp@k 与 transfer 用)"]
组件详解
Hyperagent 结构:一个程序里同时存在两个角色——task agent 接收任务输入、输出解答;meta agent 接收「仓库位置、历史评估结果、剩余迭代预算」,负责修改任何代码。两个角色共用同一个可编辑代码库,因此 meta agent 可以改写自己。初始实现刻意简单:task 端是单次 FM 调用直接输出,meta 端只配了最基础的修改能力。
开放探索层:与 DGM 相同——档案保留所有 hyperagent,parent 选择按性能分与「有编辑能力的孩子数」平衡,全部非零概率。论文为隔离变量,把 parent selection 与评估机制固定在主实验之外,附录 E.5 才探索自动改进 parent selection。
Metacognitive self-modification:每轮 parent 决定改哪里。改 task 逻辑提升当前领域表现;改 meta 机制则让「下一轮怎么改」本身变得更好。论文观察到的元层产物包括性能追踪器(记录每代分数、计算改进趋势)与持久记忆(存因果笔记与前瞻计划,后续自修改主动查阅)。
分域 staged 评估:论文评审先 10 题、通过再 100 题;奖励设计先验「能编译」;任一域 staged 失败则整轮记 0 分。验证分(或训练分)选 best 上测试集。评估器按领域定制,是每轮选择与 imp@k 计算的唯一真值。
imp@k 与 transfer:imp@k 固定 meta agent、只生成 task agent,隔离出「元层生成能力」;transfer 用前一轮 run 中 imp@k 高的 hyperagent 启动新领域 run,检验元层改进能否跨 run 累积。
安全边界:沙箱执行、资源限制、人工监督;修改全程记录。论文明确讨论自我修改加速超过人类审计速度的潜在风险,当前无自动防护。
与 DGM 的结构差异一句话:DGM 的「自改进指令生成」是手工固定的独立机制(LLM call with fixed prompt),DGM-H 把它替换成可编辑的 meta agent——固定机制变成进化对象。这一替换的直接后果是领域无关性:DGM 换到论文评审域时固定指令失效(0.0 分),DGM-H 的 meta agent 会在该域重新学习怎么改,测试分 0.710。
为什么「元层可迁移」在结构上成立:持久记忆与性能追踪沉淀的是「评估-诊断-修正」的通用回路,与具体领域解耦;transfer 实验(IMO 评分 0.640 vs 0.610)验证了这一点,但 p>0.05,证据强度有限。主实验中 parent selection 未开放给自进化,意味着「选择谁繁殖」仍是人类的决定——这是通往全栈自进化的剩余一步。
DGM(上)与 DGM-Hyperagents(下)的架构对比
原文 caption:The Darwin Gödel Machine with Hyperagents. (Top) In the DGM, a coding agent evolves through open-ended exploration; the instruction-generation mechanism that drives self-improvement is fixed and handcrafted. (Bottom) In the DGM-H, the task agent and meta agent are combined into a single modifiable program called a hyperagent, making the meta-level improvement mechanism editable. (caption 精简自原文)
一张图讲清两代系统的分界:上面 DGM 的自改进指令由「手工固定的 instruction-generation 机制」产生(图中用 LLM call (fixed prompt) 标出),下面 DGM-H 把 meta agent 与 task agent 合成一个可编辑程序,meta 层本身进入进化循环。读图对比两半的「固定」与「可编辑」标注,这是全篇核心贡献的位置。
论文评审与机器人奖励设计上的改进曲线
原文 caption:Metacognitive self-modification and open-ended exploration enable the DGM-H to continue making progress. (Left) The DGM-H optimizes for diverse tasks within the same run. (Right) Best discovered task agents are evaluated on test tasks in paper review and robotics reward design. (caption 精简自原文)
证明 DGM-H 能在非编码领域自我改进:论文评审测试集从初始的 0.0 涨到 0.710,机器人奖励设计从 0.060 涨到 0.372;对照栏里原始 DGM 两域都是 0.0(它的固定指令机制不适用于非编码任务),DGM-custom(为每个领域手工定制)分别是 0.590 与 0.348。读法:成对柱对比 DGM-H 与各类基线,看置信区间。
跨 run 累积:transfer hyperagent 在 IMO 评分上的表现
原文 caption:Self-improvements learned by the DGM-H accumulate across domains and runs. Initializing from transferred hyperagents leads to faster progress and higher final performance than initializing from the initial agent. (caption 精简自原文)
支撑「元层改进可跨 run 累积」:用之前 run(论文评审 + 奖励设计)得到的 transfer hyperagent 启动 IMO 级数学评分的新 run,200 次迭代后测试分 0.640,高于从初始 agent 起步的 0.610(p>0.05,中位数更高);把 ProofAutoGrader 当 task agent 接入后达到 0.700,超过基线 0.670。读法:对比两条曲线的起点速度与终点高度。
让「修改自己的机制」也参与进化:Hyperagents(对话版)
小播:今天聊 Meta FAIR 和 UBC 的 Hyperagents。一句话先给结论:之前有个系统叫 DGM,能让编码 agent 改自己的代码越改越强,但它的「自改进指令生成机制」是手工写死的;这篇把 task agent 和 meta agent 合成一个可编辑程序,让「生成未来改进的机制」本身也能被改,结果在论文评审、机器人奖励设计这些非编码任务上,也跑出了持续改进。
老播:最直观的数字:论文评审的测试集分数,从初始的 0.0 涨到 0.710;机器人奖励设计从 0.060 涨到 0.372。对照一下,为每个领域手工定制机制的 DGM-custom,分别是 0.590 和 0.348。
小播:先记第一个记忆锚点:它改的不只是任务逻辑,还有「怎么改」这件事本身。
第一段:它要解决什么问题
老播:背景是自改进系统的两难。方案一:固定一个 meta agent 去改 base 系统,base 只能在 meta 划定的边界里改进,上限被锁死。方案二:加 meta-meta 去改 meta——问题只是被推高一层,最后陷入无限递归。
小播:DGM 不是已经能自改进了吗?
老播:能,但只在编码域。DGM 能自我加速,靠的是一个隐蔽的对齐假设:下游任务(改代码)和自我改进(也是改代码)是同一件事。换个领域,比如论文评审,任务表现和自改进能力就断了——DGM 的固定指令机制在非编码域直接失效,测试分是 0.0。Hyperagents 的解法是结构性的:把 meta agent 融进同一个可编辑程序,没有单独的固定机制可失效。
第二段:循环怎么转
老播:结构上,hyperagent 是「task agent 加 meta agent 合成一个可编辑程序」。task agent 负责解任务,meta agent 负责修改 agent、生成新 agent——而 meta agent 的修改机制本身也是程序的一部分,可以被 meta agent 自己改。这个过程叫 metacognitive self-modification,元认知式自修改。
小播:进化循环还是 DGM 那套吗?
老播:是。档案存所有 hyperagent,parent 按性能分正比、有编辑能力的孩子数反比来采样,全部保留非零概率。每轮 parent 分析过去表现,决定改哪块代码——可以改 task 逻辑,也可以改 meta agent 自身。评估按领域分 staged:论文评审先 10 题、过了再 100 题,任一域失败整轮记 0 分;用验证分选最优上测试集。
小播:怎么量化「meta agent 会改进 task agent」?
老播:论文给了个指标 imp@k:固定 meta agent、让它最多生成 k 个新 task agent,测试性能的提升量。对比 meta 可编辑(DGM-H)和 meta 固定(DGM-H w/o self-improve)的 imp@k,就能看出元层自修改的增量价值。
小播:第二个记忆锚点:imp@k 把「元层的生成能力」从任务表现里单独拆出来量。
第三段:关键结果
老播:全部带 baseline 和 setup。编码,Polyglot 50 任务子集,5 次 run、80 迭代:0.140 涨到 0.340,置信区间 0.300 到 0.380,对照原始 DGM 的 0.140 到 0.380——没做任何编码特化,效果接近。论文评审,100 迭代:测试集 0.0 到 0.710,静态基线 Yamada 是 0.630,DGM-custom 0.590。奖励设计,Genesis 环境:0.060 到 0.372,默认奖励函数 0.348,DGM-custom 0.348。两个非编码域上原始 DGM 都是 0.0。
小播:元层的改进能带走吗?
老播:这是最有意思的部分。在论文评审加奖励设计两个域跑出来的 transfer hyperagent,拿去启动 IMO 级数学评分的新 run,200 迭代后测试分 0.640,从初始 agent 起步只有 0.610;把 ProofAutoGrader 当 task agent 接入,到 0.700,超过基线 0.670。全量 IMO-GradingBench 上,准确率从 0.561 提到 0.601。
小播:它自动长出了什么元层工具?
老播:两个很典型。性能追踪器:记录每代分数、算改进趋势,自动判断哪些改动方向值得继续。持久记忆:存「哪几代最好、哪些改动过度纠正」的因果笔记和前瞻计划,后续自修改会主动查阅——等于把「教训」沉淀进程序本身。
小播:第三个记忆锚点:持久记忆和性能追踪是跨领域可迁移的元层资产。
第四段:局限
小播:冷水。哪里要打折?
老播:四条。第一,主实验的 parent selection 和评估机制还是手工固定的,作者自己说这是为了隔离变量,附录 E.5 才对自动改进 parent selection 做了初步探索——全栈自进化还没实现。第二,统计显著性有限:DGM-H 对 DGM-custom 的优势,还有 transfer 的 0.640 对 0.610,都是 p 大于 0.05,方向对但不够硬。第三,FM 能力是天花板:所有改进都在冻结模型的能力圈里。第四,安全:沙箱、超时、人工监督覆盖当前实验,但论文明确讨论了自我修改加速到超过人类审计速度的风险,没有自动防护。
小播:5 次 run 的统计只给了 Polyglot?
老播:对,其它域在附录里有置信区间,但主文没给逐域 run 数和随机种子清单,复现时得去仓库里核对。
收尾:一句话记住这篇
老播:收尾。Hyperagents 把 task agent 和 meta agent 合成单个可编辑程序,让「生成未来改进的机制」本身进入进化循环,解开固定元层的死结,把自改进从编码域推广到任意可计算任务。最该记住的数字:论文评审测试集 0.0 到 0.710,对照手工定制机制的 DGM-custom 0.590。最该记住的保留:parent selection 仍是手工固定的,元层自进化的主实验还没跑。
小播:这篇值得读,它是「递归自改进」从编码特例走向通用框架的一步。我们下期见。