Meta-Harness:让 coding agent 去搜「模型外面的代码」
> 量子位技术拆解 · 先给现象再给机制。完整结构化数据见「速查」tab。
先看一个现象:LLM 系统的性能,权重只占一半。另一半是 harness——决定存什么、取什么、呈现什么的代码。论文引用了一个数字:同一 benchmark 上,只换 harness 能差约 6 倍。可 harness 主要靠人调。能不能让机器自己搜?
现有 text optimizer 接不住这个活,因为它们的反馈通道太窄:AlphaEvolve 只给分数、TextGrad 只看最近一次、GEPA 只给一段摘要。harness 优化发生在代码空间——检索策略、prompt 构造的小改动要多步之后才显形——需要看完整的源码和执行轨迹才能诊断。Meta-Harness(arXiv 2603.28052)的答案很直接:让 coding agent 当 proposer,通过文件系统访问所有先例的代码、分数与执行轨迹,再提案新 harness。
核心机制:一个「优化 harness 的 harness」
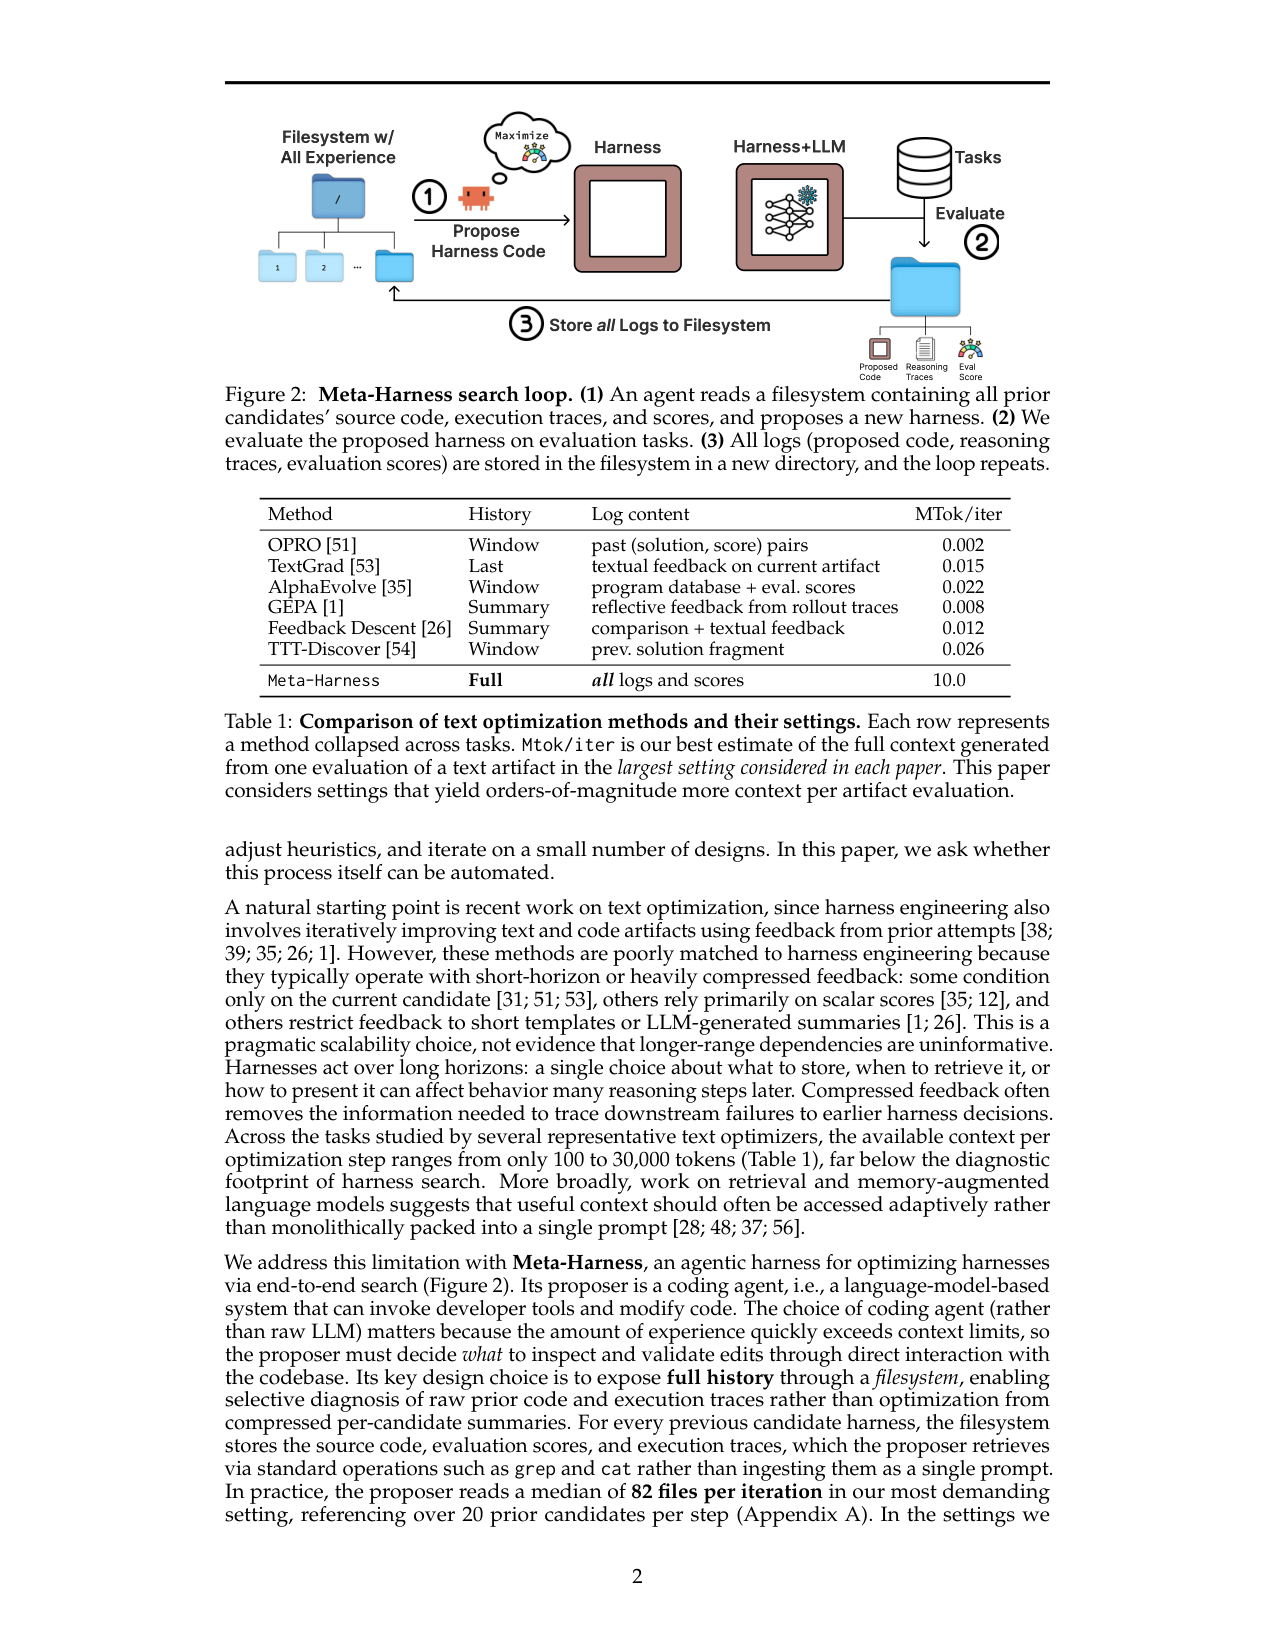
Meta-Harness 本身就是一个 harness——它决定 proposer 在搜索时能看到什么信息。循环三步(Figure 2):
1. 提案:coding agent 用 grep、cat 等工具检索文件系统里的历史——每个候选 harness 的源码、评估分数、执行轨迹(prompt、工具调用、状态更新)各占一个目录。它先看先例、形成失败假设,再生成新 harness。
2. 评估:在搜索集任务上跑候选 harness,算 reward(文本分类准确率、IMO 数学题通过率、TerminalBench-2 pass rate)。
3. 归档:候选的代码、轨迹、分数全部写回文件系统新目录,循环继续。
搜索的形式化目标很简单:找让固定模型 $M$ 在任务分布 $X$ 上期望奖励最大的 harness:
$$H^{*} = \arg\max_{H}\; \mathbb{E}_{x \sim X,\; \tau \sim p_M(H,x)}\, r(\tau, x)$$
$\tau$ 是 rollout 轨迹,$r$ 是任务 reward。多目标时(准确率 vs 上下文成本)按 Pareto dominance 评估,最终只在 Pareto 前沿上做测试集终评——测试集结果 proposer 全程看不到,防止过拟合。
设计上刻意「少结构」:维护种群和 Pareto 前沿,但没有父选择规则——proposer 自由检查任何先例,把诊断和编辑决策全交给 agent。论文的理由:随着 coding agent 变强,这套系统自动变好,不需要手工重写搜索启发式。
这里值得停下来强调「信息通道」这个设计维度:Meta-Harness 每迭代读约 10.0 MTok 的上下文(Table 1),而 OPRO 只要 0.002、GEPA 只要 0.008——差了三到四个数量级。主流方法把反馈压缩成标量或摘要来省 token,Meta-Harness 反其道而行:让 proposer 用 grep/cat 按需检索,全量存档、局部读取。这个「存全量、读局部」的组合,是它能诊断失败根因的关键,也是它贵的原因。
关键结果:三个域,三种证据
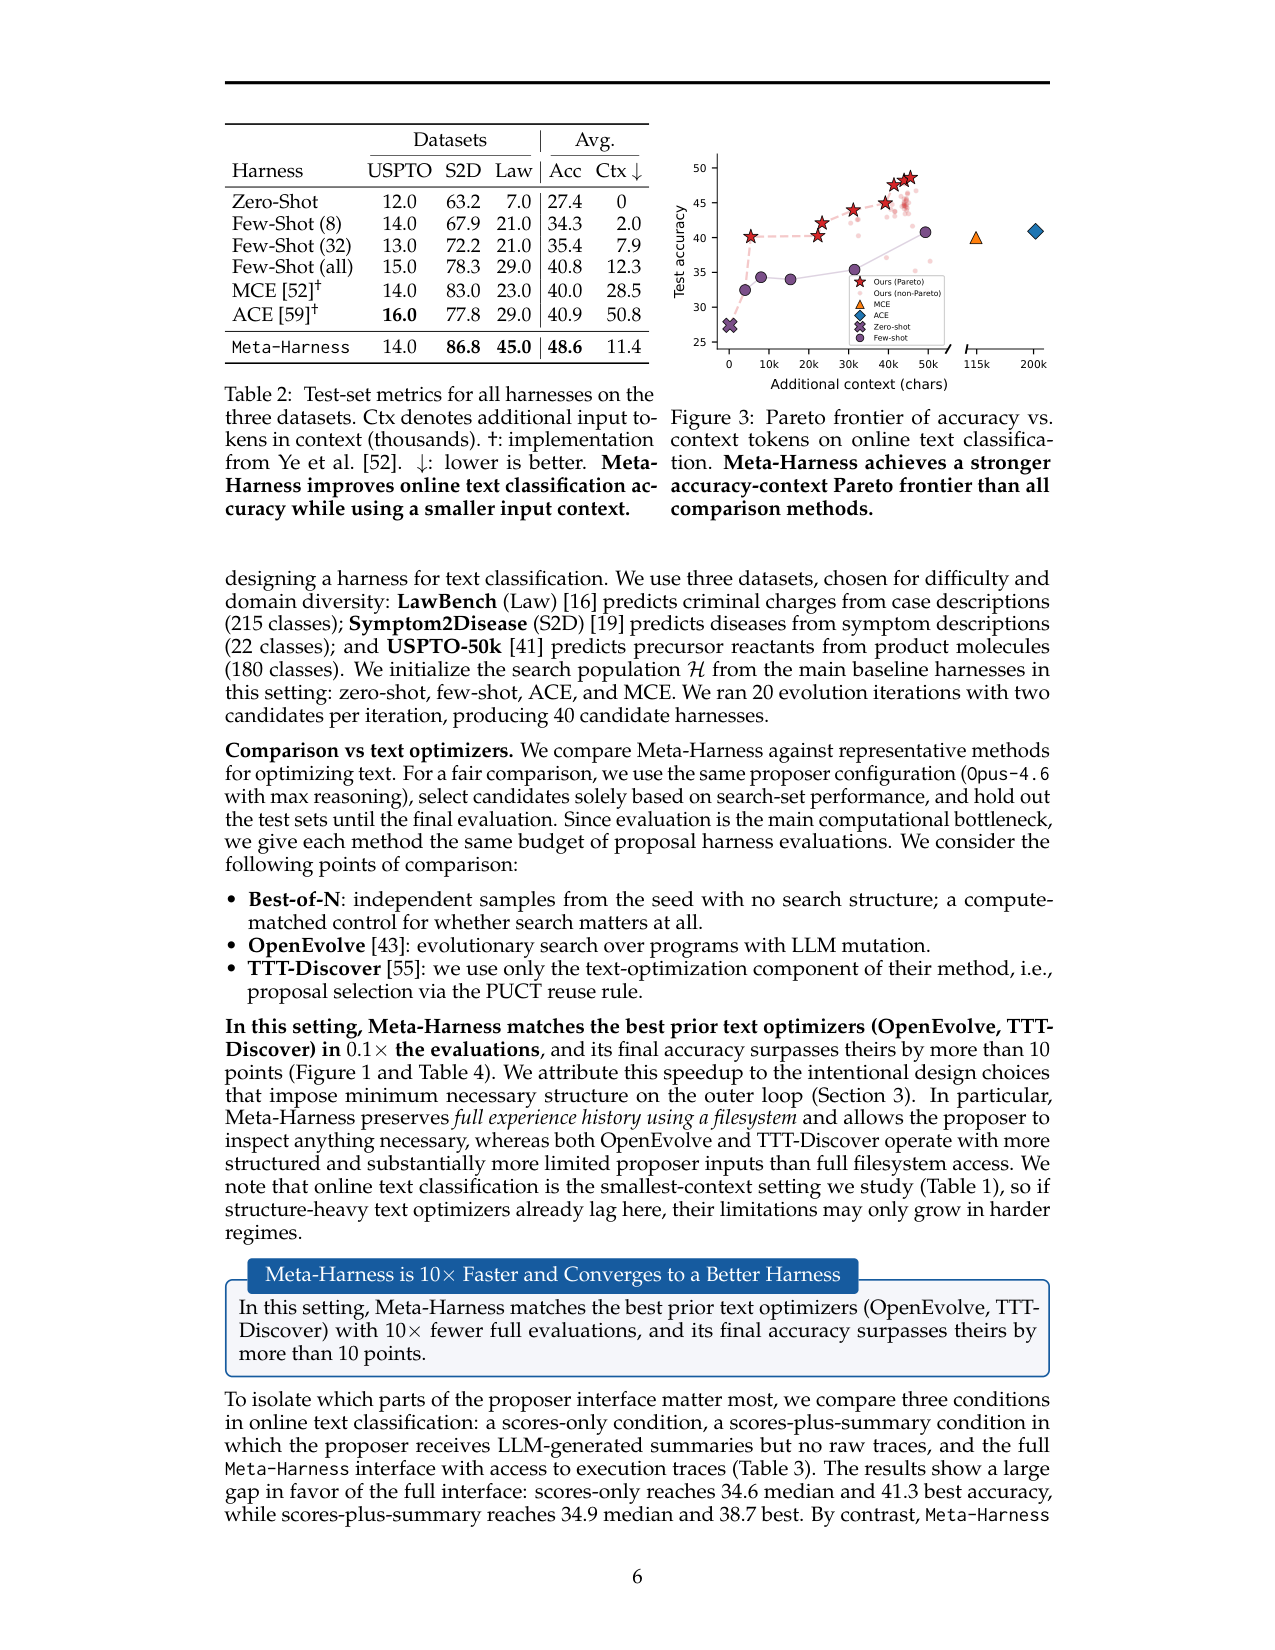
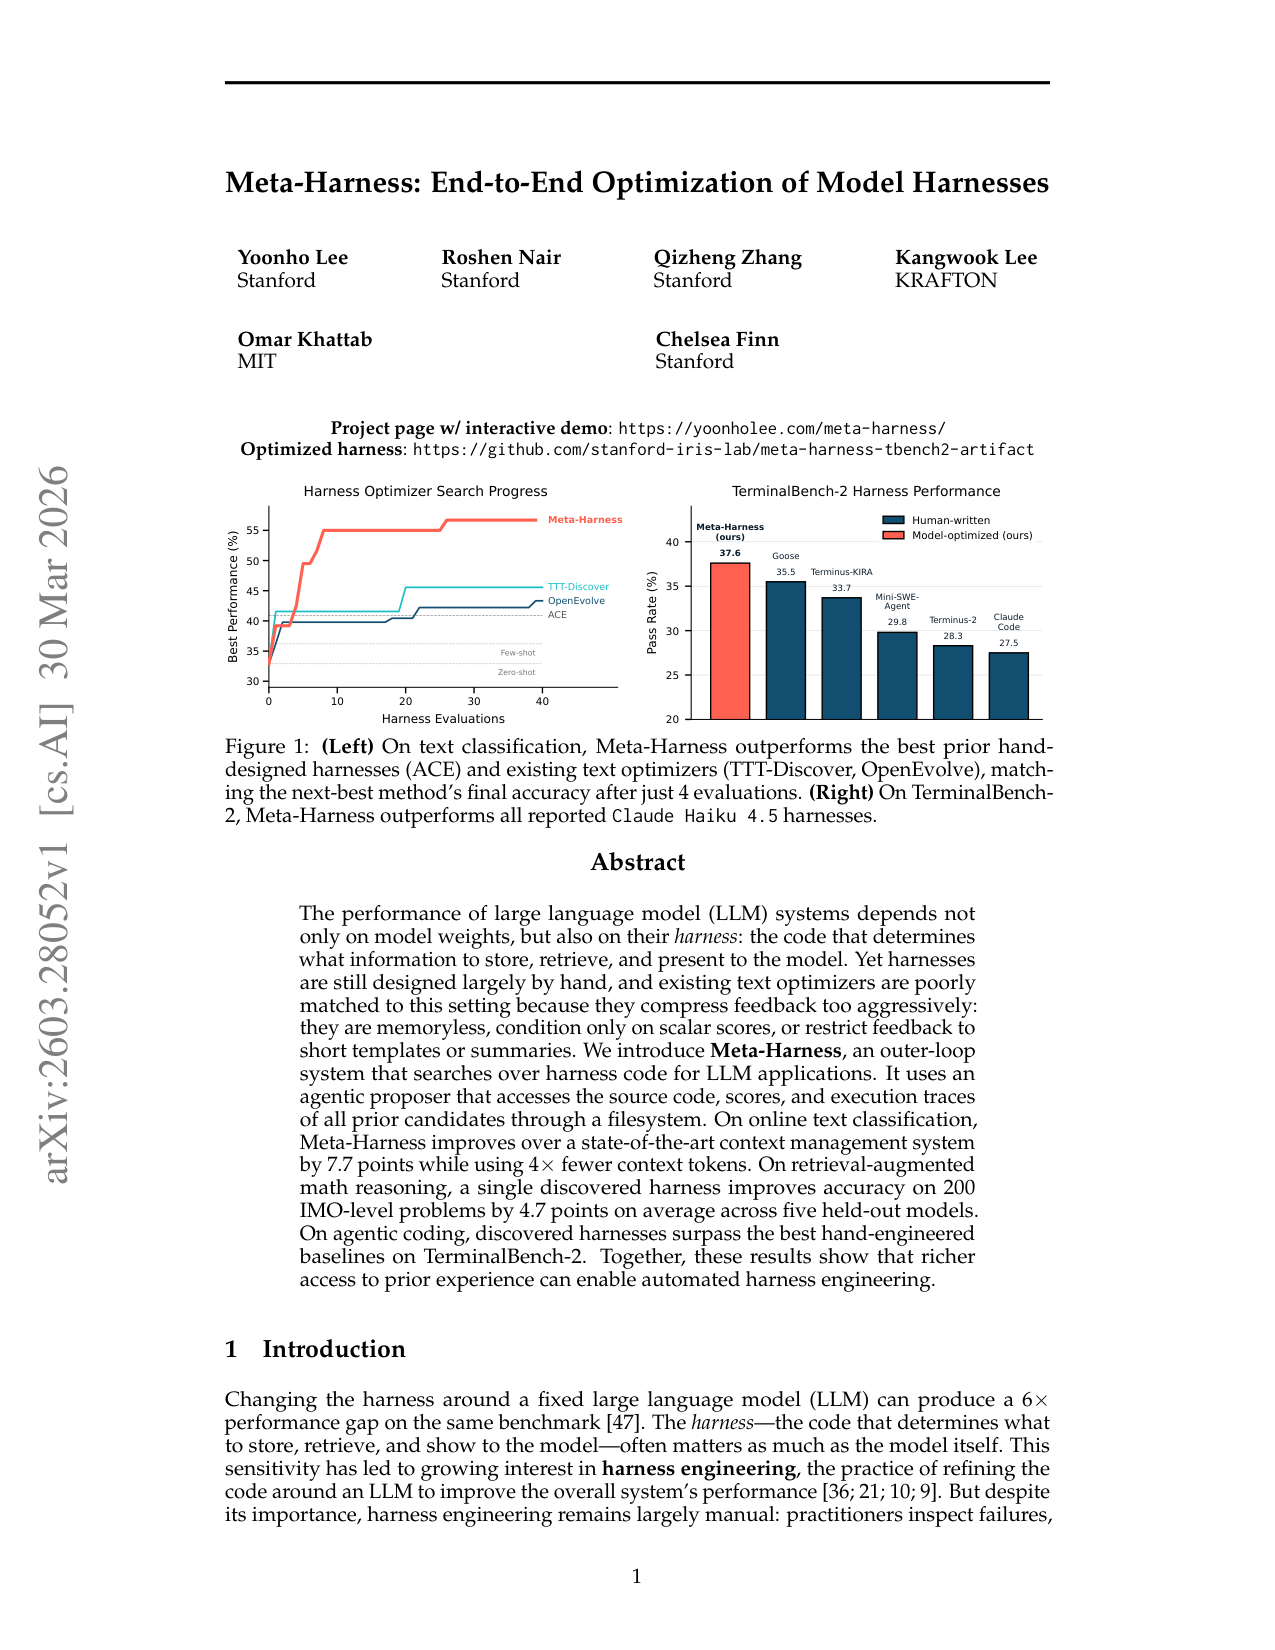
在线文本分类(LawBench / Symptom2Disease / USPTO-50k,20 迭代 × 2 候选):平均 48.6%,对 ACE 40.9%、MCE 40.0%、few-shot(all) 40.8%(Table 2);附加上下文 11.4K token,ACE 要 50.8K——高 7.7 个点且上下文少约 4×。Pareto 前沿完全覆盖对照方法(Fig.3)。同等评估预算下,4 次评估内追上 OpenEvolve/TTT-Discover 的最终精度,最后高出 10+ 点。
最干净的证据是反馈通道消融(Table 3):只给分数,中位 34.6;分数+摘要,34.9——摘要帮不上忙;全接口(含原始执行轨迹),50.0。执行轨迹是搜索质量的关键成分。
数学推理:搜出的一条检索 harness 在 200 道未见 IMO 级题上,跨 5 个未见模型平均 +4.7 个点(over 无检索),整体超 BM25 检索 1.3 个点——搜索时只见过 GPT-OSS-20B,评估却用 GPT-5.4 系与 Gemini-3 系,跨模型迁移成立。
TerminalBench-2(89 个长 horizon 终端任务):Claude Haiku 4.5 下 37.6% pass rate,超越全部已报告的人类设计 harness(Goose 35.5%、Terminus-KIRA 33.7%、Claude Code 27.5%);Opus 4.6 下 76.4%,超 Terminus-KIRA 74.7%。proposer 自己提出的关键修改是环境 bootstrap:进 agent 循环前先快照沙箱并注入初始 prompt,省掉前 2–4 轮探索。
局限与代价
1. 贵:每迭代约 10.0 MTok(Table 1),GEPA 只要 0.008——全经验访问的代价高 3 个数量级,proposer 还必须是 Claude Code 级 coding agent。
2. 单一 proposer:只测了 Opus-4.6 配置,换 proposer 的效果未研究(§5 自承)。
3. TerminalBench-2 的评估与搜索同集:89 个任务既是搜索集又是终评集,作者用人工检查 + regex 审计防泄漏,但 benchmark 特异性无法完全排除(§4.3 自承)。
4. 模糊评估场景未覆盖:reward 明确的三个域之外,开放式生成的 reward hacking 与归因问题仍开放;也没有多样性控制,种群可能坍缩。
一句话记住这篇
Meta-Harness 把 harness 优化从「压缩反馈的文本优化」换成「全文件系统反馈的代码搜索」:coding agent 提案、搜索集评估、全量归档、Pareto 前沿终评。最该记住的数字是:文本分类 48.6% 对 ACE 40.9%(+7.7),上下文少 4×;数学 harness 跨 5 个未见模型平均 +4.7 点;最该记住的代价是——每迭代 10 MTok,它是用计算换诊断。
把「决定存什么/取什么/呈现什么」的 harness 代码本身当优化对象:coding-agent proposer 通过文件系统访问所有先例的源码、分数与执行轨迹来提案新 harness,产出 Pareto 前沿候选;在线文本分类比 ACE 高 7.7 个点且上下文 token 少 4×,数学检索 harness 跨 5 个未见模型平均 +4.7 点,TerminalBench-2 超越全部已报告的人类设计 harness。
问题
要解决什么:LLM 系统的性能同时取决于权重与 harness——决定存什么、取什么、呈现什么的代码;同一 benchmark 上换 harness 可产生约 6× 性能差。但 harness 主要靠人手调,而现有 text optimizer 的反馈通道太窄:只给分数(AlphaEvolve)、只看最近一次(TextGrad)、或只给 LLM 摘要(GEPA),无法支撑对代码空间 harness 的诊断式改进。
为什么 prior work 不够:harness 优化发生在代码空间:检索、记忆、prompt 构造的小改动会多步之后才显形,局部搜索启发式不匹配;主流 text optimizer 每迭代只消耗 0.002–0.026 MTok 上下文(Table 1),而 harness 搜索需要查看完整源码与执行轨迹(Meta-Harness 每迭代约 10.0 MTok)——反馈压缩是根本障碍。
进化循环(搜索空间 → 算子 → 评估 → 选择)
搜索空间(什么被进化):harness 代码:围绕固定 LLM 的有状态程序(存什么/取什么/呈现什么,含检索、记忆、prompt 构造、工具调用逻辑);可编辑表面是 harness 源文件;评估任务、验证器与测试集只读——proposer 只能看到搜索集结果。
变异/提案算子:
- coding-agent proposer:用 grep/cat 等终端工具选择性检查文件系统里的先例代码/分数/执行轨迹,形成失败假设后提案新 harness(局部编辑或大幅改写)
- 无父选择规则:proposer 自由检查任何先例,不做 parent-selection 硬编码
- 评价-记录循环:每个候选的代码+轨迹+分数存进文件系统新目录,供后续迭代检索
评估方式:搜索集上的任务 reward:在线文本分类准确率(LawBench/Symptom2Disease/USPTO-50k,20 迭代 × 2 候选 = 40 个 harness)、检索增强数学推理(200 道未见 IMO 级题,GPT-OSS-20B 搜索、5 个未见模型评估)、TerminalBench-2 pass rate(89 任务);多目标(准确率 vs 上下文成本)时按 Pareto dominance 评估。
选择与归档:维护种群 H 与 Pareto 前沿(准确率 vs 上下文 token),无淘汰硬规则;固定迭代数后只在 Pareto 前沿上做测试集终评;测试集结果 proposer 全程不可见,只防过拟合于搜索集。
自我改进程度:L1:基座模型固定,harness 代码自进化;Meta-Harness 自身也是 harness(决定 proposer 看到什么信息),论文把「全文件系统反馈通道」当作主要贡献;future work 明确提出与模型权重联合优化(L2)。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|
输出
| 名称 | 类型 | 说明 |
|---|
数据集
| 数据 | 规模 | 备注 |
|---|
架构(摘要)
主干与结构
backbone:
参数:
类型:
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| 在线文本分类平均准确率(USPTO-50k / Symptom2Disease / LawBench) | 48.6% | ACE 40.9%;MCE 40.0%;Few-shot(all) 40.8%;zero-shot 27.4% | Table 2(p6);附加上下文 11.4K token vs ACE 50.8K——高 7.7 个点且少约 4× 上下文 |
| 相对 text optimizer 的收敛速度 | 4 次评估内追上 OpenEvolve/TTT-Discover 的最终精度(0.1× 评估数),最终高出 10+ 点 | OpenEvolve、TTT-Discover(同 proposer 配置 Opus-4.6、同评估预算) | §4.2 + Fig.1(p6);online text classification 设置 |
| 反馈通道消融(中位/最佳准确率) | scores-only 34.6/41.3;scores+summary 34.9/38.7;全接口 50.0/56.7 | scores-only 与 scores+summary 两种压缩反馈 | Table 3(p7);访问原始执行轨迹是搜索质量的关键成分,摘要反而压缩掉诊断信息 |
| 检索增强数学推理(200 道未见 IMO 级题) | 跨 5 个未见模型平均 +4.7 个点(over 无检索);整体超 BM25 检索 1.3 个点 | 无检索、dense 检索(text-embedding-3-small)、随机 few-shot、BM25 | Table 6(p8);搜索用 GPT-OSS-20B,评估含 GPT-5.4-nano/mini、Gemini-3.1-Flash-Lite、Gemini-3-Flash,3 采样取平均 |
| TerminalBench-2 pass rate(Claude Haiku 4.5) | 37.6% | Goose 35.5%;Terminus-KIRA 33.7%;Mini-SWE-Agent 29.8%;Claude Code 27.5% | Table 7(p9);Meta-Harness 在 Haiku-4.5 全部已报告 harness 中排第一;Opus 4.6 下 76.4% 超 Terminus-KIRA 74.7%、仅次于 ForgeCode 81.8% |
| 上下文/评估成本对照 | 每迭代约 10.0 MTok | OPRO 0.002 / TextGrad 0.015 / AlphaEvolve 0.022 / GEPA 0.008 MTok | Table 1(p2)——全经验访问的代价高一个量级以上,但换回的是诊断式搜索 |
Insights
- 反馈通道决定搜索质量:执行轨迹 > 摘要 > 分数(Table 3),摘要甚至会压缩掉诊断性细节——这与主流 text optimizer 的『压缩反馈』路线方向相反。
- harness 搜索必须跑在代码空间:检索策略、prompt 构造、记忆逻辑的小改动影响多步之后的行为,proposer 需要看原始代码与轨迹形成假设,局部启发式不匹配。
- 发现的 harness 可迁移:文本分类 harness 泛化到 OOD 数据集、数学 harness 跨 5 个未见模型——代码空间的过拟合比权重空间更可检查(brittle if-chain 一眼可见)。
- 终端任务的工程洞察:环境 bootstrap(进 agent 循环前先快照沙箱、注入初始 prompt)消除前 2–4 轮探索,是 TerminalBench-2 提升的主因(Fig.9,proposer 自己提出的假设)。
vs 同类工作
- vs ACE/MCE(上下文工程):它们只优化上下文内容且带手工 schema;Meta-Harness 优化整段 harness 代码(检索、记忆、prompt 构造、工具调用),无结构预设。
- vs OpenEvolve/TTT-Discover(text optimizer):它们用窗口/最近/摘要反馈;Meta-Harness 用全文件系统,同等评估预算下 0.1× 收敛、最终高 10+ 点。
- vs GEPA:GEPA 反思式 prompt 进化、feedback 是总结;Meta-Harness 保留全部原始轨迹供 proposer 按需 grep/cat。
局限
- 计算开销大:每迭代约 10.0 MTok(Table 1),proposer 需 Claude Code 级 coding agent;论文没给总成本账本,token 量级比传统优化器高 3–4 个数量级。
- 单一 proposer:只用 Claude Code(Opus-4.6 配置),跨 proposer 效果差异未研究(§5 自承)。
- TerminalBench-2 是发现型设置:搜索与终评在同一个 89 任务集上,作者靠人工检查 + regex 审计防泄漏,但 benchmark 特异性无法完全排除(§4.3 自承)。
- 评估信号依赖:文本分类/数学/终端任务都有明确 reward;模糊评估(开放式生成)下 reward hacking 与归因问题仍开放。
- 无显式多样性控制:没有 parent-selection 规则也没有新颖性惩罚,种群可能坍缩到局部模式;论文未报告多样性指标。
可复现性
- code:https://github.com/stanford-iris-lab/meta-harness-tbench2-artifact
- notes:项目页含交互式 demo:https://yoonholee.com/meta-harness/;文本分类设置 20 迭代 × 2 候选,proposer 配置 Opus-4.6 max reasoning,评估与搜索超参在附录给出。
Meta-Harness 架构:harness 进化循环数据流
Mermaid 数据流
flowchart TD
    subgraph FS["文件系统(全经验)"]
        D1["候选 1:代码 + 分数 + 轨迹"]
        D2["候选 2:代码 + 分数 + 轨迹"]
        DN["候选 N:代码 + 分数 + 轨迹"]
    end

    P["Coding-agent Proposer\n(Claude Code / Opus-4.6)"] -->|"grep / cat 选择性检查\n先例代码、分数、执行轨迹"| FS
    P -->|"形成失败假设 → 提案新 harness"| H["新 Harness 代码"]
    H --> E["评估\n(搜索集任务)"]
    E -->|"奖励 r(τ, x):\n准确率 / pass rate / 数学通过率"| P
    E -->|"代码 + 轨迹 + 分数全量归档"| FS
    E --> POP["种群 + Pareto 前沿\n(准确率 vs 上下文成本)"]
    POP -->|"固定迭代数后测试集终评"| FINAL["最终 Pareto 前沿"]
    TASKS["评估任务(只读)\n文本分类 / IMO 数学 / TerminalBench-2"] --> E
组件详解
- Coding-agent Proposer(提案器):核心创新点。它是有工具调用能力的编码 agent,通过终端工具(grep/cat)按需检索文件系统,而不是把全部经验塞进 prompt。提案前先看先例的源码、分数、轨迹,形成「上次为什么失败」的假设,再决定局部编辑还是大幅改写。诊断与编辑决策完全委托给 agent——没有手工编码的搜索启发式。
设计要点
1. 反馈通道宽度 = 搜索质量:全文件系统(10.0 MTok/迭代)相比分数/摘要(0.008–0.026 MTok)高 3 个数量级,换来的是诊断式搜索——4 次评估内追平 text optimizer 的最终精度。
2. 代码空间搜索:harness 是程序,搜索在代码空间进行——小改动影响多步后行为,需要原始轨迹才能归因;代码空间的过拟合(brittle if-chain、硬编码映射)可读可查。
3. 可迁移性:发现的 harness 泛化到 OOD 数据集与未见模型(数学 +4.7 点跨 5 模型),说明学到的是可复用策略而非 benchmark 特化。
4. 只读边界:评估任务、验证器、测试集对 proposer 只读——这是「搜索期间不看测试集」的防过拟合设计,也是 TerminalBench-2 这种发现型设置下做泄漏审计的前提。
两域战绩:文本分类超 ACE,TerminalBench-2 超全部人类设计 harness
原文 caption:(Left) On text classification, Meta-Harness outperforms the best prior hand-designed harnesses (ACE) and existing text optimizers (TTT-Discover, OpenEvolve), matching the next-best method's final accuracy after just 4 evaluations. (Right) On TerminalBench-2, Meta-Harness outperforms all reported Claude Haiku 4.5 harnesses.
证明「端到端 harness 优化可行」:左面板展示 4 次评估内追平最佳 text optimizer 的最终精度、最终超 10+ 点;右面板展示 TerminalBench-2 上 37.6% pass rate 超越全部已报告 Claude Haiku 4.5 harness(Goose 35.5%)。读法:看左图收敛速度与右图榜单位置。为什么重要:一张图同时给出「更快的搜索」与「更强的结果」两个论断,是站点封面。
Meta-Harness 搜索循环:提案→评估→全量归档
原文 caption:Meta-Harness search loop. (1) An agent reads a filesystem containing all prior candidates' source code, execution traces, and scores, and proposes a new harness. (2) We evaluate the proposed harness on evaluation tasks. (3) All logs are stored in the filesystem in a new directory, and the loop repeats.
展示机制:proposer 通过文件系统访问全部经验(代码+轨迹+分数),评估后把完整日志归档再循环。读法:看反馈通道是「全文件系统」而非压缩摘要——这与 Table 1 里 GEPA/TextGrad 的 summary/window 反馈形成对照。为什么重要:它把「反馈通道宽度决定搜索质量」的论文论点可视化,是架构核心证据。
准确率-上下文成本的 Pareto 前沿:全面强于对照
原文 caption:Pareto frontier of accuracy vs. context tokens on online text classification. Meta-Harness achieves a stronger accuracy-context Pareto frontier than all comparison methods.
证明「多目标同时更优」:Meta-Harness 的 Pareto 前沿(准确率 vs 附加上下文字符)覆盖并超过 ACE、MCE、few-shot 与 zero-shot。读法:看散点云的右上边界——同一准确率下 Meta-Harness 用的上下文更少。为什么重要:它回应「长上下文换精度」的质疑:更好的 harness 可以在更高精度和更低上下文成本之间取得帕累托优势。
让编程 agent 去搜索「模型外面的代码」(对话版)
小播:今天聊一篇斯坦福的论文,主题是:LLM 系统的另一半性能——模型外面的代码——能不能让机器自己搜出来?
老播:这篇叫 Meta-Harness。一句话结论:让一个编程 agent 当搜索器,通过文件系统访问所有历史候选的源码、分数和执行轨迹,自己去提案新的 harness,最终产出一批帕累托前沿的候选。在在线文本分类上,它比当前最强的手工 harness ACE 高 7.7 个点,上下文还少了 4 倍。
小播:等等,harness 是什么?为什么值得专门搜?
老播:harness 就是决定模型存什么、取什么、怎么呈现的代码——检索、记忆、prompt 构造、工具调用都在里面。论文引了一个数字:同一个 benchmark,只换 harness 能差约 6 倍。所以权重之外,这半边天很大。
为什么现有优化器接不住
小播:那为什么以前没自动搜?
老播:因为主流文本优化器的反馈通道太窄了。有的只给分数,有的只看最近一次结果,有的只给一段摘要。可 harness 是代码:改一个检索策略,要很多步之后才显形。你光看分数和摘要,根本不知道哪一步错了。
小播:所以 Meta-Harness 的答案是?
老播:把反馈通道换成整个文件系统。每个评估过的候选 harness,源码、分数、执行轨迹都存一个目录。搜索器用 grep、cat 这些工具按需查看,形成「上次为什么失败」的假设,然后提案新版本。评估完,新候选的全套日志再存回去,循环往复。
小播:也就是说,搜索器自己决定看什么?
老播:对,记住这个记忆锚点:它连「选哪个父代」的规则都没有写死——搜索器可以自由检查任何先例,诊断和编辑决策全交给 agent。论文的理由是,随着编程 agent 变强,这套系统自动变好,不用人重写搜索启发式。
关键证据:反馈通道的消融
小播:怎么证明「看全量轨迹」真的有用?
老播:论文做了个特别干净的消融,三种信息接口:只给分数,中位准确率 34.6;分数加摘要,34.9——摘要几乎没帮忙;给全量执行轨迹,50.0。轨迹这一项,直接拉开 15 个点的差距。
小播:摘要怎么会没用呢?
老播:因为摘要会把诊断性细节压掉。这正好是它和 GEPA 这类方法的分水岭——GEPA 每迭代只要 0.008 MTok 的上下文,Meta-Harness 要 10.0 MTok,贵了三个数量级,但换回的是能归因的原始证据。
数字:三个域
小播:三个域的完整战绩?
老播:在线文本分类,三个数据集平均 48.6%,对 ACE 的 40.9%、MCE 的 40.0%;附加上下文 11.4K token,ACE 要 50.8K。同等评估预算下,它 4 次评估就追上 OpenEvolve 和 TTT-Discover 的最终精度,最后还高出 10 多个点。
小播:数学呢?
老播:它搜出一条检索 harness,在 200 道没见过的 IMO 级题上,跨 5 个没见过的模型平均提升 4.7 个点。注意:搜索时只见过 GPT-OSS-20B,评估用的是 GPT-5.4 系和 Gemini-3 系——跨模型迁移成立。
小播:终端任务?
老播:TerminalBench-2,89 个长 horizon 任务。Claude Haiku 4.5 上 37.6% 的通过率,超过所有已报告的人类设计 harness:Goose 35.5%、Terminus-KIRA 33.7%、Claude Code 27.5%。Opus 4.6 上 76.4%,超 Terminus-KIRA 的 74.7%,只输给 ForgeCode。
小播:它搜出来的关键修改是什么?
老播:先记一个记忆锚点:搜索器从不看测试集——它的反馈只来自搜索集和轨迹日志,这是防过拟合的硬边界,也是这个系统敢说自己「搜的是可迁移策略」的前提。
老播:很有意思,是环境 bootstrap——进 agent 主循环之前,先跑一条复合命令把沙箱环境快照下来,注入初始 prompt。这样省掉了前两到四轮的探索。这是搜索器自己在日志里提出的假设,不是人设计的。
泼冷水:10 MTok 换诊断
小播:代价呢?
老播:第一,贵。每迭代约 10 个 MTok 的上下文,比 GEPA 高三个数量级,而且搜索器必须是 Claude Code 这个级别的编程 agent。第二,只测了一个搜索器配置,换一个效果未知。第三,TerminalBench-2 的评估和搜索在同一个 89 任务集上做,作者靠人工检查加正则审计防泄漏,但基准特异性没法完全排除。
小播:还有别的吗?
老播:它只在 reward 明确的任务上验证过。开放式生成这种模糊评估场景,reward hacking 和归因问题还完全开放。而且它没有显式的多样性控制——没有新颖性惩罚,种群理论上有坍缩风险,论文也没报告多样性指标。
收尾
小播:最后用一句话总结?
老播:Meta-Harness 把 harness 优化从「压缩反馈的文本优化」换成「全文件系统反馈的代码搜索」:编程 agent 提案、搜索集评估、全量归档、帕累托前沿终评。最该记住的数字是:文本分类 48.6% 对 ACE 40.9%,上下文少 4 倍;数学 harness 跨 5 个未见模型平均 +4.7 点。
小播:而最该记住的代价是:每迭代 10 MTok——它是用计算换诊断。
老播:没错。这篇的启示很直接:搜索器越强,这套「少结构」的外层循环就越值钱,因为它把复杂度交给了正在快速进步的编程 agent。