HERMES:让数学推理 agent 在每一步都过一遍「编译器」
> 量子位技术拆解 · 先给直觉再给形式。完整结构化数据见「速查」tab。
先看一个现象:LLM 做数学题,Chain-of-Thought 一长,中间某一步开始编。算错一个恒等式、漏一个条件、把符号抄反,后面全对也救不回来。奖励模型(PRM/ORM)想救这个,但它们只会给分——给 0.6 分,不告诉你哪一步错了、为什么错。另一条路是形式定理证明(Lean4),每一步都被可信内核检查,但探索起来太僵硬,解竞赛题靠它几乎走不动。
HERMES(arXiv 2511.18760,ICML 2026)把两条路的优点拼起来:非形式推理负责探索,Lean4 编译器负责抽查。关键设计是「中间验证」——推理模型把关键步骤提交给一个验证管线,管线返回三种信号:验证通过、验证失败(反证成立,步骤错了)、无法判定。信号再喂回推理模型,决定继续、换路、还是自检。这比「写完一整条再验」多了一道保险,也比「每一步都验」便宜得多。
核心机制:四模块 + 记忆块
框架由四个模块组成(Figure 1):
- 推理 LLM:正常生成解题步骤,遇到关键步骤就调用工具
verify_one_mathematical_step。
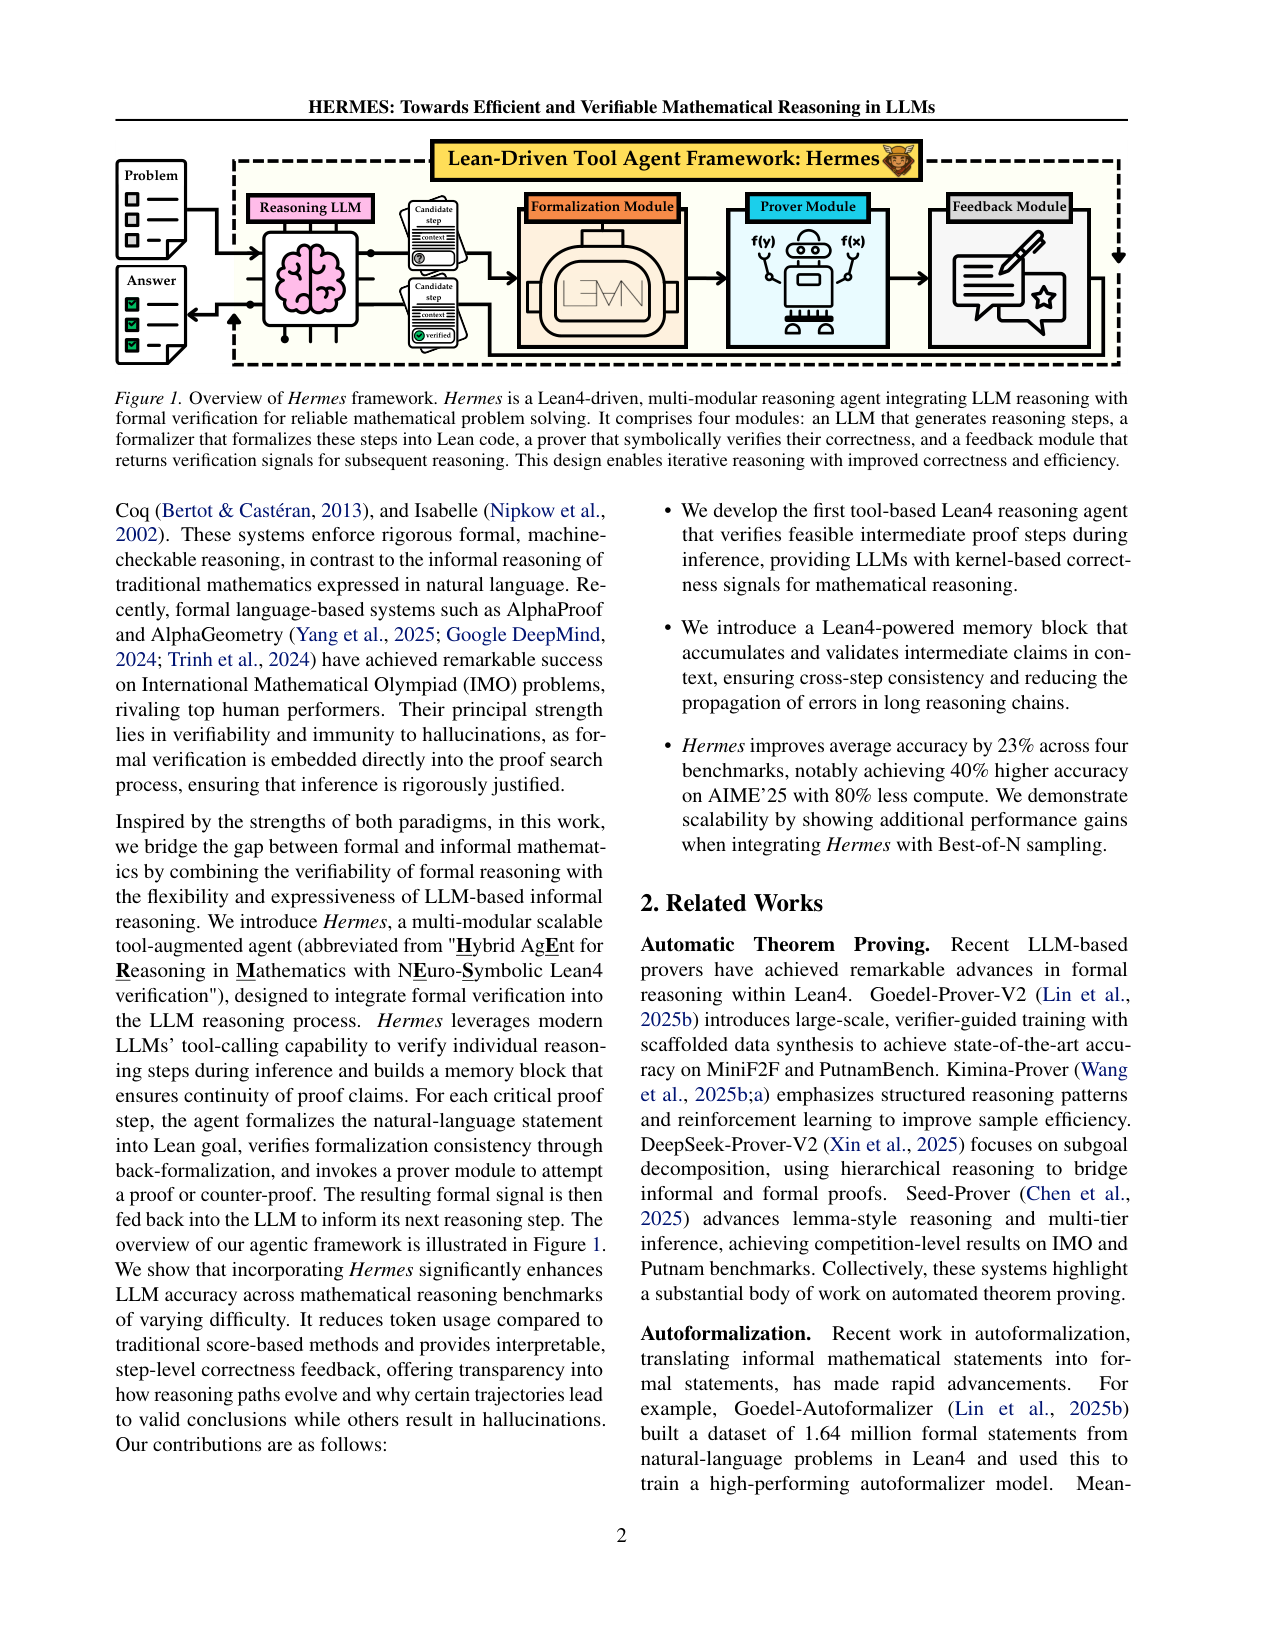
记忆块是另一个关键件:通过验证的断言会被嵌入后检索(top-3,Qwen3-Embedding-0.6B)进后续上下文。长链推理最怕前面验证过的东西后面被遗忘、重新推导出矛盾,记忆块把「已验证事实」变成可复用的上下文。
复杂度:为什么中间验证不贵
先给预期:下面的式子要回答「中间验证到底要多花多少算力」。直觉是——验证只发生在少量关键步骤上,而不是每一步,也不是 N 条完整轨迹。
设整条推理产生 $N$ 个 token,在 $T$ 个步骤上做验证,每次验证做 $K$ 次尝试。定理 4.1 给出总体 token 级复杂度:
$$O(N^2 + KTN^2)$$
逐项看:$N^2$ 是自回归生成本身的成本(第 $i$ 个 token 依赖前 $i$ 个,累积 $O(N^2)$);$KTN^2$ 是验证成本($T$ 个步骤 × 每次 $K$ 次形式化-证明尝试)。把不同方法代进去对比:
$$O_{\text{ORM}}(KN^2) \le O_{\text{Hermes}}(\tilde{T}KN^2) \le O_{\text{PRM}}(TKN^2)$$
$\tilde{T}$ 是实际验证的关键步骤数,$\tilde{T} \ll T$。ORM 要先生成 $K$ 条轨迹再选一条($O(KN^2)$);PRM 每一步都打分($O(TKN^2)$);HERMES 只验少量关键步骤,复杂度介于两者之间——理论上不会比 PRM 更贵,实测便宜得多。
关键结果:最高 +40%,省 80% FLOPs
评估横跨三个模型(Qwen3-8B、o3-mini、DeepSeek-V3.2)× 四个 benchmark(MATH500、AIME'25、CollegeMath、HARDMath2),Hermes@1 单次采样,每题 15 分钟、8192 token 预算:
- AIME'25(DeepSeek-V3.2):50.0% → 70.0%,相对 +40%,这是「最高 +40%」的来源(Table 1,p6)。
局限:库决定上限,判定有模糊地带
三件要诚实说的事:
1. 验证能力被 Mathlib 库覆盖卡住:几何约 5800 条声明、组合约 7500 条,代数 56000+ 条;几何/三角/组合的步骤验证失败率最高(Table 6)。agent 的「能验什么」受制于形式化数学库的厚度。
2. 三态反馈的「无法判定」语义模糊:形式化失败和证明失败被归成一类,模型可能把「证不出」当成「步骤错」,白白放弃正确路径。
3. 部署重、小模型会被反超:推理时要串行调 formalizer、prover、嵌入模型,延迟与复杂度被低估;在 Qwen3-8B 上,reward-based 方法用足量 token(N≥20、约 28× token)可以反超 Hermes(p7)。
一句话记住这篇
HERMES 把编译器变成推理过程中的「步骤检查员」:关键步骤形式化 → 证明/反证 → 三态反馈,已验证断言进记忆块保持长链一致。最该记住的数字是:DeepSeek-V3.2 在 AIME'25 上从 50.0% 提到 70.0%,FLOPs 省约 80%——验证密度是精度与成本的旋钮,论文证明了中间验证可以既更准又更省。
把 Lean4 形式验证接进数学推理的中间步骤:HERMES 对关键推理步骤做「自动形式化→证明/反证→反馈」并用已验证断言记忆库防漂移;AIME'25 上 DeepSeek-V3.2 从 50.0% 提到 70.0%(相对 +40%),每题总 FLOPs 比 reward-based Best-of-5 少约 80%。
问题
要解决什么:纯非形式 CoT 的长链数学推理有逻辑跳跃、幻觉和小错误累积,纯形式定理证明又缺探索自由度;如何让 LLM 数学 agent 在推理中途就拿到可验证的正确性信号,同时保持非形式推理的灵活性。
为什么 prior work 不够:PRM/ORM 是黑箱打分:给分数但不解释为什么错,训练要人工标注、用 LLM 当评判骨干还带随机噪声;Lean-based 的 Safe 等只在末端做验证或验证整条轨迹,中间步骤的错误照样传播,且靠 Best-of-N 重采样导致 token 与算力开销大。
进化循环(搜索空间 → 算子 → 评估 → 选择)
搜索空间(什么被进化):推理轨迹中的关键证明步骤(LLM 判定需要验证的步骤子集 S̃⊆S)+ 已通过验证的断言记忆库;可编辑表面是推理文本本身,Lean 编译器与 formalizer/prover 模型只读。HERMES 属于推理时验证循环:候选步骤被 propose-verify-revise 修正,无跨代种群。
变异/提案算子:
- LLM 用工具调用触发 verify_one_mathematical_step,把单个关键步骤提交验证
- autoformalizer 把自然语言步骤形式化为 Lean goal(back-formalization 校验语义等价)
- prover 并行尝试证明 goal 与 ¬goal(反证),反馈模块返回 CORRECT / INCORRECT / VERIFICATION FAILURE 三态
评估方式:Lean4 编译器 + Goedel-Prover-V2-8B(Kp=4、60 秒超时、Lean v4.9.0);评测含 MATH500、AIME'25、CollegeMath、HARDMath2(每题 15 分钟、8192 token 预算,Hermes@1 单次采样);记忆块按嵌入相似度 top-3 检索(Qwen3-Embedding-0.6B)。
选择与归档:通过编译验证的步骤写入记忆块供后续步骤检索复用;INCORRECT 触发修订、VERIFICATION FAILURE 让 LLM 继续或换路;Kf/Kp 预算耗尽仍未验证的步骤降级为纯推理继续。无跨任务的保留/淘汰规则(论文没有定义种群)。
自我改进程度:L0:推理 LLM、formalizer、prover 全部固定,harness(验证调度与记忆检索)固定不进化;自我改进发生在单次推理内——模型借助验证信号实时纠正自己,不改权重、不改代码。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|
输出
| 名称 | 类型 | 说明 |
|---|
数据集
| 数据 | 规模 | 备注 |
|---|
架构(摘要)
主干与结构
backbone:
参数:
类型:
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| AIME'25 准确率(Hermes@1,单次采样) | 70.0%(相对零样本 CoT +40%) | zero-shot CoT 50.0%;reward-based Best-of-5(Skywork)53.3% | DeepSeek-V3.2 作推理模型,8192 token 预算、15 分钟/题,Table 1(论文 p6) |
| HARDMath2 准确率 | 33.6%(相对 CoT +31.5%) | zero-shot CoT 25.6%;CoT@5+Safe* 30.3% | DeepSeek-V3.2,Table 1(p6);对比 MATH 仅 +2.7%——难题集增益更大 |
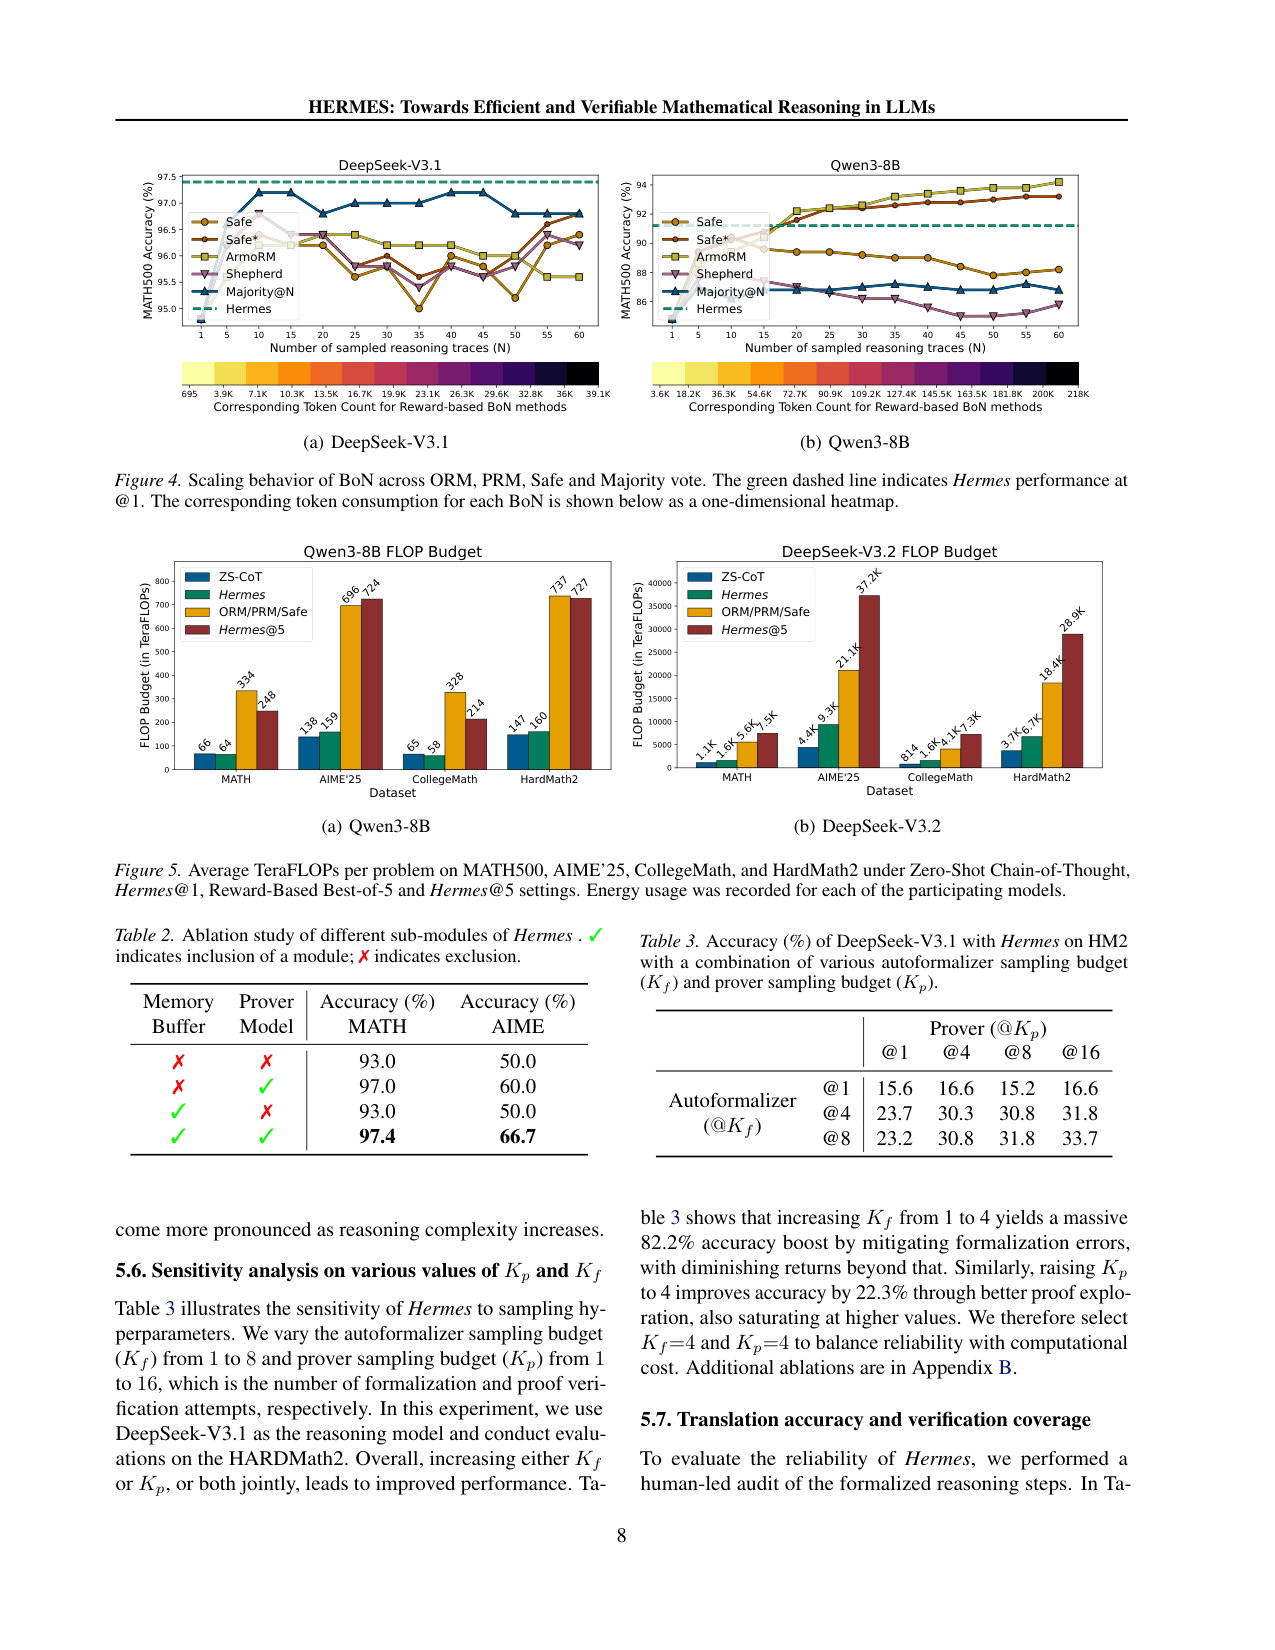
| 每问题总推理 FLOPs | 约 4.1K TFLOPs(约省 80%) | reward-based Best-of-5 约 21.1K TFLOPs | AIME'25,DeepSeek-V3.2,含 formalizer/prover 全部开销,Fig.5b(p8) |
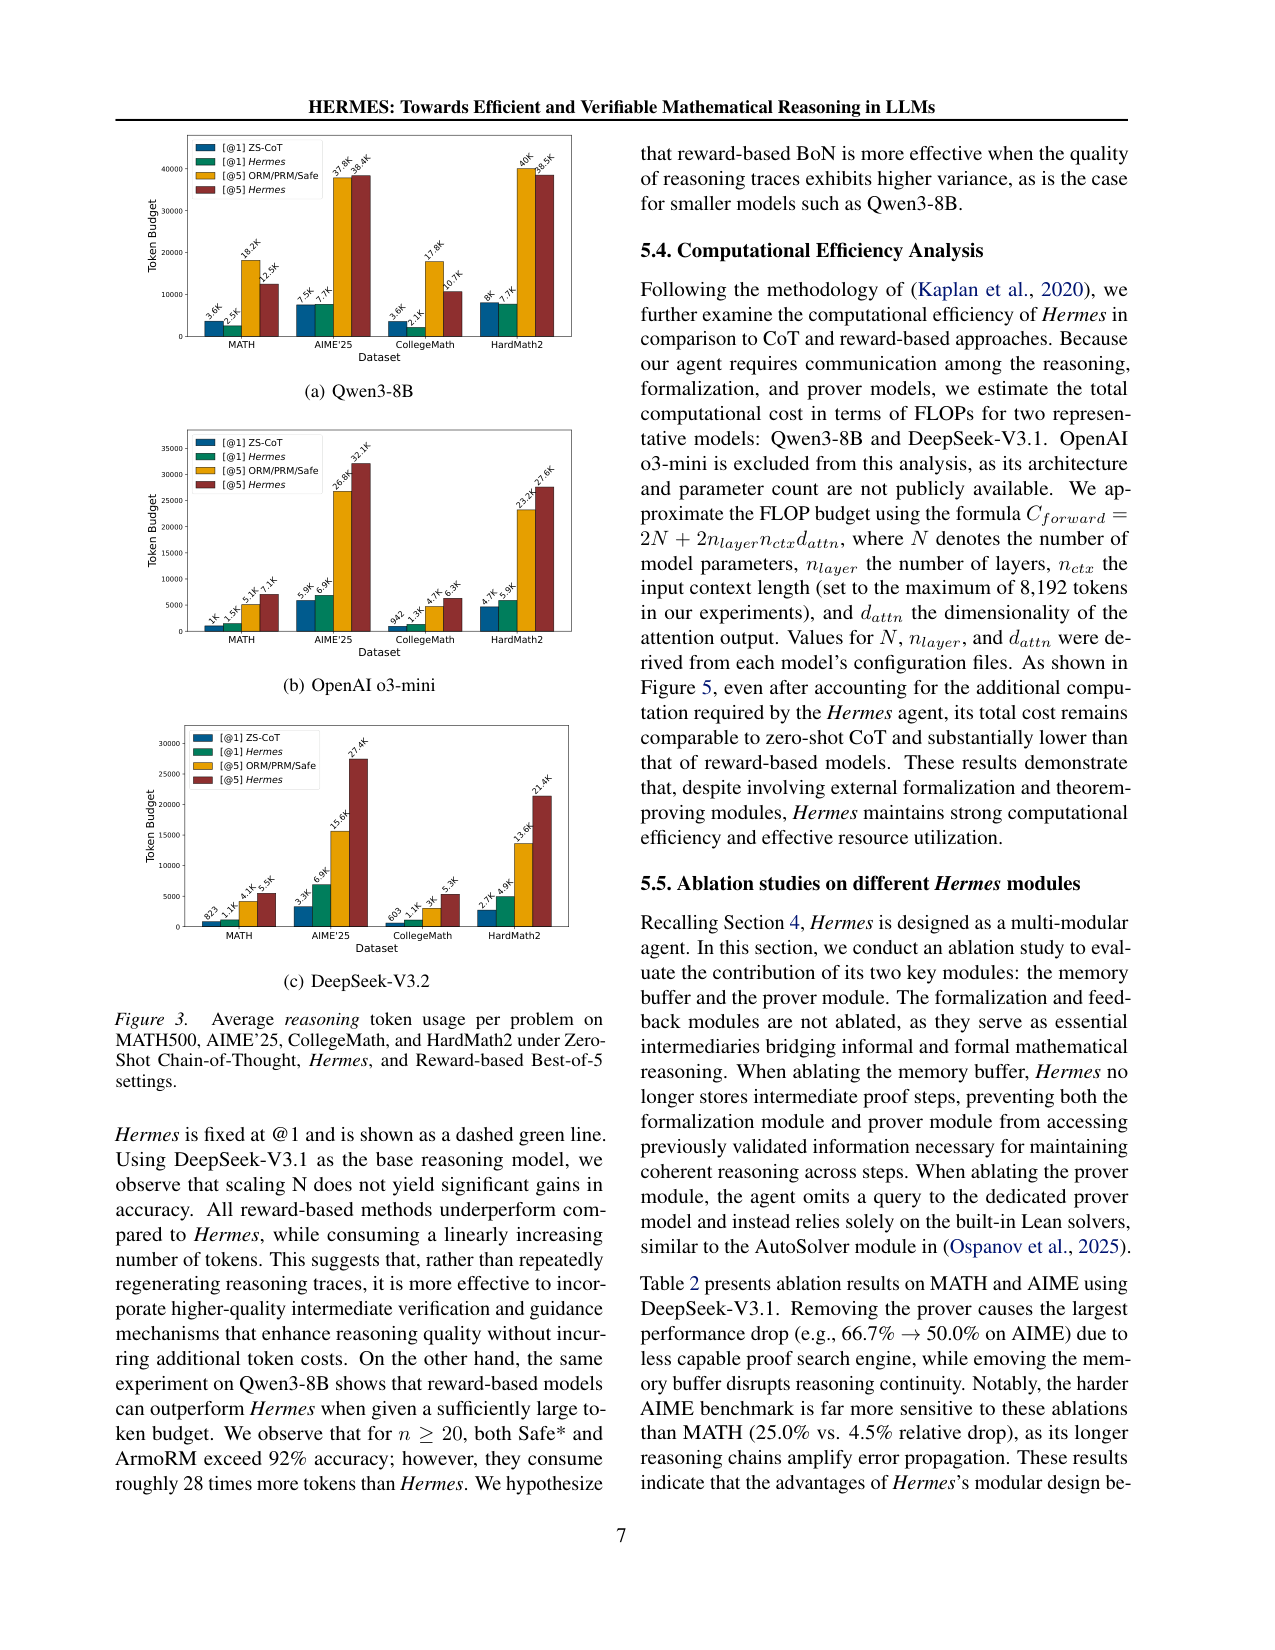
| 每问题推理 token 数 | 3.3K(reward-based 的约 1/4.7) | ORM/PRM/Safe Best-of-5 15.6K;零样本 CoT 1.1K | DeepSeek-V3.2 on AIME'25,Fig.3c(p7);四个 benchmark 平均低 4–6× |
| 跨模型平均增益(三个模型 × 四个 benchmark) | 比零样本 CoT 高 23.4%,比 Safe/Safe* 高 10.3%/8.5% | Safe(前 SOTA Lean 方法)与其增强版 Safe* | Qwen3-8B / o3-mini / DeepSeek-V3.2 平均(p6) |
| 缩放性:Hermes@5 + Skywork 选择 | AIME'25 80.0% | Hermes@1 的 70.0% | DeepSeek-V3.2,5 条 Hermes 轨迹 + reward 模型选优,Table 1 末行(p6) |
| 模块消融(DeepSeek-V3.1) | 去掉 prover:AIME 66.7→50.0;去掉记忆块:66.7→50.0 | 完整版 AIME 66.7%、MATH 97.4% | Table 2(p8);AIME 相对降幅 25.0% vs MATH 4.5%——长推理链放大错误传播 |
Insights
- 验证只在「关键步骤」子集做(T̃≪T),复杂度 O(T̃KN²) 夹在 ORM 与 PRM 之间——验证密度是精度与成本的旋钮(定理 4.1,p5)。
- 并行证明 goal 与 ¬goal:能主动抓住「步骤本身错了」,比只报告「证不出来」的信息量大得多,这是与 Safe 末端验证的本质区别(p4)。
- 增益随难度上升而变大:HM2 相对 +31.5%、MATH 仅 +2.7%;越长的推理链越需要中间验证来切断错误累积(p6)。
- 失败模式与 Mathlib 库覆盖强绑定:几何约 5800 条声明、组合约 7500 条,而代数 56000+ 条;验证失败集中在库薄的领域(Table 5/6,p9)。
vs 同类工作
- vs Safe(Lean 末端验证):Safe 在 CoT@5 轨迹上做末端检查+选优;HERMES 改为单条轨迹内逐步验证,平均准确率高 10.3% 且 token 少 4–6×。
- vs PRM/ORM:正确性信号来自编译器而非学习到的分数,可解释、无 reward 噪声;代价是需要维护 autoformalizer + prover 两个 8B 专用模型。
- vs AlphaProof 式全形式化:保留非形式探索自由度,只在关键步骤切到 Lean 验证,工程部署更轻、可插拔(可换任何 autoformalizer-prover 组合)。
局限
- 依赖数学库覆盖:几何/三角/组合声明少,验证失败率最高;agent 表现与 Mathlib 状态强绑定(Table 6,p9,论文自承)。
- 评估样本小:CoT Coverage / Translation Accuracy 基于 100 步人工标注(50 成功 + 50 失败),对失败步骤只统计比例、没有机制层面的归因分析(p9)。
- 三态反馈的第三态语义模糊:形式化失败与证明失败被归为一类 VERIFICATION FAILURE,LLM 可能把「证不出」误读成「步骤错」而白白换路。
- 推理时多模型串行(reasoning + formalizer + prover + embedding),墙钟延迟与部署复杂度被低估;o3-mini 因架构不公开被排除在 FLOP 分析外(p7)。
- 小模型场景 reward-based BoN 用足量 token(N≥20)可反超 Hermes(Qwen3-8B 上约 28× token),说明验证收益对基座模型方差敏感(p7)。
可复现性
- code:https://github.com/aziksh-ospanov/HERMES
- notes:组件全部开源模型(Goedel-Prover-V2-8B、Goedel-Autoformalizer-8B、Qwen3-Embedding-0.6B),Lean v4.9.0 与训练数据对齐;Kf=Kp=4、60 秒 Lean 超时等超参在 §5.1 给出。
HERMES 架构:验证闭环 + 记忆块数据流
Mermaid 数据流
flowchart TD
    P["Problem p"] --> LLM["Reasoning LLM\n(CoT 生成解题步骤)"]
    LLM -- "关键步骤 + 上下文" --> F["Formalization Module\nautoformalizer 8B\n自然语言 → Lean goal\n(back-formalization 校验)"]
    F -- "合法 Lean goal" --> PR["Prover Module\nGoedel-Prover-V2-8B\n并行证 goal 与 ¬goal"]
    PR --> LEAN["Lean4 编译器\n(v4.9.0, 60s 超时)"]
    LEAN -- "CORRECT" --> FB["Feedback Module\n三态信号"]
    LEAN -- "INCORRECT(反证成立)" --> FB
    LEAN -- "VERIFICATION FAILURE" --> FB
    FB -- "继续推理 / 修订 / 换路" --> LLM
    FB -- "已验证断言" --> MEM["Memory Block\n嵌入 top-3 检索\n(Qwen3-Embedding-0.6B)"]
    MEM -- "历史断言上下文" --> LLM
    LLM -- "最终答案" --> ANS["Answer"]
    LLM -- "Kf 次形式化尝试 / Kp 次证明尝试" --> F
    LLM -- "Kp 次证明尝试" --> PR
组件详解
- 推理 LLM(生成器):任何支持 tool-calling 的模型,负责把问题分解成步骤,并在关键步骤调用
verify_one_mathematical_step。DeepSeek-V3.2 在 MATH 上平均调用 5.5 次、AIME'25 上 10.4 次——难题会自动拆更多验证点(§5.5,p9)。
sorry 占位的 Lean statement。两道校验:先编译通过(保证语法与 goal 良定义),再 back-formalization 翻回自然语言由 LLM 判语义等价。形式化预算 $K_f=4$。HERMES 框架总览:验证信号闭环进推理循环
原文 caption:Overview of Hermes framework: four modules — an LLM that generates reasoning steps, a formalizer, a prover, and a feedback module. This design enables iterative reasoning with improved correctness and efficiency.
证明核心论断「形式验证被接进推理中间而非末端」:候选步骤经 Formalization 转成 Lean goal,Prover 验证后由 Feedback Module 把 CORRECT/INCORRECT/FAILURE 信号送回 LLM 决定继续、换路或自检。读法:看反馈是闭环回路;这正是与 Safe(末端验证)和 PRM(黑箱打分)的差别所在,也是全篇机制的心脏。
每问题平均推理 token:Hermes 与零样本 CoT 同量级
原文 caption:Average reasoning token usage per problem on MATH500, AIME'25, CollegeMath, and HardMath2 under Zero-Shot CoT, Hermes, and Reward-based Best-of-5 settings.
支撑「效率」论断:Hermes@1 的 token 用量贴近零样本 CoT,而 reward-based Best-of-5 普遍高 4–6 倍(如 DeepSeek-V3.2 在 AIME'25 上 Hermes 3.3K vs reward 15.6K,Fig.3c)。读法:验证步骤没有靠堆 token 换精度,反而用单条轨迹内的中间校验替代了 N 条轨迹重采样。
每问题总 FLOPs:计入 formalizer/prover 后仍省约 80%
原文 caption:Average TeraFLOPs per problem on MATH500, AIME'25, CollegeMath, and HardMath2 under Zero-Shot CoT, Hermes@1, Reward-Based Best-of-5 and Hermes@5 settings.
支撑「80% 省算力」:即使把外部形式化与定理证明模型的全部计算算进去,Hermes@1 每问题 FLOP 仍与零样本 CoT 同量级,约为 reward-based 方法的 1/5(AIME'25/DeepSeek-V3.2:约 4.1K vs 21.1K TFLOPs)。读法:中间验证的算力被「少采样 N 条轨迹」的收益覆盖,这是与 BoN 路线的关键经济性对比。
数学推理 agent 的每一步,都让编译器把关(对话版)
小播:今天聊一篇数学推理的新论文,主题一句话:LLM 做数学题的时候,能不能让每一步都被编译器检查过?
老播:这篇叫 HERMES,ICML 2026。先说结论:他们把 Lean4 形式验证接进了推理的中间步骤,不是写完全部再验,是边走边验。在 AIME'25 上,DeepSeek-V3.2 从 50.0% 提到 70.0%,相对涨了 40%,而且总算力还省了大约 80%。
小播:等等,验证不是要花更多算力吗,怎么还省了?
老播:问得好,这就是它最反直觉的地方。我们从头拆——先看它解决的是什么问题。
问题:长链推理的「中间出错」
小播:LLM 做数学题的老毛病是什么?
老播:题一难,CoT 一长,中间某一步就开始编了。算错个恒等式、漏个条件、符号抄反,后面全对也救不回来。奖励模型想救,但它只会打分:给个 0.6 分,不告诉你哪一步错、为什么错。
小播:那形式化证明呢?Lean 不是能验每一步吗?
老播:能,但全形式化太僵硬,探索不动。HERMES 的做法是:非形式推理负责探索,Lean 编译器负责抽查关键步骤。推理模型遇到重要步骤,就调用一个工具,把这个步骤翻译成 Lean 代码,交给证明器验证。
小播:翻译错了怎么办?
老播:所以它有双重保险。第一步,形式化结果先过编译;第二步,back-formalization——把 Lean 代码翻回自然语言,让模型自己确认语义没被偷换。这关过了,证明器才上场,而且它并行做两件事:证这个命题,同时证它的否定。
小播:证否定?这是为什么?
老播:这是它和以前方法最大的区别。以前的方法只能告诉你「没验证通过」;HERMES 能告诉你「这一步确实错了」——因为反证成立了。三种信号:正确、错误、无法判定。错误就直接让模型改,无法判定就让它自检或者换路。
小播:那每步都验,不是要慢死?
老播:记住这个记忆锚点:它只验「关键步骤」,不是每一步,也不是 N 条完整轨迹。论文给了一个复杂度公式:总体成本是 N 平方加 K 乘 T 乘 N 平方,其中 T 是验证步骤数。ORM 要生成 K 条轨迹再选,PRM 每一步都打分,HERMES 只验少量关键点,复杂度正好夹在两者中间。
结果:越难的题,验证越值钱
小播:数字呢?
老播:三个模型,四个 benchmark。最亮眼的两个:AIME'25 上 DeepSeek-V3.2 从 50.0 提到 70.0,相对 +40%;HARDMath2 从 25.6 提到 33.6,相对 +31.5%。而简单的 MATH 只从 95.8 提到 98.4。
小播:所以难的题增益大,简单的题增益小?
老播:对,这就是它的规律:越长的推理链,中间越需要把关。再看效率——单次采样、不重采样,token 用量和零样本 CoT 一个量级。DeepSeek-V3.2 在 AIME 上每题 3.3K token,reward-based 的 Best-of-5 要 15.6K。把形式化模型和证明模型的算力全算进去,每题总 FLOP 约 4.1K 对 21.1K TFLOPs,省了约 80%。
小播:那 80% 就是这么来的?
老播:对,再记住一个记忆锚点:验证密度是精度和成本的旋钮——验得越密越准也越贵,HERMES 的功夫全在选对「哪些步骤值得验」。
老播:对。省掉的是「采样 N 条轨迹」的钱。中间验证听着贵,但验证模型的算力被省下的重采样开销盖过了。
两个模块缺一不可
小播:记忆块是干什么的?
老播:通过验证的断言会被存下来,后面按相似度取回 top-3 塞回上下文。长链推理最怕前面验证过的东西后面忘了、又推出矛盾。消融实验很干脆:把证明器拿掉,AIME 从 66.7 掉到 50.0;把记忆块拿掉,同样掉到 50.0。完整的系统才是 66.7。
小播:两个都这么重要?
老播:对,一个负责「这步对不对」,一个负责「前面验证过什么别推翻」。
泼冷水:库决定上限
小播:那它有什么短板?
老播:三个。第一,验证能力被数学库卡住。Lean 的 Mathlib 里,代数有 56000 多条声明,几何只有约 5800 条。几何、三角、组合的步骤,验证失败率最高——「能验什么」取决于形式化数学库有多厚。
小播:这是外部条件,它自己呢?
老播:第二,三态信号里那个「无法判定」太模糊:翻译失败和证明失败被归成一类,模型可能把「证不出」当成「步骤错」,白白放弃正确路径。第三,部署不轻:推理时要串行调形式化模型、证明模型、嵌入模型,墙钟延迟被低估;在小模型 Qwen3-8B 上,奖励模型方法用足量 token 反而能反超它。
小播:所以它适合什么场景?
老播:适合难题、长链、算力敏感的数学推理场景。它证明了中间验证可以既更准又更省——这条路的性价比,比堆采样轨迹高。
收尾
小播:最后用一句话总结?
老播:HERMES 把编译器变成推理过程的步骤检查员:关键步骤形式化、证明、反证,三态反馈回模型,验证过的断言进记忆库保持长链一致。最该记住的数字是:DeepSeek-V3.2 在 AIME'25 上从 50.0% 提到 70.0%,FLOPs 省约 80%。
小播:而最该记住的保留态度是:验证能力的天花板在 Mathlib 的覆盖度,库薄的地方它也会哑火。
老播:没错。这篇值得读,读的时候带着「验证密度是个旋钮」这个判断去读。