AHE:用可观测性把 harness 进化变成工程
> 量子位技术拆解 · 每次编辑都是一条 file-level 可证伪声明。完整结构化数据见「速查」tab。
先看一个现象:coding agent 的表现不只由基座模型决定,还由它周围的 harness 决定——system prompt、工具、middleware、技能、子 agent、长期记忆。人类手工适配 harness 的速度赶不上基座模型的迭代速度,于是复旦、北大与上海期智团队的论文(arXiv 2604.25850)想自动进化 harness。他们的核心论断很直接:这个问题的瓶颈是可观测性,不是演化 agent 的能力。
核心思想:三大可观测性支柱
AHE 把 harness 进化拆成三个「看得见」的环节。组件可观测性:harness 挂在 NexAU 框架上,暴露 7 类组件文件——system prompt、tool description、tool implementation、middleware、skill、sub-agent config、long-term memory——每个失败模式都能映射到单个组件类,每次编辑是一个 git commit,天然有文件级 diff 与回滚粒度。经验可观测性:每轮 rollout 产生约千万级 token 的原始轨迹,Agent Debugger 把轨迹当成可导航的文件环境逐任务分析根因,产出逐任务报告 + 一份约 10K token 的 benchmark 级 overview,演化 agent 读的是结构化证据而不是原始日志。决策可观测性:每个编辑都带 manifest——目标失败证据、推断根因、预期修复集、预期回归集——下一轮用任务级 delta 与预测集合求交生成 verdict,命中保留、不中回滚。
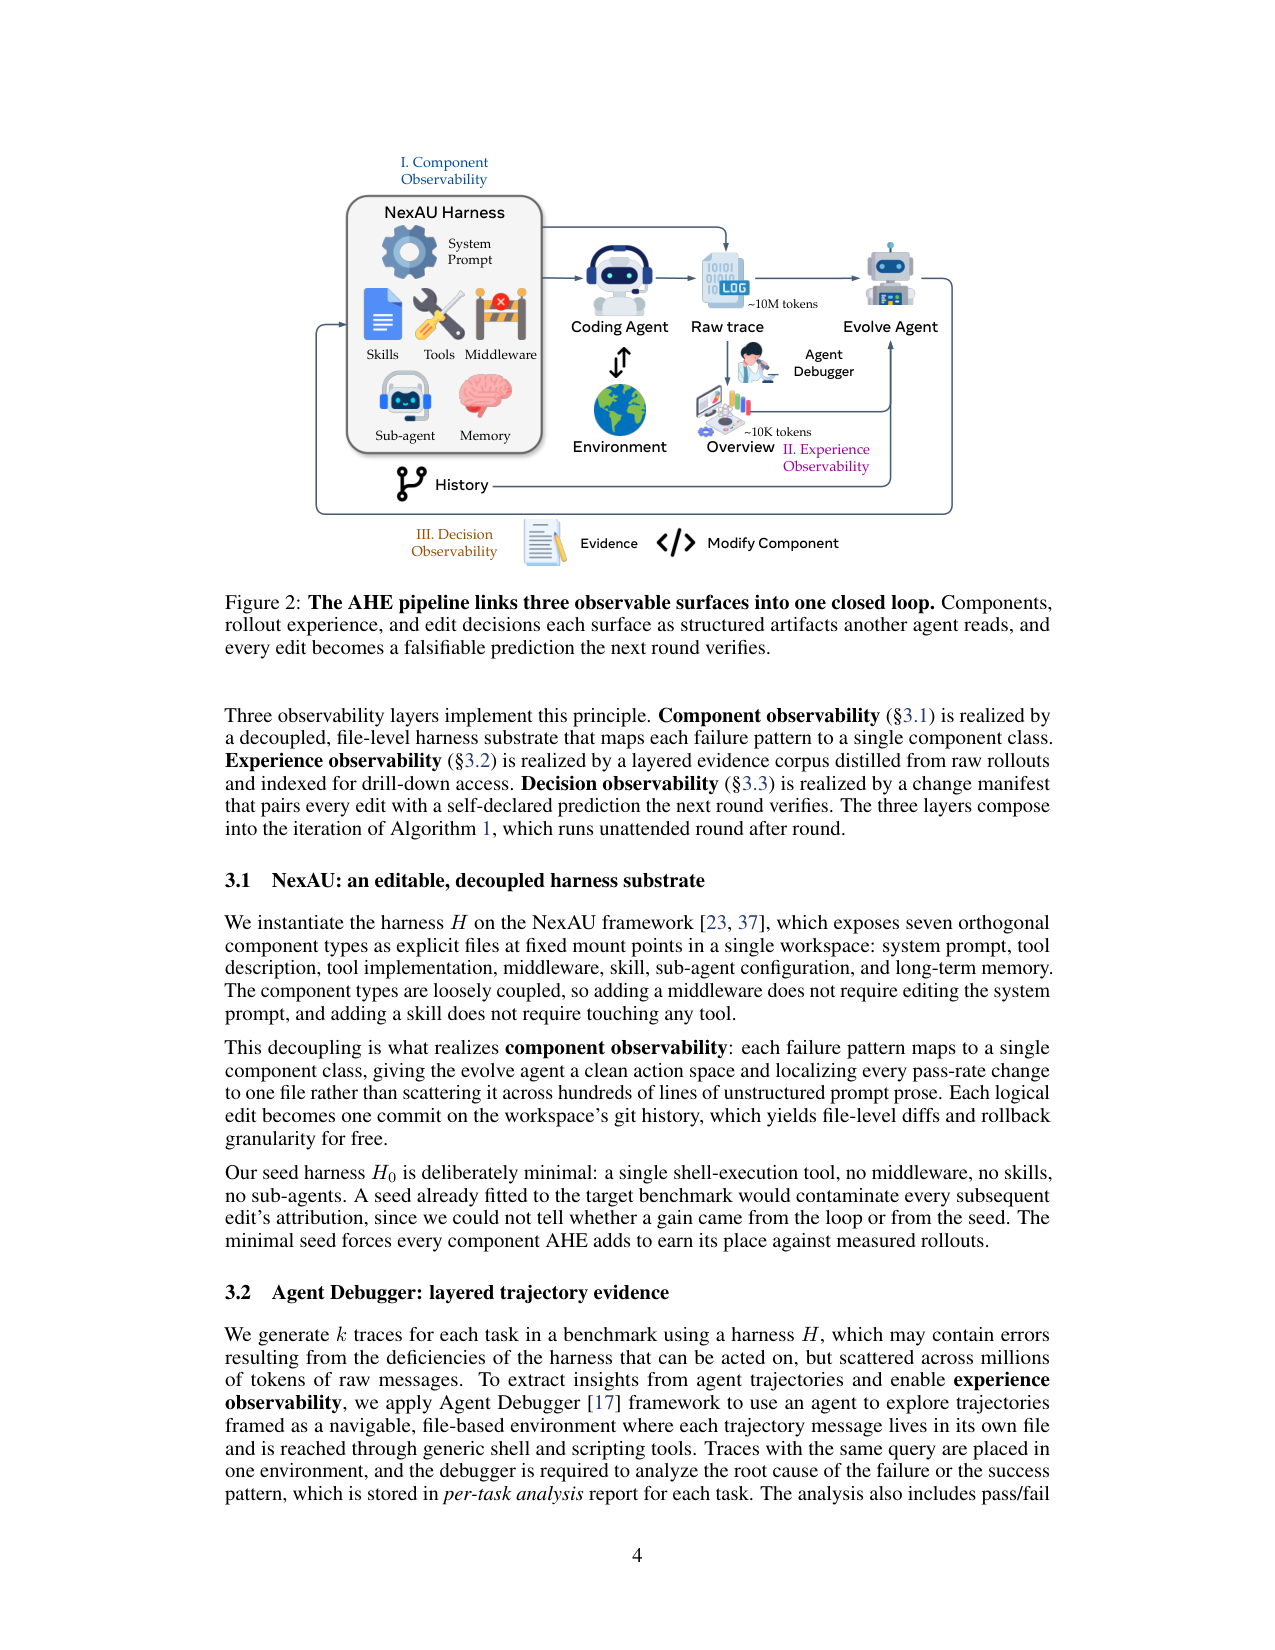
这三根支柱把「编辑」变成了一条可证伪契约,从而避免自动化退化成无结构试错。种子 harness 被刻意压到最小——只有一个 shell 执行工具、无 middleware、无技能、无子 agent——让每个新增组件都必须靠实测 rollout 挣得位置。
机制:外循环六阶段
每轮迭代是固定六阶段:rollout(每任务 $k \ge 2$ 次)→ 归一化轨迹 → 归因上一轮 manifest 并回滚被否编辑 → Agent Debugger 蒸馏 → Evolve Agent 写组件编辑与 manifest → git commit。约束是硬的:演化 agent 只能写 harness workspace,runs/tracer/verifier/LLM 配置只读,种子 system prompt 不可删除——这挡住了无约束自修改者最想走的三条捷径:关 verifier、换模型、抬推理预算。所有编辑在同一基座 GPT-5.4 high 下完成,Code/Debugger/Evolve 三个角色共用它,隔离掉「换更强模型」的混淆变量。
关键结果:越过人类设计,还能迁移
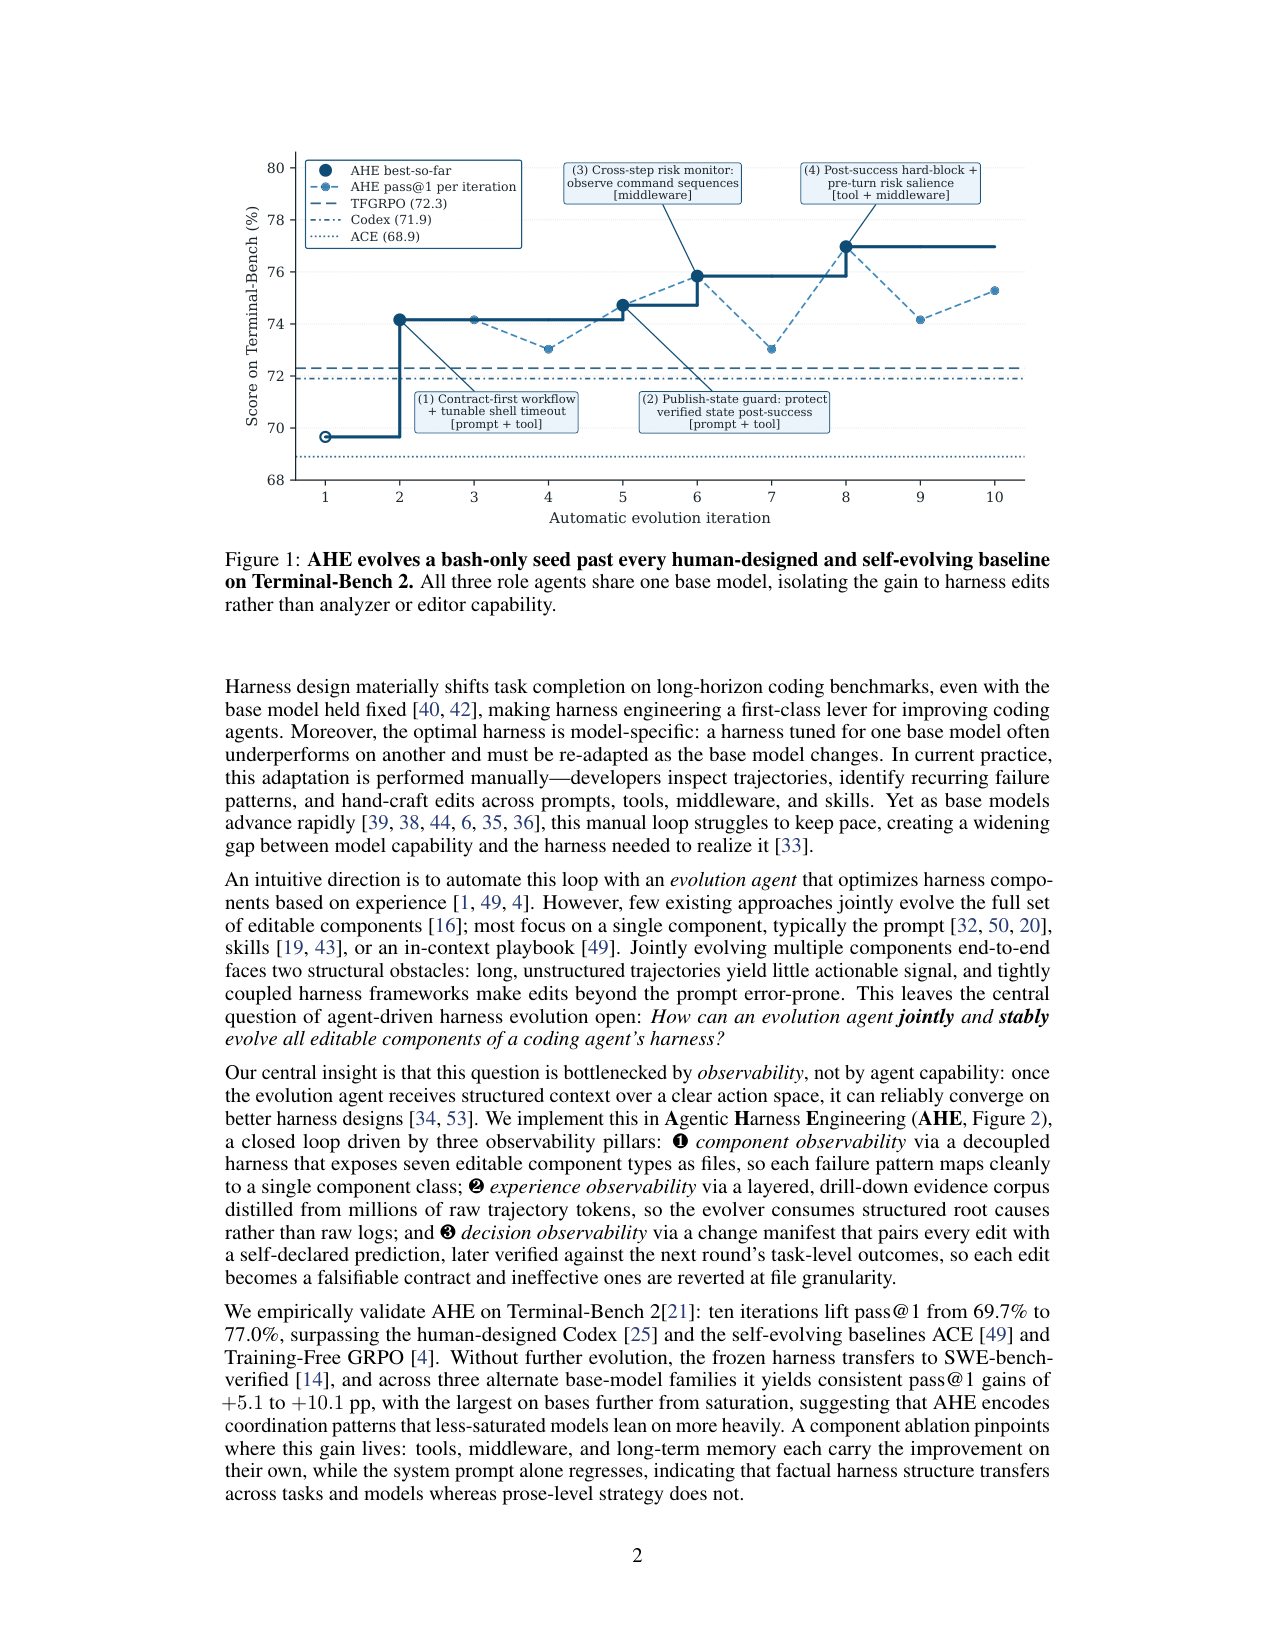
主结果在 Terminal-Bench 2 的 89 个任务上(4 easy / 55 medium / 30 hard,每任务 1 小时超时):10 轮进化把 pass@1 从种子 69.7% 推到 77.0%,超过人类设计的 Codex(71.9%)、Terminus-2(62.9%)、OpenCode(47.2%),也超过自进化基线 ACE(68.9%)与 Training-Free GRPO(72.3%)。
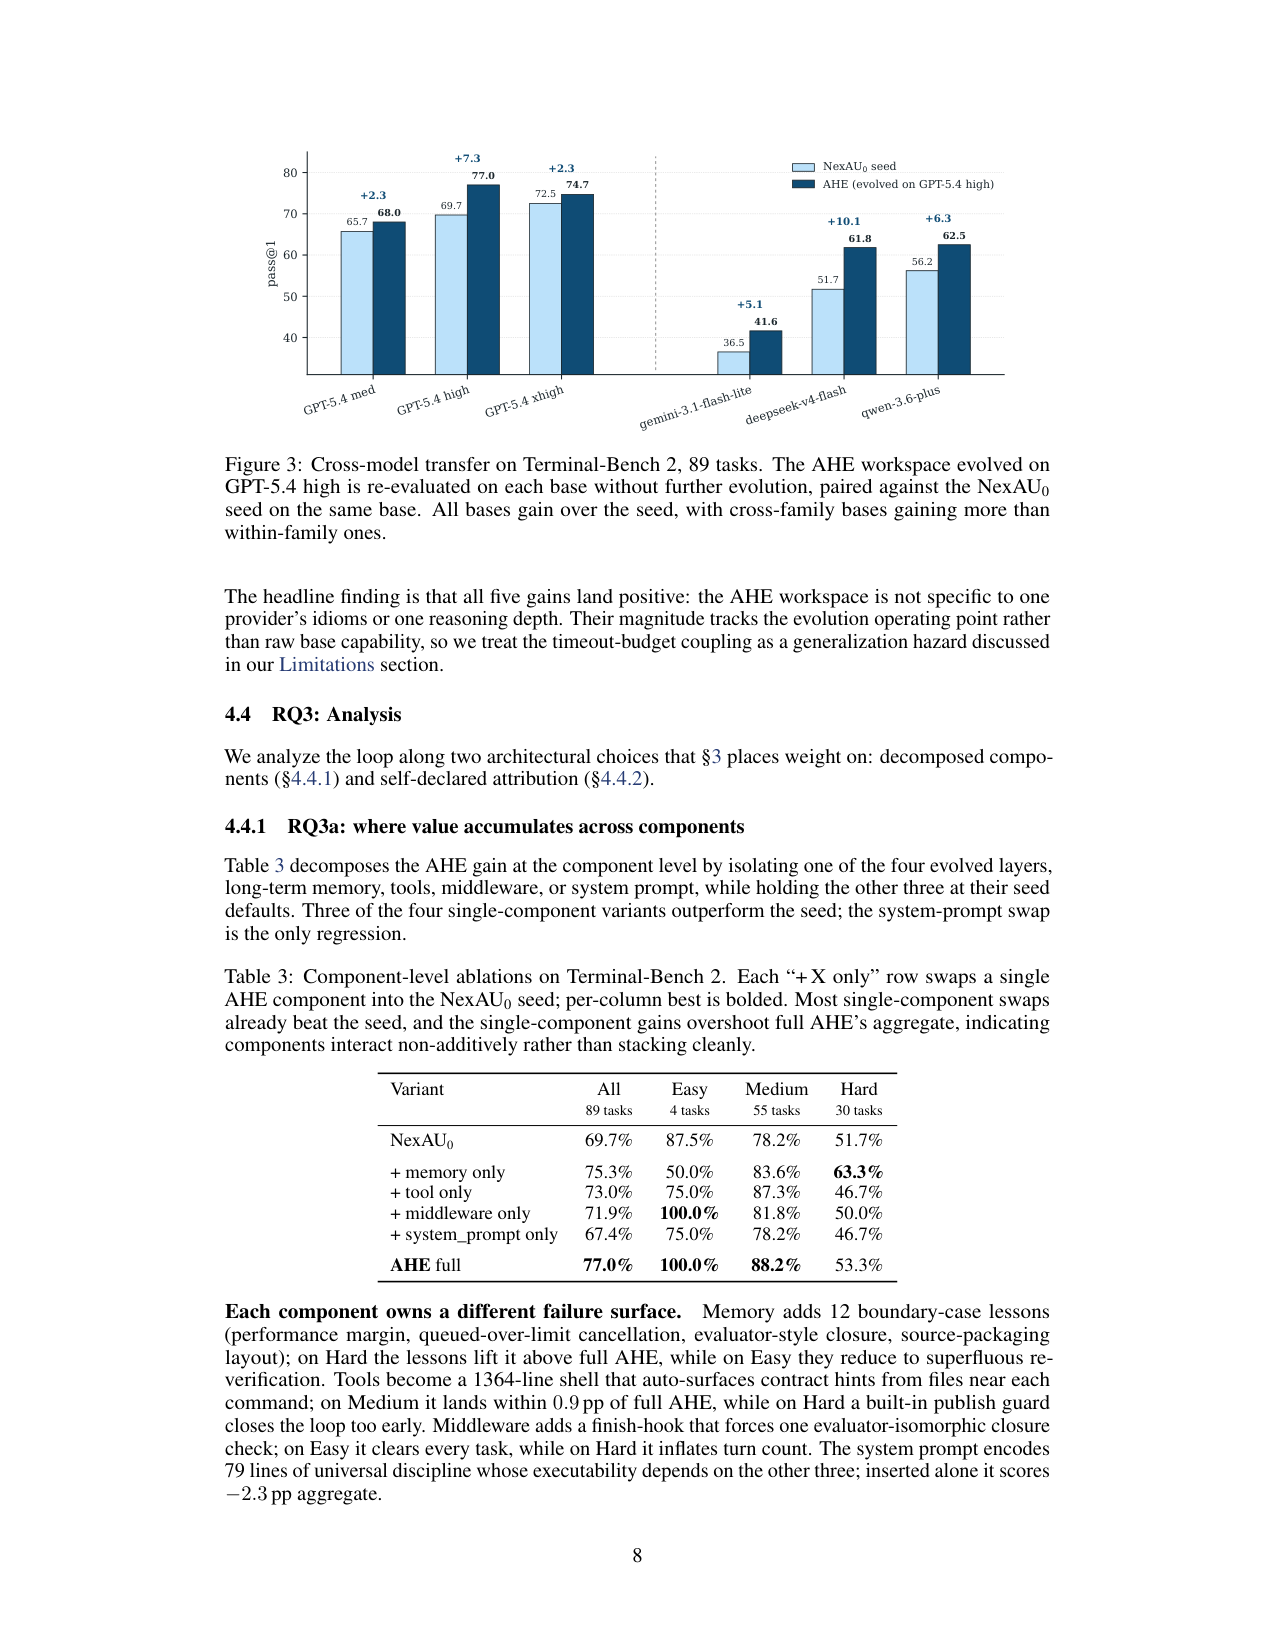
更关键的证据是迁移。冻结的 harness 不改一行,直接换场景:SWE-bench-verified(500 任务、7 个仓库)上成功率 75.6%,高于共享种子 75.2% 与 ACE 74.6%、TF-GRPO 74.2%,且每 trial 只花 461K token,比种子省 12%、比 ACE 省 32%。换基座同样有效:deepseek-v4-flash 51.7%→61.8%(+10.1pp)、qwen-3.6-plus 56.2%→62.5%(+6.3pp)、gemini-3.1-flash-lite 36.5%→41.6%(+5.1pp),而 GPT-5.4 族内 medium/xhigh 只有 +2.3pp——离饱和越远的基座越依赖 harness 固化下来的协调模式。
消融把增益定位得很清楚:单独换入长期记忆 75.3%、工具 73.0%、middleware 71.9%,而单独换 system prompt 反而跌到 67.4%(种子 69.7%)——三个正组件的收益和 +11.1pp 高于全 AHE 的 +7.3pp,说明组件非加性交互、叠加有效编辑会封顶总增益。论文自己对机制的解释是:记忆、middleware、prompt 都在往同一个「closure 式验证」方向推,叠在一起互相冗余、浪费 turn。
局限与边界
组件消融还揭示了每个组件的失败面:长期记忆带来 12 条边界案例经验(性能余量、排队超限取消、评估器式闭合、打包布局),在 Hard 档单独使用甚至超过完整 AHE(63.3% vs 53.3%);工具进化成一份 1364 行的 shell,能自动从命令附近的文件浮现契约提示;middleware 加了一个强制闭合检查的 finish-hook,在 Easy 档全过但在 Hard 档抬高回合数。这些细节解释了为什么「组件非加性」——它们都在推同一个方向的验证行为,叠起来在长时程预算内互相冗余。
局限与边界
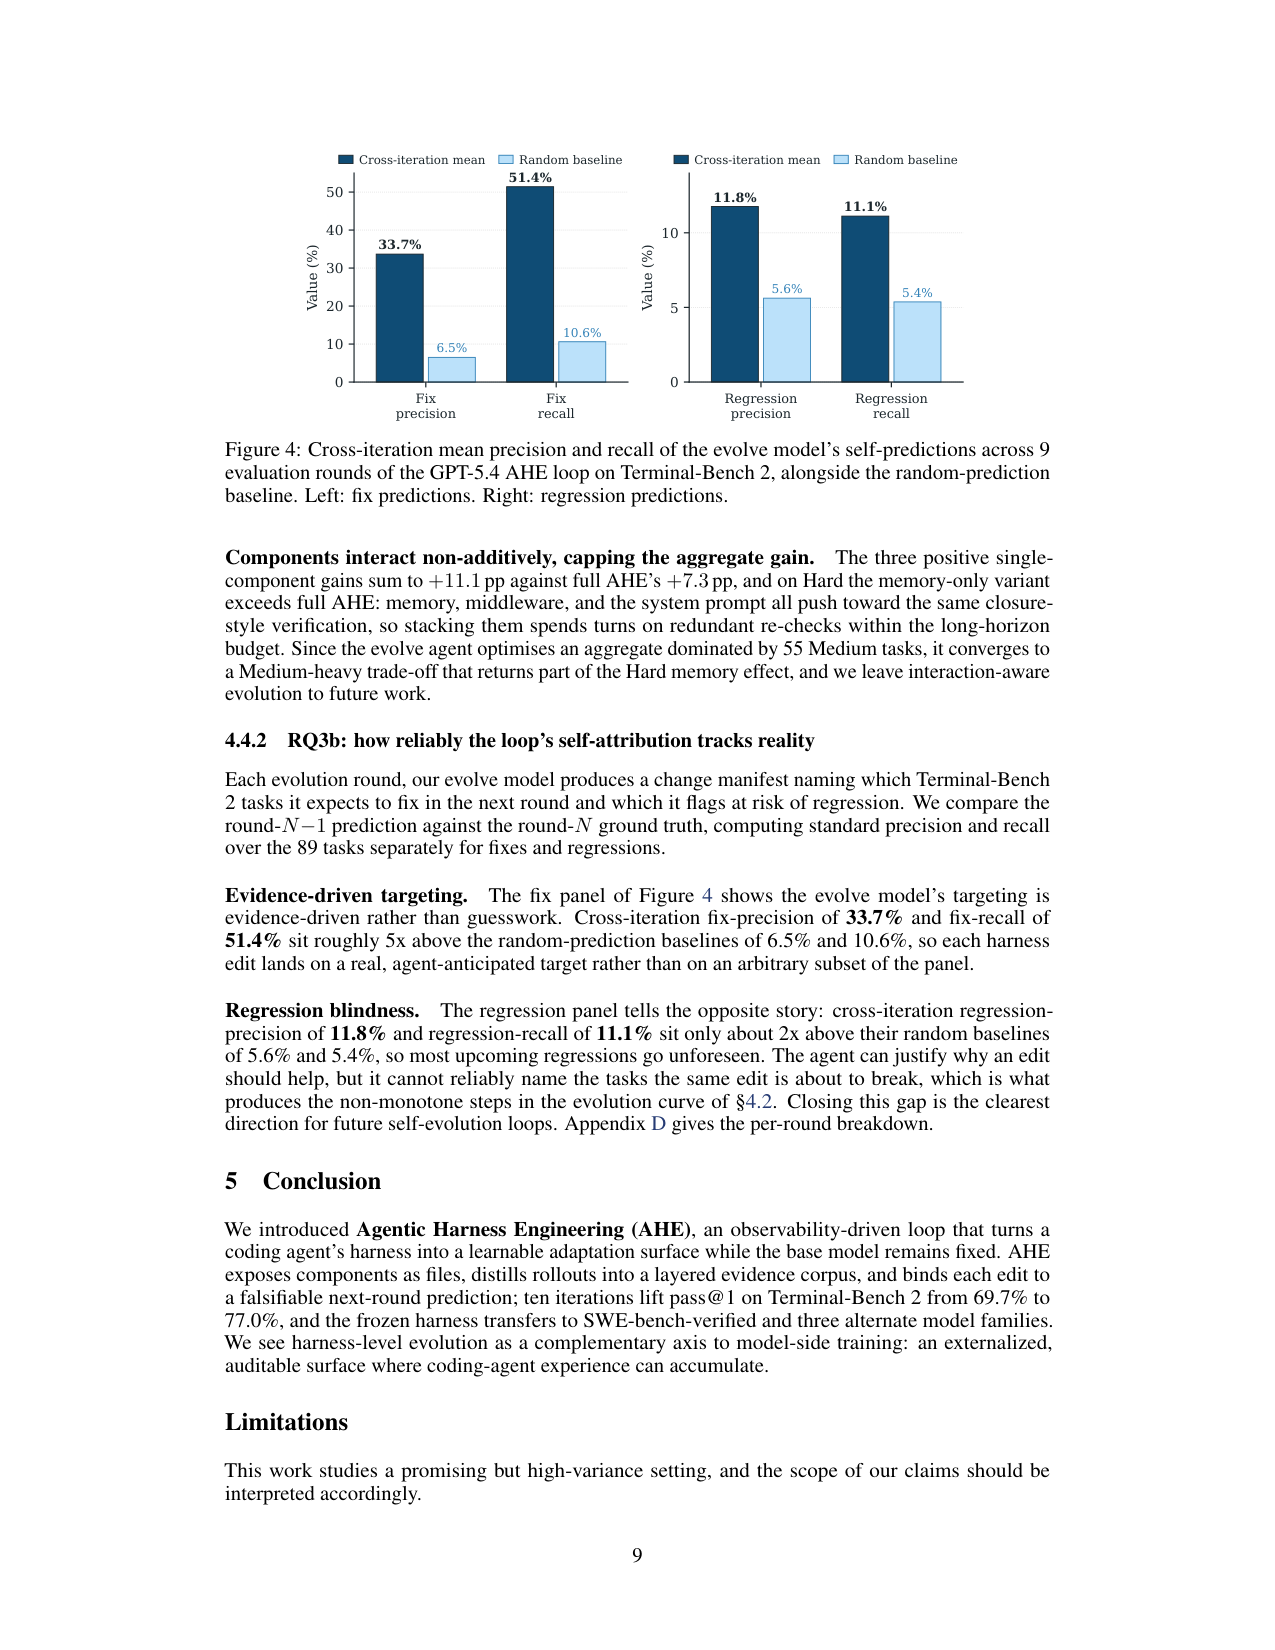
论文自承四条限制:benchmark 范围窄(只在 Terminal-Bench 2 驱动进化、SWE-bench-verified 探测迁移);操作点耦合(step budget 与超时是在 GPT-5.4 high 上拟合的,跨模型数字混淆了可移植性与操作点);自改进治理不完整(有 workspace 边界与回滚,但没有完整护栏栈);以及自我归因对回归几乎失明——Figure 4 里 fix precision 33.7%(随机基线 6.5%),但 regression recall 只有 11.1%(随机 5.4%)。我们补两条读出:主结果来自单次 10 轮 campaign,没有多随机种子统计;Hard 档(30 任务)AHE 53.3% 落后 Codex 的 56.7%,进化对最难的子集反而贡献有限。
一句话记住这篇
AHE 把 harness 进化做成「组件文件化 + 轨迹蒸馏 + manifest 契约」的闭环,Terminal-Bench 2 上 pass@1 69.7%→77.0%,冻结 harness 迁移到 SWE-bench-verified 与三个跨族基座仍正收益。最该记住的数字是 regression recall 11.1% 对随机 5.4%——它能修什么说得很准,会弄坏什么一无所知,这正是下一代自进化闭环要补的洞。
AHE 把 harness 进化拆成三大可观测性支柱——组件(7 类组件文件化)、经验(约 10M token 轨迹蒸馏成可下钻证据语料)、决策(每个编辑配自我声明的可证伪预测、下一轮验证后文件级回滚)——10 轮迭代在 Terminal-Bench 2 上把 pass@1 从 69.7% 推到 77.0%,超过 Codex(71.9%)、ACE(68.9%)与 TF-GRPO(72.3%),冻结后的 harness 迁移到 SWE-bench-verified 与三个跨族基座仍为正收益。
问题
要解决什么:coding agent 的 harness(system prompt、工具、middleware、skills、子 agent、长期记忆)现在靠人类手工适配每个新基座模型;作者把『自动进化 harness』的瓶颈定位为可观测性,而非演化 agent 的能力,并据此构建闭环。
为什么 prior work 不够:已有自动方法只优化单一组件(多数只动 prompt,如 ACE/TF-GRPO);可编辑表面异构、轨迹海量但有效信号稀疏、编辑效果难归因,导致自动化退化成无结构试错。
进化循环(搜索空间 → 算子 → 评估 → 选择)
搜索空间(什么被进化):NexAU 框架暴露的 7 类 harness 组件文件:system prompt、tool description、tool implementation、middleware、skill、sub-agent config、long-term memory,固定挂载点、松散耦合;演化 agent 只写 harness workspace,runs/tracer/verifier/LLM 配置只读,种子 system prompt 标记不可删除。
变异/提案算子:
- 每轮 6 阶段(Algorithm 1):rollout(每任务 k≥2 次)→ 归一化轨迹 → 归因上轮 manifest 并回滚被否编辑 → Agent Debugger 把 ~10M token 轨迹蒸馏成逐任务分析报告 + benchmark 级 overview(~10K token)→ Evolve Agent 写组件编辑与 manifest → git commit
- manifest 契约:每个编辑声明目标失败证据、推断根因、预期修复集与预期回归集,下一轮用任务级 delta 与预测集合求交生成 verdict
- one-shot explore agent 在第 1 轮平行注入少量可复用 skills,从第 2 轮起可被保留/改进/删除
评估方式:Terminal-Bench 2 全 89 任务(4 easy / 55 medium / 30 hard),每任务超时 1 小时,指标 pass@1 与 tokens/trial;跨 benchmark 迁移用 SWE-bench-verified 500 任务 7 仓库;三个 role agent 共用 GPT-5.4 high 一个基座,隔离 harness 编辑的贡献。
选择与归档:每个编辑是 file-level 可证伪声明:下一轮 verdict 命中预测修复则保留,否则文件粒度回滚;Hbest 按 pass@1 跟踪;组件非加性交互被显式承认——单组件收益和 +11.1pp 高于全 AHE 的 +7.3pp,说明叠加有效编辑会封顶总增益。
自我改进程度:L1:固定模型 + harness 自进化。演化 agent 只能改 harness workspace,不能改 verifier、换模型或调高推理预算;论文自承不提供完整护栏栈,属受控研究原型。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|
输出
| 名称 | 类型 | 说明 |
|---|
数据集
| 数据 | 规模 | 备注 |
|---|
架构(摘要)
主干与结构
backbone:
参数:
类型:
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| Terminal-Bench 2 pass@1(89 任务) | 77.0%(10 轮进化后 best-so-far) | Codex 71.9% / Terminus-2 62.9% / OpenCode 47.2%;自进化基线 ACE 68.9% / TF-GRPO 72.3%;共享种子 NexAU0 69.7% | GPT-5.4 high 同时担任 Code/ Debugger/ Evolve 三角色;每任务超时 1h;约 32 小时跑完 10 轮;k≥2 rollouts/任务 |
| SWE-bench-verified 成功率(冻结 harness 迁移,无再进化) | 75.6% | 共享种子 NexAU0 75.2%、ACE 74.6%、TF-GRPO 74.2% | 500 任务 7 仓库,GPT-5.4;tokens/trial 461k vs 种子 526k(−12%)、vs ACE 679k(−32%) |
| 跨基座迁移 pass@1 增益(Terminal-Bench 2,89 任务) | deepseek-v4-flash +10.1pp(51.7→61.8) | 同一基座上的 NexAU0 种子 | GPT-5.4 high 上进化出的 workspace 直接换基座复评;qwen-3.6-plus +6.3pp、gemini-3.1-flash-lite +5.1pp、GPT-5.4 medium/xhigh 各 +2.3pp |
| 组件消融(单组件换入种子,Terminal-Bench 2 全 89 任务) | +memory only 75.3%(Hard 63.3%)、+tool only 73.0%、+middleware only 71.9%、+system_prompt only 67.4% | NexAU0 种子 69.7%;AHE full 77.0% | 三个正组件收益和 +11.1pp 高于全 AHE +7.3pp,说明组件非加性交互封顶总增益;system prompt 单独插入反而 −2.3pp |
| 自我预测审计(9 轮交叉迭代均值) | fix precision 33.7% / fix recall 51.4%;regression precision 11.8% / regression recall 11.1% | 随机预测基线 6.5% / 10.6% / 5.6% / 5.4% | GPT-5.4 AHE loop,Terminal-Bench 2,每编辑 manifest 的预测与下一轮任务级 delta 求交 |
Insights
- 瓶颈是可观测性而非 agent 能力:把组件、经验、决策三面都变成另一 agent 可读的结构化工件后,演化 agent 能稳定收敛到更好 harness(§1 中心论断)
- 收益藏在工具、middleware 与长期记忆里,系统 prompt 单独插入反而 −2.3pp——事实性 harness 结构跨任务/跨模型迁移,散文级策略不迁移(§4.4.1)
- 组件非加性交互:memory/middleware/prompt 都在往同一个『closure 式验证』方向推,叠加后互相冗余、浪费 turn,全 AHE 的 +7.3pp 小于单组件收益和 +11.1pp(§4.4.1)
- 自我归因对修复可靠、对回归失明:regression recall 11.1% 接近随机 5.4%,所以进化曲线非单调,回归预知是下一代自进化闭环最明确的方向(§4.4.2/§5)
vs 同类工作
- vs ACE / Training-Free GRPO:两者分别只优化自然语言 playbook 与轨迹分布,都不打开 scaffolding 编辑;AHE 联合进化 prompt+tool+middleware+memory 四个层
- vs Self-Harness:Self-Harness 以回归门禁选编辑,AHE 更进一步把每个编辑变成 file-level manifest 契约(预测集 vs 实际 delta),并做跨 benchmark/跨基座迁移验证
- vs Meta-Harness:Meta-Harness 把 harness 作为端到端优化图,AHE 的可观测性三支柱(组件/经验/决策)是显式设计主轴,且实验规模更大(89 任务 10 轮)
局限
- benchmark 范围:只在 Terminal-Bench 2 上驱动进化、SWE-bench-verified 上探测迁移,更广的编程语言、仓库级部署与人在环工作流未测(论文自承)
- 操作点耦合:step budget 与 per-task 超时是在 GPT-5.4 high 上拟合的,跨模型迁移数字混淆了 harness 可移植性与操作点耦合;族内收益非单调(+2.3 / +7.3 / +2.3 pp)(论文自承)
- 自改进治理不完整:编辑有 workspace 边界与 manifest 回滚,但没有完整护栏栈,长期 harness 清理与防滥用未完成,应视为受控研究原型(论文自承)
- 我们读出:主结果来自单次 10 轮 campaign,无多随机种子统计;Hard 档(30 任务)AHE 53.3% 落后 Codex 56.7%;self-attribution 对回归几乎失明(recall 11.1% vs 随机 5.4%),非单调步进说明选择层有真实噪声
可复现性
- code:https://github.com/china-qijizhifeng/agentic-harness-engineering
- weights:GPT-5.4(high/medium/xhigh)、qwen-3.6-plus、gemini-3.1-flash-lite-preview、deepseek-v4-flash
- sim_benchmark:Terminal-Bench 2(89 任务)、SWE-bench-verified(500 任务 / 7 仓库)
AHE 架构:三大可观测性支柱组成的进化闭环
Mermaid 数据流
flowchart TD
    H0["种子 harness H0\n(bash-only:单个 shell 工具)"] --> ROLL["Phase 1: rollout\n(每任务 k≥2 次)"]
    ROLL --> CLEAN["Phase 2: 轨迹归一化\n(canonical 形式)"]
    CLEAN --> ATTR["Phase 3: 归因上轮 manifest\n+ 回滚被否编辑"]
    ATTR --> DBG["Phase 4: Agent Debugger\n(~10M token 轨迹 →\n逐任务报告 + overview)"]
    DBG --> EVO["Phase 5: Evolve Agent\n(写组件编辑 + manifest 预测)"]
    EVO --> COMMIT["Phase 6: git commit\n(文件级 diff + 回滚粒度)"]
    COMMIT -->|"下一轮"| ROLL
    VER["下一轮任务级 delta"] -->|"与预测集求交\n生成 verdict"| ATTR
    WS["harness workspace(7 类组件文件)\n只写;runs/tracer/verifier/LLM 配置只读"] --> EVO
    WS --> ROLL
组件详解
- 组件可观测性(Component Observability):NexAU 框架把 harness 暴露为 7 类文件——system prompt、tool description、tool implementation、middleware、skill、sub-agent config、long-term memory——固定挂载点、松散耦合。每个失败模式映射到单个组件类,每个逻辑编辑是一个 commit,得到免费的 file-level diff 与 rollback。种子被压到最小(只有 shell 工具),让每个新组件靠实测挣得位置。
设计要点- **one-shot explore agent**:第 1 轮平行注入少量从公开 coding-agent 参考沉淀的可复用技能,从第 2 轮起与其它组件一样接受保留/改进/删除——种子阶段的先验被刻意最小化,但允许一个初始技能库参与竞争。
设计要点
1. 可观测性优先于能力:作者的核心断言是——一旦演化 agent 拿到结构化上下文与清晰动作空间,就能稳定收敛到更好的 harness;瓶颈在信息形态,不在模型。
2. 契约式迭代:每个编辑都必须在下轮被验证或回滚,进化的每一步都有可审计的因果链。
3. 组件非加性:消融显示单组件收益和(+11.1pp)高于全 AHE(+7.3pp),说明组件交互会封顶增益——作者把「interaction-aware evolution」留给未来。
4. 回归失明是已知缺口:self-attribution 对修复预测远强于随机(recall 51.4% vs 10.6%),对回归预测接近随机(recall 11.1% vs 5.4%),直接指向下一代闭环的改进方向。
AHE 在 Terminal-Bench 2 上越过全部人类设计与自进化 baseline
原文 caption:AHE evolves a bash-only seed past every human-designed and self-evolving baseline on Terminal-Bench 2. All three role agents share one base model, isolating the gain to harness edits rather than analyzer or editor capability.
头条结果:从只带单个 shell 工具的 bash-only 种子(69.7%)出发,10 轮进化把 pass@1 推到 77.0%,同时压过人类设计的 Codex(71.9%)/ Terminus-2(62.9%)/ OpenCode(47.2%)与自进化 baseline ACE(68.9%)/ TF-GRPO(72.3%)。读图看曲线旁标注的四条被采纳编辑(超时、publish-state guard、跨步风险监控、post-success 硬阻断),它们展示了『非 prompt 类』编辑长什么样。
AHE 三大可观测性支柱组成的闭环
原文 caption:The AHE pipeline links three observable surfaces into one closed loop. Components, rollout experience, and edit decisions each surface as structured artifacts another agent reads, and every edit becomes a falsifiable prediction the next round verifies.
架构图:组件可观测性(6+ 类组件文件)、经验可观测性(~10M token 原始轨迹 → Agent Debugger → ~10K token 证据)、决策可观测性(Evolve Agent 改组件并留 manifest)三者串成一个闭环。读图回答『为什么是观测性而非 agent 能力』——每个环节都以另一 agent 可读的结构化工件呈现。
冻结 harness 跨基座迁移:5 个基座全部正收益
原文 caption:Cross-model transfer on Terminal-Bench 2, 89 tasks. The AHE workspace evolved on GPT-5.4 high is re-evaluated on each base without further evolution, paired against the NexAU0 seed on the same base. All bases gain over the seed, with cross-family bases gaining more than within-family ones.
证明进化出的组件编码了通用协调模式而非 benchmark 特调:deepseek-v4-flash +10.1pp(51.7→61.8)、qwen-3.6-plus +6.3pp、gemini-3.1-flash-lite +5.1pp,而 GPT-5.4 族内 medium/xhigh 只有 +2.3pp。读图看跨族收益大于族内——离饱和越远的基座越依赖 harness 里固化下来的协调逻辑。
演化模型自我预测的精度与召回:修复可靠、回归失明
原文 caption:Cross-iteration mean precision and recall of the evolve model's self-predictions across 9 evaluation rounds of the GPT-5.4 AHE loop on Terminal-Bench 2, alongside the random-prediction baseline. Left: fix predictions. Right: regression predictions.
自我归因审计:fix precision 33.7% vs 随机 6.5%、fix recall 51.4% vs 10.6%(远超随机);但 regression precision 11.8% vs 随机 5.6%、recall 11.1% vs 5.4%——几乎等于随机。读图得出论文自己的结论:loop 对『这次编辑能修什么』有判断力,对『这次编辑会弄坏什么』没有预知,这正是进化曲线非单调的来源。
AHE:把 harness 进化变成工程(对话版)
小播:今天聊一篇很「工程化」的自进化论文——复旦、北大和上海期智的团队,把 coding agent 的外壳进化做成了一个能审计、能回滚的流水线。
老播:论文叫 Agentic Harness Engineering,简称 AHE。它最反直觉的一句话是:自动进化 harness 的瓶颈,根本不在模型能力,而在可观测性——你让进化 agent 看到什么、能改什么、改了怎么验证,这三件事做对了,进化自然就收敛了。
小播:等等,「外壳」还是先解释一下。
老播:就是 agent 周围那些可编辑的组件:系统提示词、工具定义、中间件、技能、子代理、长期记忆。AHE 在 Terminal-Bench 2 上,从只带一个 shell 工具的极简种子出发,十轮进化把通过率从 69.7% 推到 77.0%,压过了人类设计的 Codex、Terminus-2、OpenCode,也压过了两个自进化基线。今天我们就拆这个流水线。
第一段:问题——为什么 harness 要自动进化
小播:先给个为什么。手动调不行吗?
老播:行,但跟不上。coding agent 的表现既靠基座模型,也靠外壳;而且最佳外壳是模型特有的——给一个模型调好的外壳,换到另一个模型上经常变差。基座模型几个月一代,人手工适配根本忙不过来。
小播:那之前自动化的尝试呢?
老播:多数只优化一个组件,最常见的就是提示词。但提示词只是外壳的一层。AHE 的做法是把七类组件都打开:系统提示词、工具描述、工具实现、中间件、技能、子代理配置、长期记忆,全部文件化、全部可编辑。这样每个失败模式都能映射到具体一个组件文件,而不是散落在几百行散文里。
第二段:机制——三大可观测性
小播:那「可观测性」具体指什么?
老播:三件事。第一,组件可观测:七类组件都是独立文件,每次编辑是一个 git 提交,天然有文件级 diff 和回滚粒度。第二,经验可观测:每轮 rollout 会产生上千万 token 的原始轨迹,一个叫 Agent Debugger 的角色把这些轨迹当成可导航的文件系统,逐任务分析根因,压缩成逐任务报告加一份总览——进化 agent 读的是结构化的约一万 token 证据,而不是千万 token 日志。
小播:第三个呢?决策怎么可观测?
老播:这是最精彩的一环。每个编辑都附带一份 manifest——你针对什么失败证据、推断的根因、预期修好哪些任务、预期可能弄坏哪些任务。下一轮用实际的任务级分数变化和这些预测做交集,产生一个判定:预测中了就保留,没中就按文件回滚。每个编辑都变成一条可证伪的契约。
小播:也就是说,它不能只写「我觉得这个改动好」,必须写「我认为它会修好这几个、弄坏那几个」,然后下轮对账?
老播:对,把自我辩解替换成可测量的对账。而且约束很硬:进化 agent 只能写 harness 工作区,运行目录、追踪器、验证器、模型配置全部只读,种子提示词不许删——这挡住了自修改者最想走的三条捷径:关掉验证器、换更强的模型、抬高推理预算。
第三段:关键结果——主结果、迁移、消融
小播:好,数据说话。主结果是什么?
老播:Terminal-Bench 2 全 89 个任务,每任务一小时超时,三个角色共用 GPT-5.4 high 一个基座。十轮进化,通过率从共享种子 69.7% 到 77.0%。对照:Codex 71.9%、Terminus-2 62.9%、OpenCode 47.2%;自进化基线 ACE 68.9%、训练无关的 GRPO 变体 72.3%。十轮大约跑了 32 个小时。
小播:那它是背下了 Terminal-Bench 的答案吗?换个环境还灵吗?
老播:这是全篇最关键的证据——冻结的 harness 一行不改,直接换场景。SWE-bench-verified,500 个任务、7 个仓库:成功率 75.6%,略高于共享种子的 75.2%,而且每个 trial 只花 46 万 token,比种子省 12%、比 ACE 省 32%。换基座更明显:DeepSeek 的 flash 型号 51.7% 到 61.8%,涨 10.1 个点;Qwen 的 plus 型号涨 6.3 个点;Gemini 的 flash-lite 涨 5.1 个点——都是跨模型家族的,收益反而比同家族换推理档位更大。
小播:为什么跨家族收益更大?
老播:作者的解释是:离饱和越远的模型,越依赖外壳里固化下来的协调模式;而 GPT-5.4 自己从提示词里就能重新推导出这套协调,边际收益就小。这也解释了消融结果:单独换入长期记忆 75.3%、工具 73.0%、中间件 71.9%,但单独换系统提示词反而跌到 67.4%,比种子的 69.7% 还低——事实性结构跨模型迁移,散文级策略不迁移。
小播:所以收益主要不在提示词?
老播:对,这是这篇论文跟所有「提示词优化派」的正面分歧:增益藏在工具、中间件和长期记忆里。但注意一个反直觉现象:三个正组件的收益加起来有 11.1 个点,比整套 AHE 的 7.3 个点还多——组件不是简单叠加,互相还有干扰,作者承认这是封顶总增益的原因。
第四段:局限与争议
小播:那这套系统最弱的一环在哪?
老播:作者自己用审计数字点出来了:它对「这次编辑能修好什么」预测得不错,修复召回 51.4%,远超随机基线的 10.6%;但对「这次编辑会弄坏什么」几乎没预知——回归召回只有 11.1%,随机基线是 5.4%。所以你看到进化曲线是非单调的,走走停停。作者说,回归预知是下一代自进化闭环最明确的方向。
小播:还有别的边界吗?
老播:有三条要记住。一是范围窄:只在 Terminal-Bench 2 上进化、SWE-bench 上探测迁移,其它语言、仓库级部署、人在环工作流都没测。二是操作点耦合:步数和超时是在 GPT-5.4 high 上拟合的,所以跨模型数字里混着「外壳可移植性」和「操作点适配」两个因素,同家族内收益非单调就是证据。三是主结果只有单次十轮 campaign,没有多随机种子统计,Hard 档 30 个任务上 AHE 53.3% 还落后 Codex 的 56.7%。
小播:也就是说,整体赢了,最难的那档反而输了?
老播:对,而且论文自己的归因是组件在长时程任务上互相干扰,不是能力缺失——把长期记忆单独换进种子,Hard 档就能超过 Codex。这条细节很值得读原文。
收尾:一句话记住这篇
小播:最后用一句话总结?
老播:AHE 用三大可观测性支柱——组件文件化、轨迹蒸馏、manifest 契约——把 harness 进化变成可审计工程,Terminal-Bench 2 上 69.7% 到 77.0%,冻结外壳在 SWE-bench 和三个跨族基座上仍然正收益。
小播:最该记住的数字呢?
老播:回归召回 11.1%,对随机基线的 5.4%——它能预知自己修好什么,却预知不了自己弄坏什么。这个数字提醒我们:自进化系统离「知道自己下一步会闯什么祸」还差得远,而这是它敢不敢上生产的分水岭。