SIA:同一个循环里,同时改 harness 和改权重
> 量子位技术拆解 · 双杠杆自改进的第一个系统尝试,证据标注为 provisional。完整结构化数据见「速查」tab。
先看一个现象:自改进 AI 研究分成了两条互不往来的线。harness 派(Darwin Gődel Machine、Meta-Harness、Hyperagents)让元 agent 重写任务 agent 的脚手架,但模型权重固定不动;test-time training 派(TTRL、Discover-TTT)用手写 RL 管线在测试时更新权重,但 harness 固定成单一 prompt 模板。Hexo Labs 的这篇论文(arXiv 2605.27276)把两条线接起来:一个 Feedback-Agent 在同一闭环里决定改 harness 还是改权重,系统叫 SIA,作者称它是第一个同时更新 scaffold 与权重的自改进循环。
核心思想:三个 agent,两个杠杆
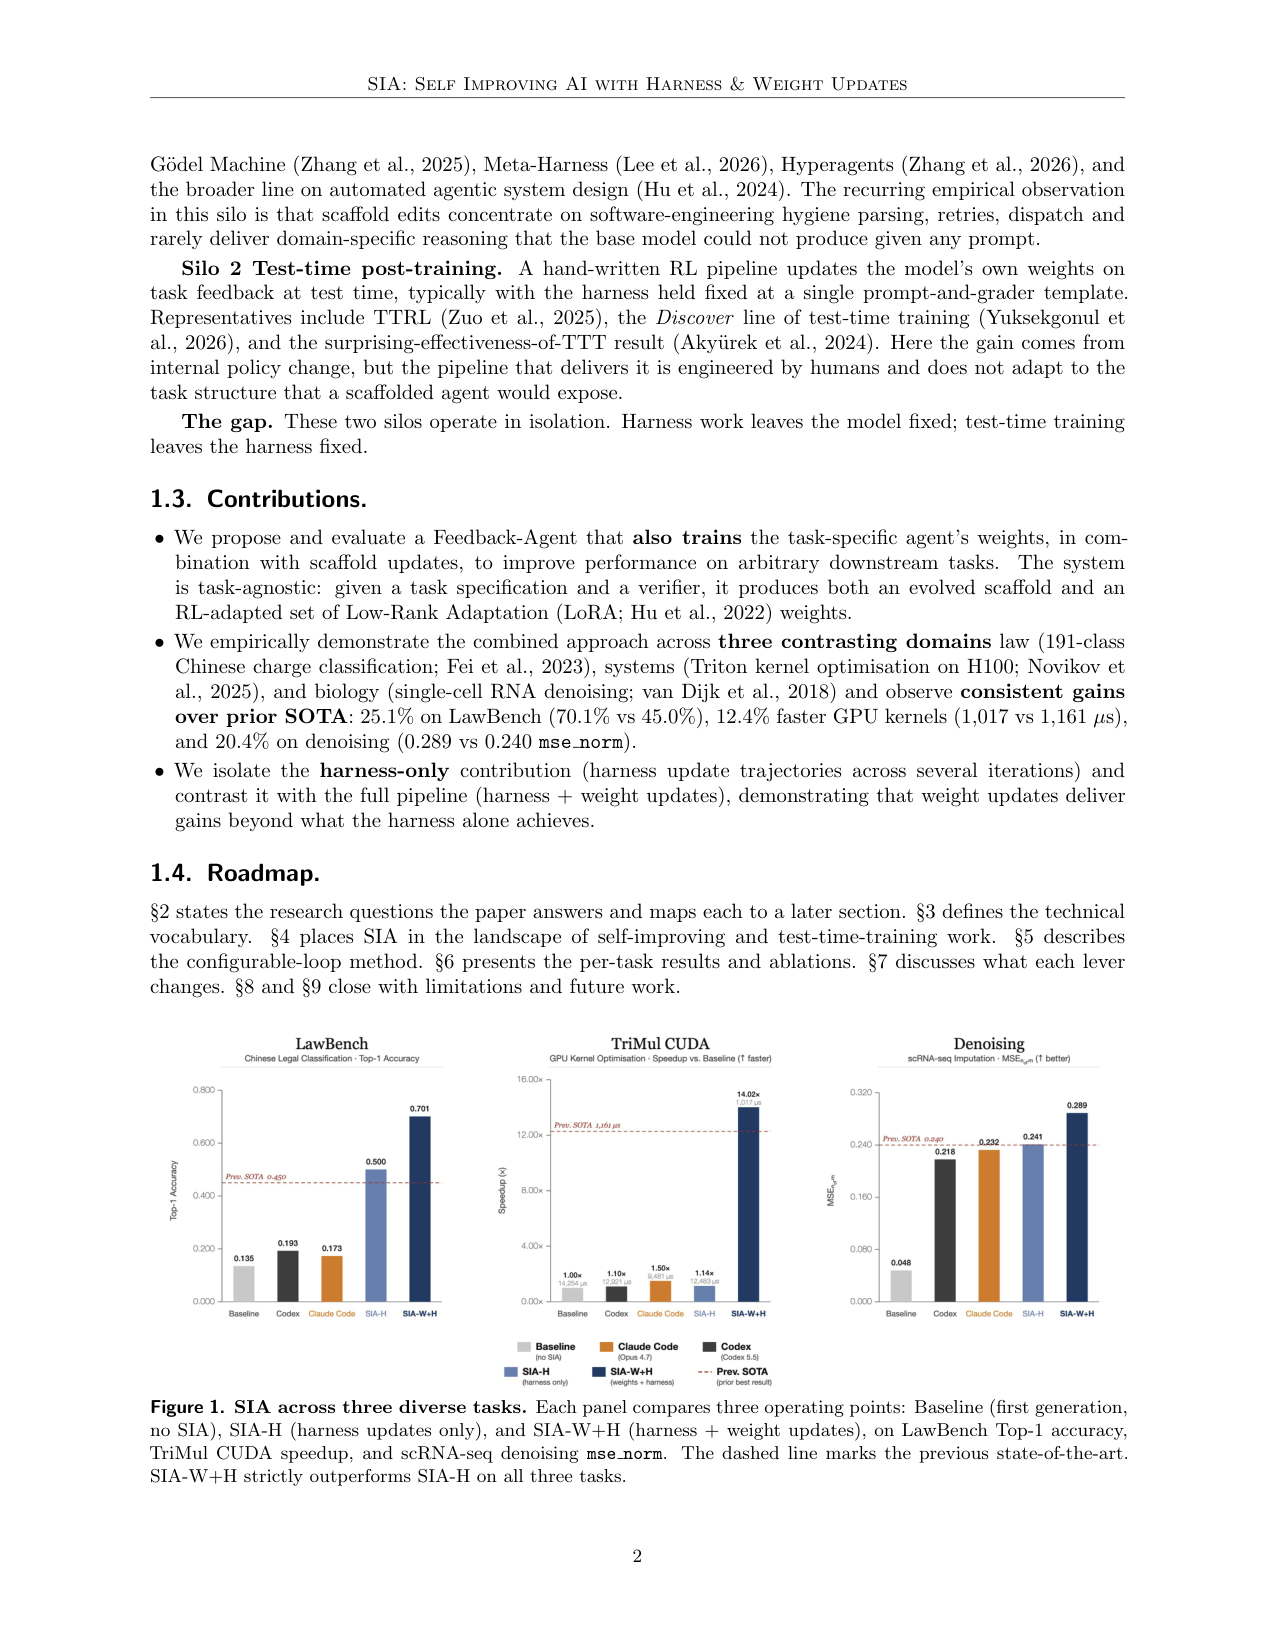
SIA 由三个角色构成。Meta-Agent 从任务规格 $U$ 与参考实现 $R$ 生成初始 scaffold:$A_1 = M(U, R)$。Task-Specific Agent 在沙箱里执行任务,记录完整轨迹 $\tau_g$(每个 prompt、工具调用、结果、抽取的答案)。Feedback-Agent 读上一代 scaffold $A_g$、轨迹 $\tau_g$ 与指标 $E_g$,每步选择两个动作之一:harness 更新
$$A_{g+1} = F(A_g,\, \tau_g(\pi_\theta),\, E_g,\, U)$$
(scaffold 进化、权重 $\theta$ 固定),或者权重更新——用 RL 更新 LoRA 适配器(rank 32,lr $4\times10^{-5}$)、scaffold 固定。两个动作是软标签而非固定阶段,Feedback-Agent 依据任务类型与奖励动态选择。
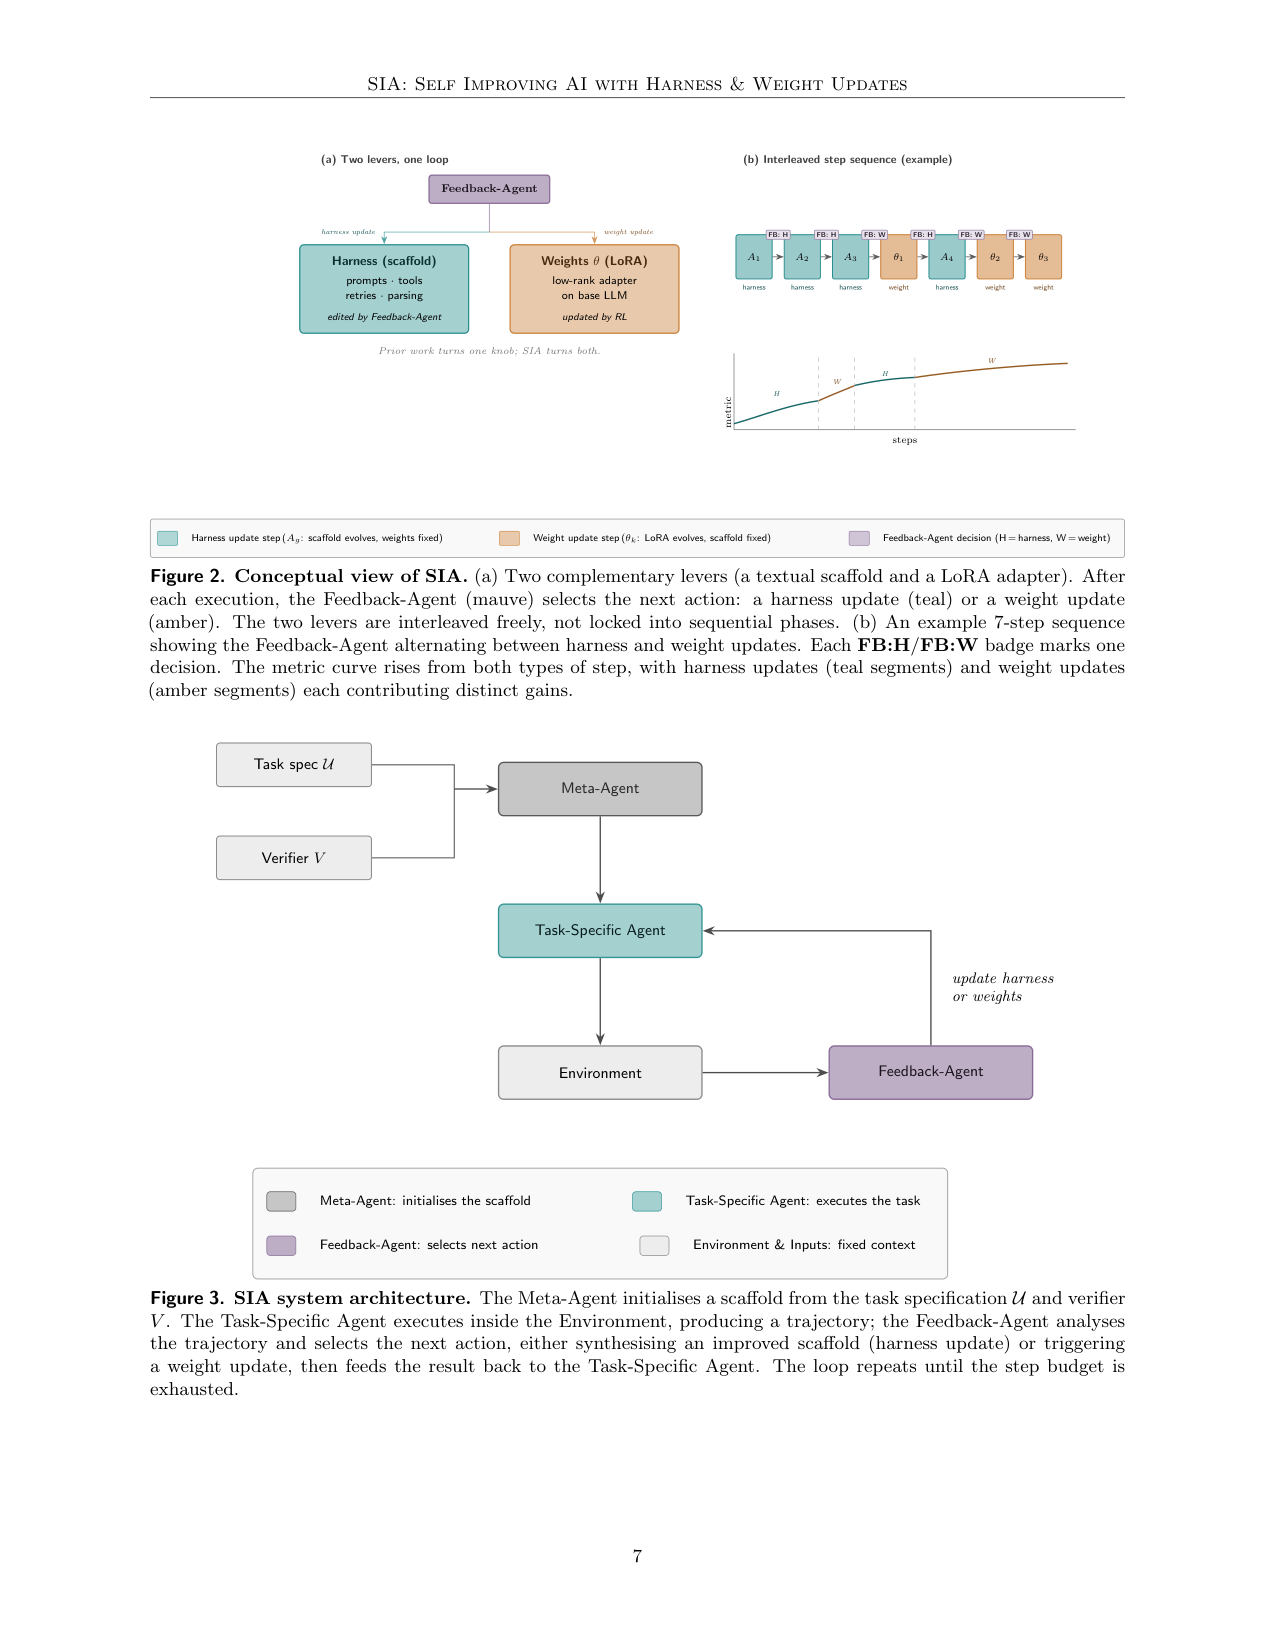
关键的设计自由度在 Feedback-Agent 的算法选择:LawBench 上它用了 PPO+GAE(稠密逐实例奖励、需要训练稳定),TriMul 上用了 entropic advantage weighting(稀疏结果、冷启动噪声大),denoising 上用了 GRPO(rollout 廉价)。作者明确说这些是按跨任务观察总结的规律、完整处理 defer 到 v2——这是全篇证据最薄弱、最需要打折读的地方。
调度节奏上,三个任务的 Feedback-Agent 都先跑 scaffold 迭代、等奖励停滞才切权重(图 2 展示了一种 7 步交错序列:H、H、W、H、W、W),说明双杠杆的收益来自「让 harness 先把能挤的都挤出来,再用权重补领域直觉」的分工,而非同时乱动。## 关键结果:双杠杆在三个领域都超过 harness-only
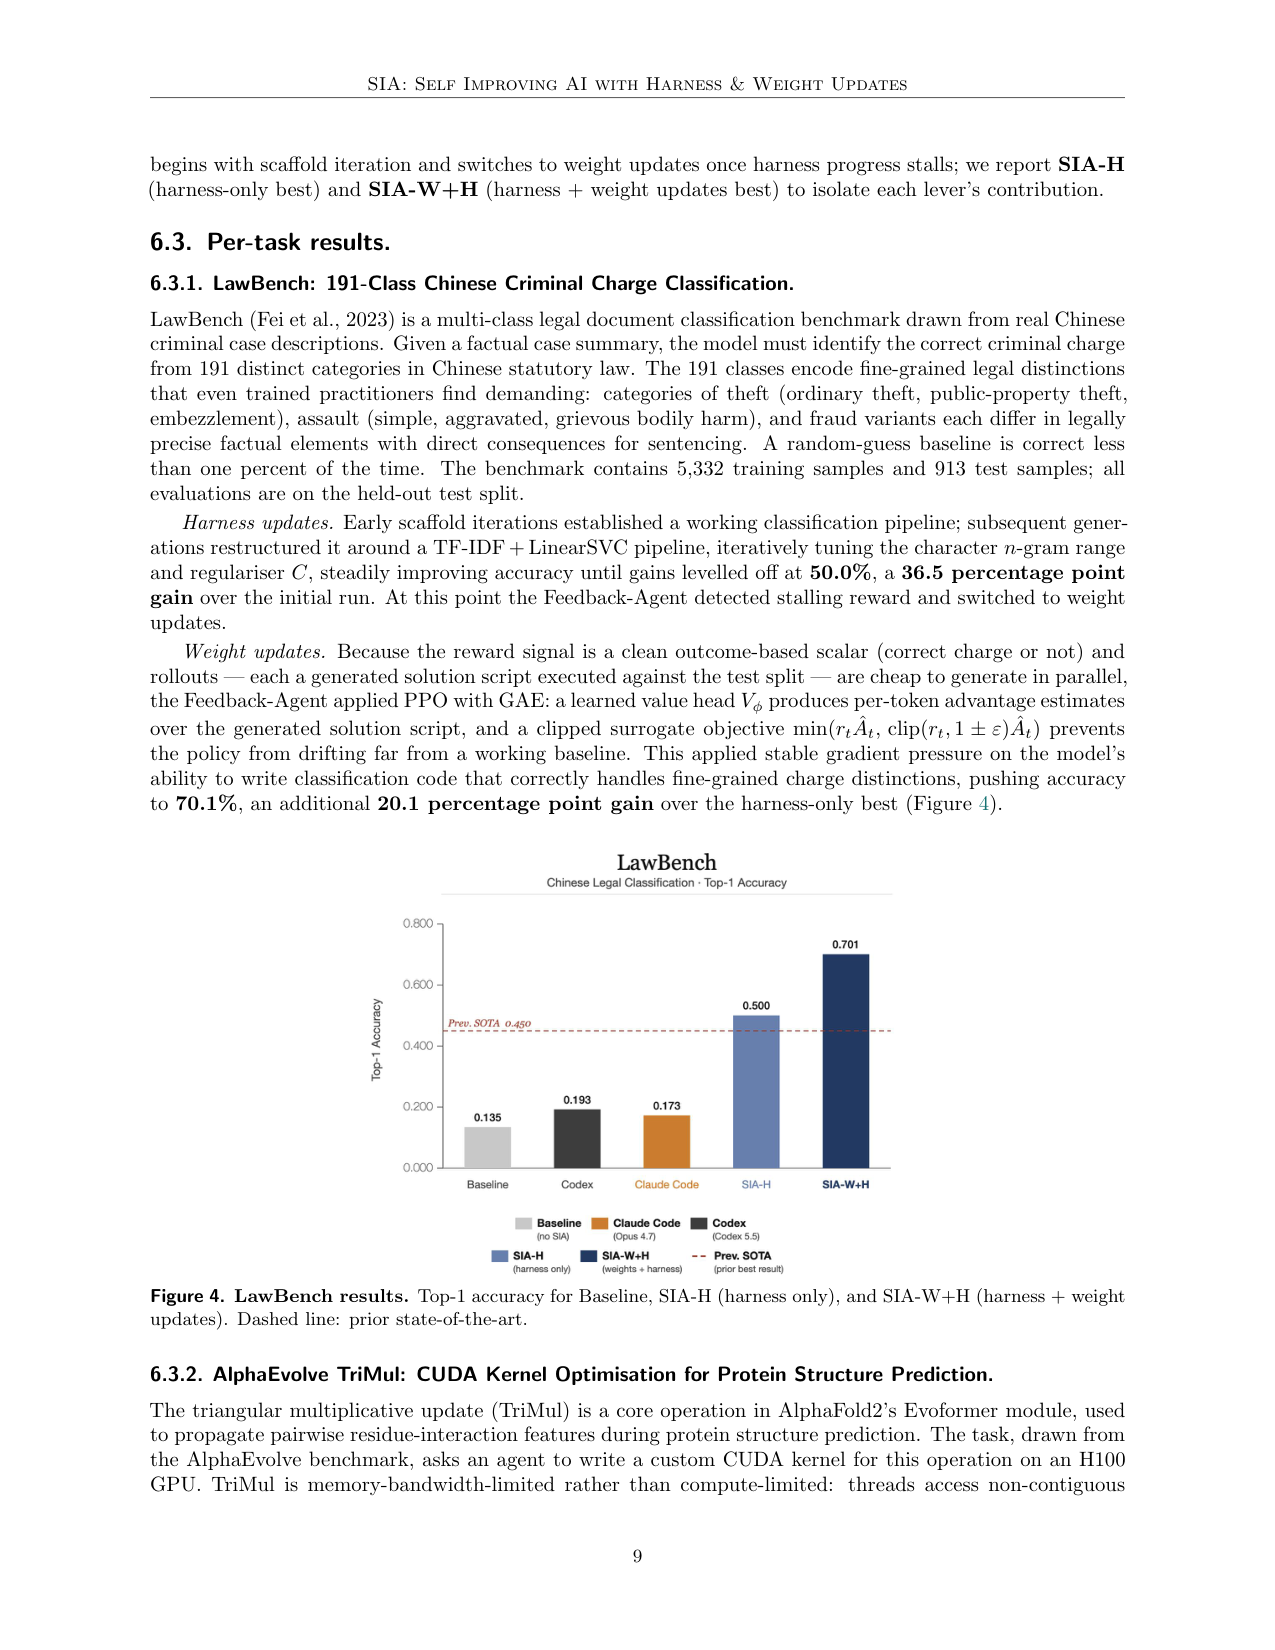
实验覆盖三个对比鲜明的领域,全部以 gpt-oss-120b 为任务基座、Claude Sonnet 4.6 当 Meta/Feedback-Agent。法律:LawBench 191 类中文罪名分类(5,332 训练 / 913 测试),初始 13.5% → harness-only 50.0% → 双杠杆 70.1%,前 SOTA 是 45.0%。harness 阶段把管线重构为 TF-IDF + LinearSVC 并调参,权重阶段用 PPO+GAE 再抬 20.1pp。系统:AlphaEvolve TriMul 的 CUDA kernel(H100,score = 1500/runtime),harness-only 收敛在 12,483µs(1.14×),权重更新后到 1,017µs(14.02×),前 SOTA 是 1,161µs——runtime 再砍 91.9%。生物:MAGIC scRNA-seq denoising(mse norm,越高越好),harness-only 0.241、双杠杆 0.289,前 SOTA 0.240。
论文用消融支撑「两个杠杆各管一段」的机制论断:harness 迭代产出的都是外部基础设施——LawBench 的答案抽取层与 SVC re-ranker、TriMul 的编译错误解析器与计时 harness、denoising 的批量配置驱动——全是软件工程改进;而权重更新产出的是 scaffold 给不出的领域直觉,比如 TriMul 的共享内存 tiling、fp32 寄存器累加、block size 选择,以及 denoising 里那个两行的 np.clip + np.rint(把 imputed 计数取整到非负整数)——第一权重 checkpoint 就引入了所有 harness 轮次都没生成过的结构性变换。因为两个杠杆占据不同变化空间,所以互不饱和。
局限与边界
执行协议上还有一个容易忽略的细节:Task-Specific Agent 在沙箱里只有数据集目录的只读权限与工作目录的读写权限,Meta-Agent 生成初始 scaffold 时会用多样化的任务规格做条件化,避免把脚手架过拟合到单个 benchmark 实例;而 Feedback-Agent 收到的奖励是确定性 verifier 的逐实例打分,三个任务各有一个独立 grader(法律用 held-out 测试集裁判、GPU 用 H100 计时、去噪用 MAGIC 参考 ground truth)。这套「verifier 固定 + 轨迹完整记录」的协议是双杠杆能同时运转的前提——没有可靠的奖励信号,权重更新就没有梯度来源。
局限与边界
作者自己点名了最深的坑:耦合共进化 Goodhart——harness 搜索与 RL 权重更新都对着同一个固定 verifier $V$ 优化,每个 pass 都在重塑另一个 pass 看到的分布,联合不动点是两个互相盲目的优化器的 Nash 均衡,可能在训练 verifier 上很强、扰动任一组件就脆。我们按论文的标注读证据:RL 算法选择是按观察模式描述的(provisional),每任务只有单条报告轨迹、无多随机种子统计;任务覆盖只有 3 个领域;TriMul 的 score=1500/runtime 是代理指标,与 SOTA 比较时基座与预算口径不统一;权重更新的 H100 训练成本没有与收益统一核算。杠杆切换靠「奖励停滞检测」启发式,选择策略本身的学习被列为 future work。
一句话记住这篇
SIA 是第一个让 Feedback-Agent 在同一闭环里动态选择「改 harness」或「改 LoRA 权重」的系统,三个领域都超过 harness-only:LawBench 70.1% vs 45.0% 前 SOTA、TriMul runtime 1,017µs vs 1,161µs、denoising 0.289 vs 0.240。最该记住的是它暴露的边界:双优化器对同一 verifier 的耦合共进化会产出看似很强、一碰就碎的联合不动点——以及证据本身还是 provisional 的。
SIA 是首个在同一闭环里同时进化 harness 与权重的自改进系统:Meta-Agent 生成初始 scaffold,Task-Specific Agent 执行,Feedback-Agent 看轨迹后每步选择『改 harness』还是『用 RL 更新 LoRA 权重』。在三个领域(LawBench top-1 70.1% vs 前 SOTA 45.0%、TriMul 1,017µs vs 1,161µs、scRNA denoising 0.289 vs 0.240)双杠杆都超过 harness-only,但作者自己承认证据是 provisional:RL 算法选择是按观察模式描述的、完整处理 defer 到 v2。
问题
要解决什么:人类是构建与改进 AI 的瓶颈:harness 自进化只改脚手架(权重固定),test-time training 只改权重(harness 固定),两条线互不往来。SIA 要证明一个 Feedback-Agent 能同时操作两个杠杆,让 harness 与权重在同一闭环里联合改进。
为什么 prior work 不够:harness 工作(Darwin Gődel Machine、Meta-Harness、Hyperagents)的脚手架编辑集中在软件工程卫生(解析、重试、分发),带不来基座模型给任何 prompt 都给不出的领域推理;test-time RL(TTRL、Discover-TTT)由人手写 RL 管线,不随任务结构调整。两者单独使用都只触及一半改进空间。
进化循环(搜索空间 → 算子 → 评估 → 选择)
搜索空间(什么被进化):双杠杆:① scaffold/harness——system prompt、tool-dispatch 逻辑、retry 策略、answer extraction 代码可编辑;② 模型权重 θ——通过 LoRA(rank 32,lr 4×10⁻⁵)在 RL 步骤可更新;基座 gpt-oss-120b 与确定性 verifier(grader)固定,任务规格 U 与参考实现 R 只读。
变异/提案算子:
- Meta-Agent M 从 (U, R) 生成初始 scaffold A1 = M(U, R)
- 执行→分析→改进三步协议:Task-Specific Agent 在沙箱里跑 D 并记录完整轨迹 τ_g;Feedback-Agent F 读 (A_g, τ_g, E_g, U) 产出改进报告与 A_{g+1}
- Feedback-Agent 每步动态选择动作:harness 更新(A_{g+1} = F(A_g, τ_g(π_θ), E_g, U),权重固定)或权重更新(自选 RL 算法:PPO+GAE / entropic advantage weighting / GRPO,scaffold 固定)
评估方式:确定性 verifier 逐实例算 reward:LawBench 191 类中文罪名分类(5,332 训练 / 913 测试,held-out test-split grader,top-1 准确率);AlphaEvolve TriMul CUDA kernel(H100 计时,score = 1500/runtime);MAGIC scRNA-seq denoising(对 ground truth 的 mse norm,∈[0,1] 越高越好)。
选择与归档:无显式种群/归档;以步骤预算为界,Feedback-Agent 凭『奖励动态停滞』启发式从 harness 步骤切到权重步骤(先 harness 后权重);报告 SIA-H(harness-only 最优)与 SIA-W+H(双杠杆最优)两个操作点;论文自承动作选择策略是 frozen LLM prior,把选择策略本身的学习列为 future work。
自我改进程度:L2 边界:被优化对象同时包含 scaffold 与 LoRA 权重(联合优化),达到『harness 与权重联合更新』;但 Feedback-Agent 自身的决策策略不进化,论文明确说 Meta-RL over action-selection 是 future work,所以严格说停在 L2 的工程实现层。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|
输出
| 名称 | 类型 | 说明 |
|---|
数据集
| 数据 | 规模 | 备注 |
|---|
架构(摘要)
主干与结构
backbone:
参数:
类型:
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| LawBench top-1 准确率(191 类中文罪名分类) | SIA-W+H 70.1% | 前 SOTA 45.0%;SIA-H(harness only)50.0%;初始 13.5% | 5,332 训练 / 913 held-out 测试;gpt-oss-120b + LoRA rank 32;Meta/Feedback-Agent = Claude Sonnet 4.6;权重更新用 PPO+GAE |
| AlphaEvolve TriMul CUDA kernel(score=1500/runtime) | SIA-W+H 1.475(runtime 1,017 µs,14.02×) | 前 SOTA 1.292(1,161 µs);SIA-H 0.120(12,483 µs,1.14×);初始 0.105 | H100 GPU,固定输入形状;harness 阶段收敛 12,483µs 后切 entropic advantage weighting 权重更新,runtime 再降 91.9% |
| MAGIC scRNA-seq denoising(mse norm,越高越好) | SIA-W+H 0.289 | 前 SOTA 0.240;SIA-H 0.241;初始 0.048 | 胰腺 scRNA-seq 数据;GRPO 权重更新;首个权重 checkpoint 引入 np.clip+np.rint 两行结构性变换(非负整数取整) |
| 双杠杆 vs harness-only 的消融 | 三任务全部严格超越:+20.1pp(LawBench)、91.9% runtime 缩减(TriMul)、+20%(denoising) | SIA-H(harness only) | 同一任务、同一 verifier、同一基座;仅 Feedback-Agent 的动作序列不同 |
Insights
- 两个杠杆占据不同变化空间:harness 迭代产出外部基础设施(工具、解析器、重试、搜索过程),权重更新产出 scaffold 编码不了的领域直觉(TriMul 的 H100 共享内存 tiling;denoising 的非负整数取整),所以互不饱和(§7.2–7.4)
- Feedback-Agent 的算法选择与任务结构匹配:LawBench 稠密逐实例奖励用 PPO+GAE,TriMul 稀疏结果用 entropic advantage weighting 对抗冷启动噪声,denoising 廉价 rollout 用 GRPO——但作者明确说这些是观察到的模式、完整处理 defer 到 v2
- harness 先收敛、权重再接管:三个任务都先跑 scaffold 迭代到平台(LawBench 50.0%、TriMul 12,483µs)才切权重,『停滞检测 + 杠杆切换』是闭环的实际调度逻辑
- 耦合共进化 Goodhart 风险被作者自己点名:两个优化器对着同一 verifier 优化,联合不动点是对彼此盲目的 Nash 均衡(§8)
vs 同类工作
- vs Hyperagents(最接近的并发工作):Hyperagents 让 meta-mechanism 规则也可编辑但权重固定;SIA 增加权重杠杆,且 Feedback-Agent 动态选择动作
- vs Darwin Gődel Machine / Meta-Harness:只进化 agent 源码/ harness 图;SIA 在 harness 收敛后继续用 RL 更新 LoRA
- vs TTRL / Discover-TTT:test-time RL 的 harness 固定为单一 prompt-and-grader 模板;SIA 的 rollout 是 scaffolded 的,reward 是确定性 verifier
局限
- 耦合共进化 Goodhart:harness 搜索与 RL 权重更新都优化同一固定 verifier V,联合不动点是两个互相盲目的优化器的 Nash 均衡,可能在训练 verifier 上很强、扰动任一组件就脆(论文自承,§8)
- 证据是 provisional:RL 算法选择(PPO/entropic weighting/GRPO)按跨任务观察模式描述,作者说完整处理 defer 到 v2;每个任务只有单条报告轨迹,无多随机种子统计(我们读出)
- 任务覆盖窄:只有 3 个领域任务;TriMul 用 score=1500/runtime 这种代理指标,且与 SOTA 比较时基座/预算口径不一(我们读出)
- 选择策略是启发式 frozen LLM prior:杠杆切换(停滞检测)未学习,Meta-RL over action-selection 被列为 future work(论文自承)
- 我们读出:权重更新的成本(H100 RL 训练)没有与收益统一核算;『初始 13.5%』来自 Meta-Agent 一次性生成 scaffold 的 gpt-oss-120b,与 45.0% 的前 SOTA 可能用不同基座与预算,跨设置对比需谨慎
可复现性
- code:论文未提供代码仓库;训练基础设施为 Modal(H100)上的 RL 平台
- weights:gpt-oss-120b 基座 + LoRA rank 32(lr 4×10⁻⁵);Meta/Feedback-Agent = Claude Sonnet 4.6
- sim_benchmark:LawBench(191 类)、AlphaEvolve TriMul(H100)、MAGIC scRNA-seq denoising
SIA 架构:Feedback-Agent 双杠杆选择环
Mermaid 数据流
flowchart TD
    U["任务规格 U + 参考实现 R\n+ verifier V(固定)"] --> META["Meta-Agent\n(Claude Sonnet 4.6)"]
    META -->|"初始 scaffold A1 = M(U,R)"| TSA["Task-Specific Agent\n(gpt-oss-120b 或 RL 适配 checkpoint)"]
    TSA -->|"在沙箱 D 上执行"| TR["完整轨迹 τg + 指标 Eg"]
    TR --> FB["Feedback-Agent F\n(Claude Sonnet 4.6)"]
    FB -->|"选择:harness 更新"| HU["scaffold 进化\nA_{g+1} = F(A_g, τg(πθ), Eg, U)\n权重固定"]
    FB -->|"选择:权重更新"| WU["RL 更新 LoRA(rank 32)\nPPO+GAE / entropic weighting / GRPO\nscaffold 固定"]
    HU --> TSA
    WU --> TSA
    VER["确定性 verifier V\n逐实例 reward"] --> TSA
    TR --> VER
组件详解
- Meta-Agent:从任务规格与参考实现一次性生成初始 scaffold(system prompt + tool-dispatch 循环 + 输出解析器)。对多样任务规格做条件化,缓解对单实例的过拟合。所有报告分数都以「Meta-Agent scaffold 下的 gpt-oss-120b」为 initial baseline。
设计要点- **逐任务 verifier**:三个任务各有独立 grader——LawBench 用 held-out 测试集裁判、TriMul 用 H100 计时换算、denoising 用 MAGIC 参考 ground truth 算归一化误差;verifier 固定且确定性是权重更新步骤可用的前提。
设计要点
- 执行协议细节:Task-Specific Agent 在沙箱内数据集目录只读、工作目录读写;Feedback-Agent 的改进报告与下一代 agent 是两个显式产物(报告给人类审计,agent 进循环);Meta-Agent 用多样任务规格条件化生成初始 scaffold,缓解单实例过拟合。奖励全部来自确定性 verifier 的逐实例打分,是权重更新步骤的梯度来源。
设计要点
1. 双杠杆是结构性差异:图里 Feedback-Agent 的分支是 SIA 与 Hyperagents(只改 harness)、TTRL(只改权重)的分水岭——动作空间同时含「代码」与「梯度」。
2. 动态调度:三个任务都是「先 harness 后权重」——Feedback-Agent 检测到 harness 奖励停滞才切换,动作序列是数据驱动的软阶段而非固定管线。
3. 各管一段:harness 编辑产外部基础设施(工具/解析/重试),权重更新产领域直觉(H100 tiling、非负整数取整),变化空间互补、互不饱和。
4. 已知风险:耦合共进化 Goodhart——联合不动点是两个互相盲目的优化器的 Nash 均衡;选择策略本身还是 frozen LLM prior,Meta-RL over selection 是明确的 future work。
SIA 在三个任务上的三档操作点对比
原文 caption:SIA across three diverse tasks. Each panel compares three operating points: Baseline (first generation, no SIA), SIA-H (harness updates only), and SIA-W+H (harness + weight updates), on LawBench Top-1 accuracy, TriMul CUDA speedup, and scRNA-seq denoising mse norm. The dashed line marks the previous state-of-the-art. SIA-W+H strictly outperforms SIA-H on all three tasks.
头条结果图:三个领域里 SIA-W+H 都严格高于 SIA-H,且都越过前 SOTA 虚线(LawBench 70.1% vs 45.0%;TriMul 14.02× vs 1.16×;denoising 0.289 vs 0.240)。读图重点:harness-only(SIA-H)在 TriMul 上几乎没动(1.14×),说明纯脚手架搜索在这类任务上触顶,权重杠杆是增益的真正来源。
SIA 系统架构:三 agent 组成的选择环
原文 caption:SIA system architecture. The Meta-Agent initialises a scaffold from the task specification U and verifier V. The Task-Specific Agent executes inside the Environment, producing a trajectory; the Feedback-Agent analyses the trajectory and selects the next action, either synthesising an improved scaffold (harness update) or triggering a weight update, then feeds the result back to the Task-Specific Agent. The loop repeats until the step budget is exhausted.
架构图:Meta-Agent(初始化 scaffold)、Task-Specific Agent(执行)、Feedback-Agent(选择 harness 或权重动作)三者构成闭环,环境与 verifier 固定。读图回答『与单杠杆工作的区别在哪』:Feedback-Agent 的分支是唯一的决策点,也是 SIA 与 Hyperagents(只改 harness)/TTRL(只改权重)的结构性差异。
LawBench:权重杠杆带来 harness-only 之上的 20.1pp
原文 caption:LawBench results. Top-1 accuracy for Baseline, SIA-H (harness only), and SIA-W+H (harness + weight updates). Dashed line: prior state-of-the-art.
最干净的三段式证据:初始 13.5%(Meta-Agent scaffold + gpt-oss-120b)→ harness-only 50.0%(TF-IDF+LinearSVC 管线,36.5pp)→ 双杠杆 70.1%(PPO+GAE 权重更新,再 +20.1pp)。读图看『harness 先收敛、权重再接管』的节奏:Feedback-Agent 检测到 harness 停滞(50.0% 平台)才切到权重更新,这正是论文所说动态选择而非固定阶段。
SIA:同一个循环里,同时改 harness 和改权重(对话版)
小播:今天聊一篇野心很大的论文——让 AI 在一个循环里同时改自己的外壳和改自己的权重。这个组合以前没人做过。
老播:对,Hexo Labs 的 SIA。自改进研究一直分两派:一派改外壳,一派在测试时用强化学习改权重,两边互不往来。SIA 用一个 Feedback-Agent 把两个杠杆都握在手里,看轨迹后自己决定这步改哪个。三个领域都超过只改外壳的结果,但证据要打折读——作者自己标注了 provisional。
小播:先解释一下,为什么要同时改两样东西?
老播:因为两个杠杆管的事不一样。改外壳——提示词、工具分发逻辑、重试、答案抽取——产出的都是外部基础设施,软件工程意义上的改进。而权重更新能把「领域直觉」写进模型里,这是任何提示词都给不出的。比如后面会讲到,模型在权重更新后自己学会了 GPU 上的内存分块技巧。两件事都不碰,就只优化了一半。
第一段:问题——两条线的裂缝
老播:背景是这样:harness 派,比如达尔文哥德尔机、Meta-Harness、Hyperagents,都是元 agent 改写任务 agent 的脚手架,权重冻住;test-time training 派,比如 TTRL,用手写 RL 管线在测试时更新权重,外壳冻成一个固定模板。两派的共同点:都只动一半。
小播:所以 SIA 的贡献就是补上另一半?
老播:结构上是这样,但它还加了一个决定性的动作——让 Feedback-Agent 自己选。每跑完一代,它读完整轨迹和指标,要么产出一个改进的外壳,要么触发一次权重更新。选哪个、权重更新用哪个强化学习算法,都由它根据任务类型和奖励走势决定。注意三个任务上它选了三种算法:法律分类用了 PPO,GPU 内核用了熵加权,单细胞去噪用了 GRPO。
第二段:机制——三 agent 两杠杆
小播:系统里一共几个角色?
老播:三个。Meta-Agent 负责从任务规格和参考实现生成初始外壳;Task-Specific Agent 拿着外壳去沙箱里执行任务,把每一步都记成轨迹;Feedback-Agent 是大脑,读轨迹和指标,决定下一步改外壳还是改权重。基座是 gpt-oss-120b,权重更新走 LoRA,秩 32,学习率 4 乘 10 的负 5 次方。Meta 和 Feedback 都用的 Claude Sonnet 4.6。
小播:权重更新具体怎么做的?
老播:就是测试时强化学习:verifier 逐实例打分当奖励,rollout 后做梯度更新。关键在算法选择是数据驱动的——法律任务的奖励稠密、每步都能判,用 PPO 加 GAE 求稳定;GPU 内核大部分生成结果要么编译失败要么很差,用熵加权给高奖励 rollout 更多权重,对抗冷启动噪声;去噪任务的 rollout 便宜,用 GRPO。
小播:那 Feedback-Agent 怎么决定什么时候切换?
老播:论文里三个任务都是同一种节奏:先跑外壳迭代,改到奖励停滞——法律分类停在 50%,GPU 内核停在 1 万 2 千微秒——才切到权重更新。作者叫它「停滞检测加杠杆切换」,但注意,这套调度策略本身没有学习,是固定的启发式,这是后面要批评的点。
第三段:关键结果——三个领域的数据
小播:好,上数据。三个领域各是什么情况?
老播:法律:LawBench,191 类中文罪名分类,训练 5332 条、测试 913 条。初始只有 13.5%,外壳迭代把它抬到 50%,前 SOTA 是 45%;再上权重更新,70.1%。GPU:AlphaEvolve 的 TriMul 内核,在 H100 上优化,分数是 1500 除以运行时间。外壳迭代只到 1 万 2 千 483 微秒,1.14 倍;权重更新后 1017 微秒,14 倍,前 SOTA 是 1161 微秒。单细胞去噪:MAGIC 的指标是 mse norm,越高越好,外壳 0.241,权重后 0.289,前 SOTA 0.240。
小播:三个都过了前 SOTA,而且都超过只改外壳。权重那一杠杆贡献到底在哪?
老播:这就是论文最想展示的机制证据。GPU 那边,权重更新后模型内化的是 H100 特有的设计模式——共享内存分块、fp32 寄存器累加、块大小选择,这些是写进任何提示词都带不出来的知识。去噪那边更典型:第一个权重 checkpoint 就引入了一个两行的后处理,把预测值取整成非负整数——一个生物学上显然正确、但所有外壳迭代都没生成过的结构性变换。作者说,这就是「外部外壳」和「内部参数」各自占据不同变化空间的证据,所以两个杠杆不饱和。
第四段:局限与争议
小播:你开头说证据要打折读,打折在哪?
老播:作者自己点了最深的坑:耦合共进化 Goodhart。外壳搜索和权重更新都对着同一个 verifier 优化,一个在重塑另一个看到的分布——联合不动点是两个互相盲目的优化器的纳什均衡,可能在训练用的 verifier 上很强,一扰动就碎。这是双杠杆系统特有的风险,标准 Goodhart 分析都不覆盖。
小播:那「provisional」具体指什么?
老播:RL 算法选择是作者按跨任务观察总结的规律,不是受控实验,完整处理明确说 defer 到 v2。每个任务只有一条报告轨迹,没有多随机种子统计。任务覆盖只有三个领域。而且 TriMul 用的是「1500 除以运行时间」这种代理分数,跟别人家的 SOTA 比较时,基座和预算口径也不统一。还有一条我们读出来的:权重更新的训练成本没有和收益一起核算——你在 H100 上烧了多少 GPU 小时换这 20 个点,论文没给账。
小播:那它的贡献该怎么定位?
老播:一个双杠杆自改进的可行性证明加机制假说。它证明了「同一个循环里既改外壳又改权重」能跑通、能超过单杠杆,也证明了两个杠杆各管一段。但调度策略是启发式、算法选择是观察报告、证据是单次轨迹——读结论时请把这些限定带上。
收尾:一句话记住这篇
小播:最后用一句话总结?
老播:SIA 让 Feedback-Agent 在同一闭环里动态选择改 harness 还是改 LoRA 权重,三个领域全部超过 harness-only 和前 SOTA:法律 70.1% 对 45.0%,GPU 内核 1017 微秒对 1161 微秒,去噪 0.289 对 0.240。
小播:最该记住的数字呢?
老播:GPU 内核从 1 万 2 千 483 微秒到 1017 微秒——外壳迭代只做到 1.14 倍,权重更新一口气砍掉 91.9% 的运行时间。这个数字最直观地说明:当任务需要「模型内部的直觉」时,改外壳是有天花板的,而 SIA 是少数同时碰两个杠杆的工作之一。