ACE:把上下文当「进化中的 playbook」,而不是越写越短的 prompt
> 量子位技术拆解 · 先给现象再给机制。完整结构化数据见「速查」tab。
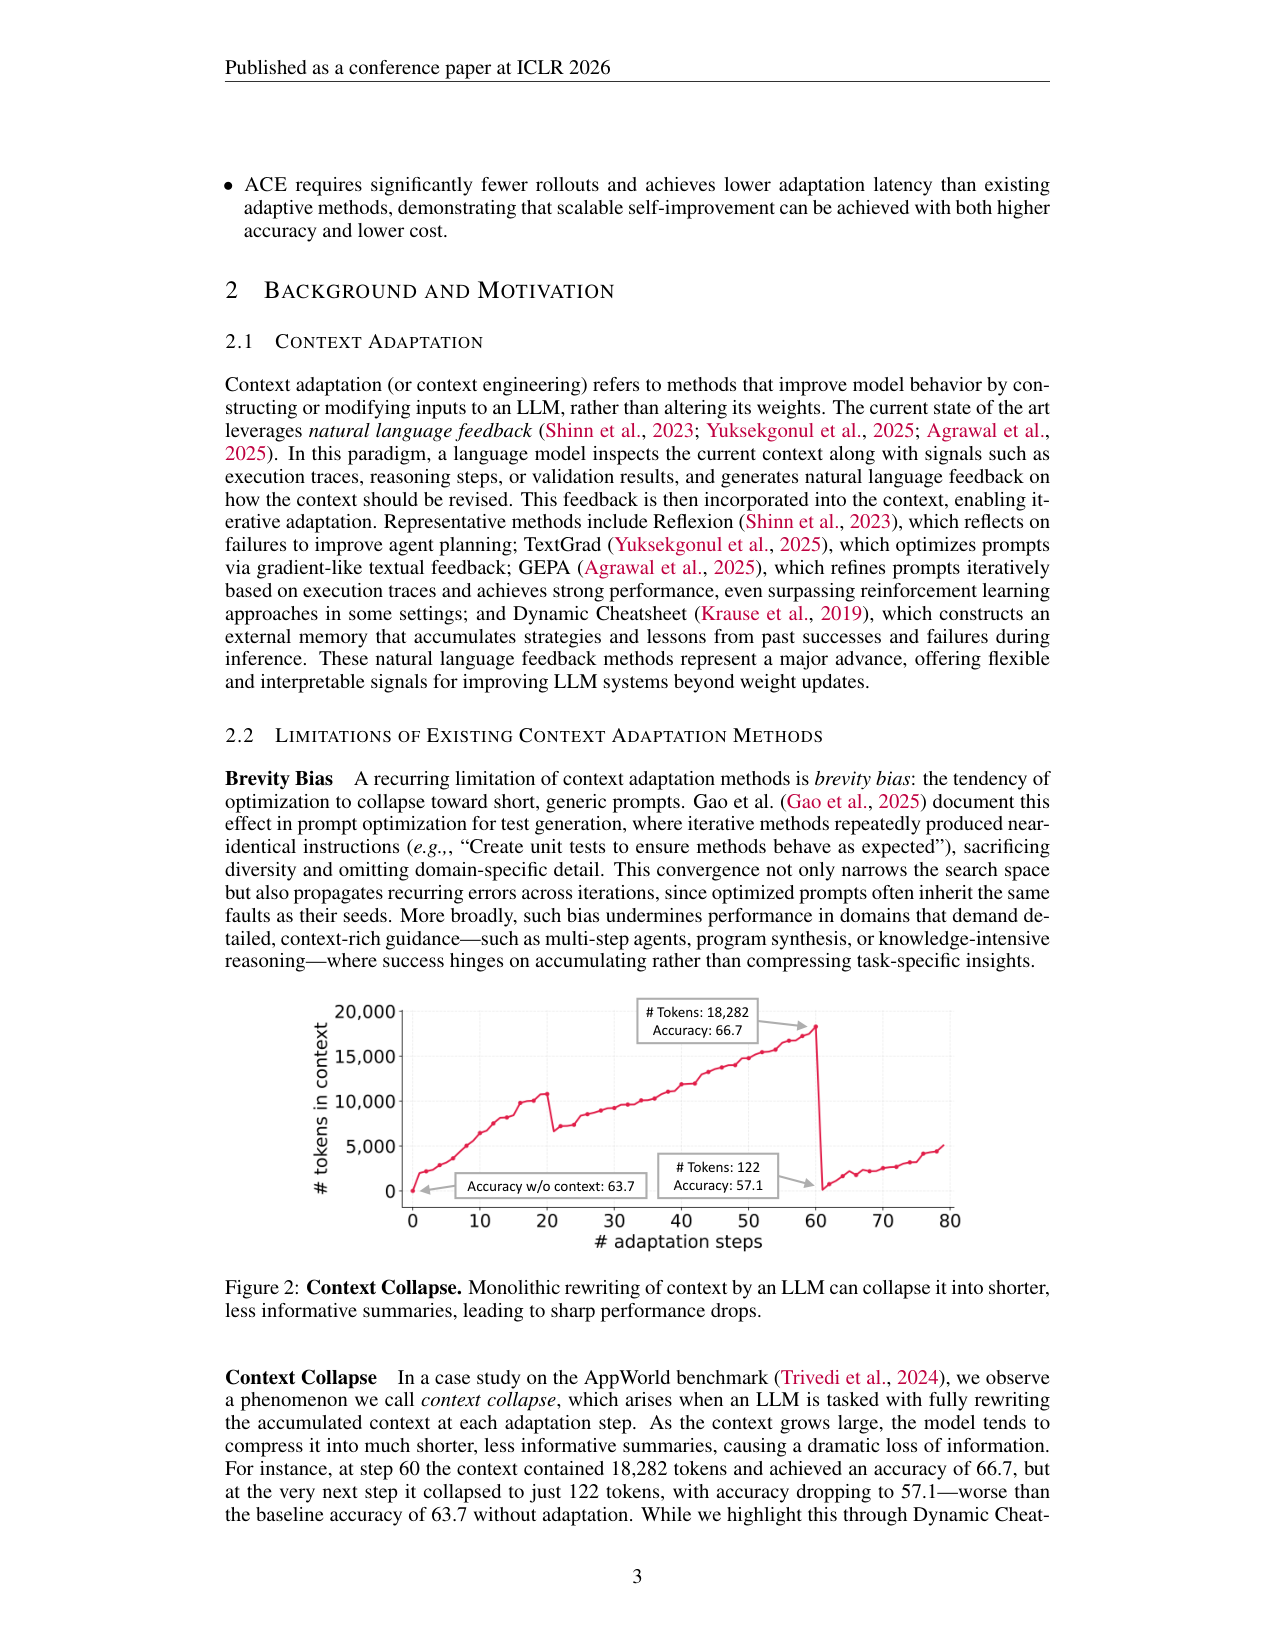
先看一个现象:LLM 应用的性能越来越依赖上下文——指令、策略、证据都往输入里塞。可一旦让 LLM 自己迭代改写上下文,两个毛病就来了。第一个叫 brevity bias:优化器偏爱短指令,把领域洞察压成「写更有效的测试」这种正确但没用的废话。第二个叫 context collapse:整体重写会把积累的知识瞬间抹掉。AppWorld 上有个触目惊心的例子:上下文长到 18,282 token、准确率 66.7% 的时候,下一步被整体重写成 122 token,准确率掉到 57.1%——比完全不用上下文(63.7%)还差(Fig.2)。
ACE(Agentic Context Engineering,ICLR 2026)开出的药方是:把上下文当一本可进化的 playbook,逐条增删,而不是整份重写。
核心机制:Generator → Reflector → Curator
框架有三个专职角色(Figure 4),模仿「做实验 → 反思 → 归档」的人类学习流程:
- Generator:解决新问题时生成推理轨迹,并高亮哪些 playbook 条目有用、哪些误导。
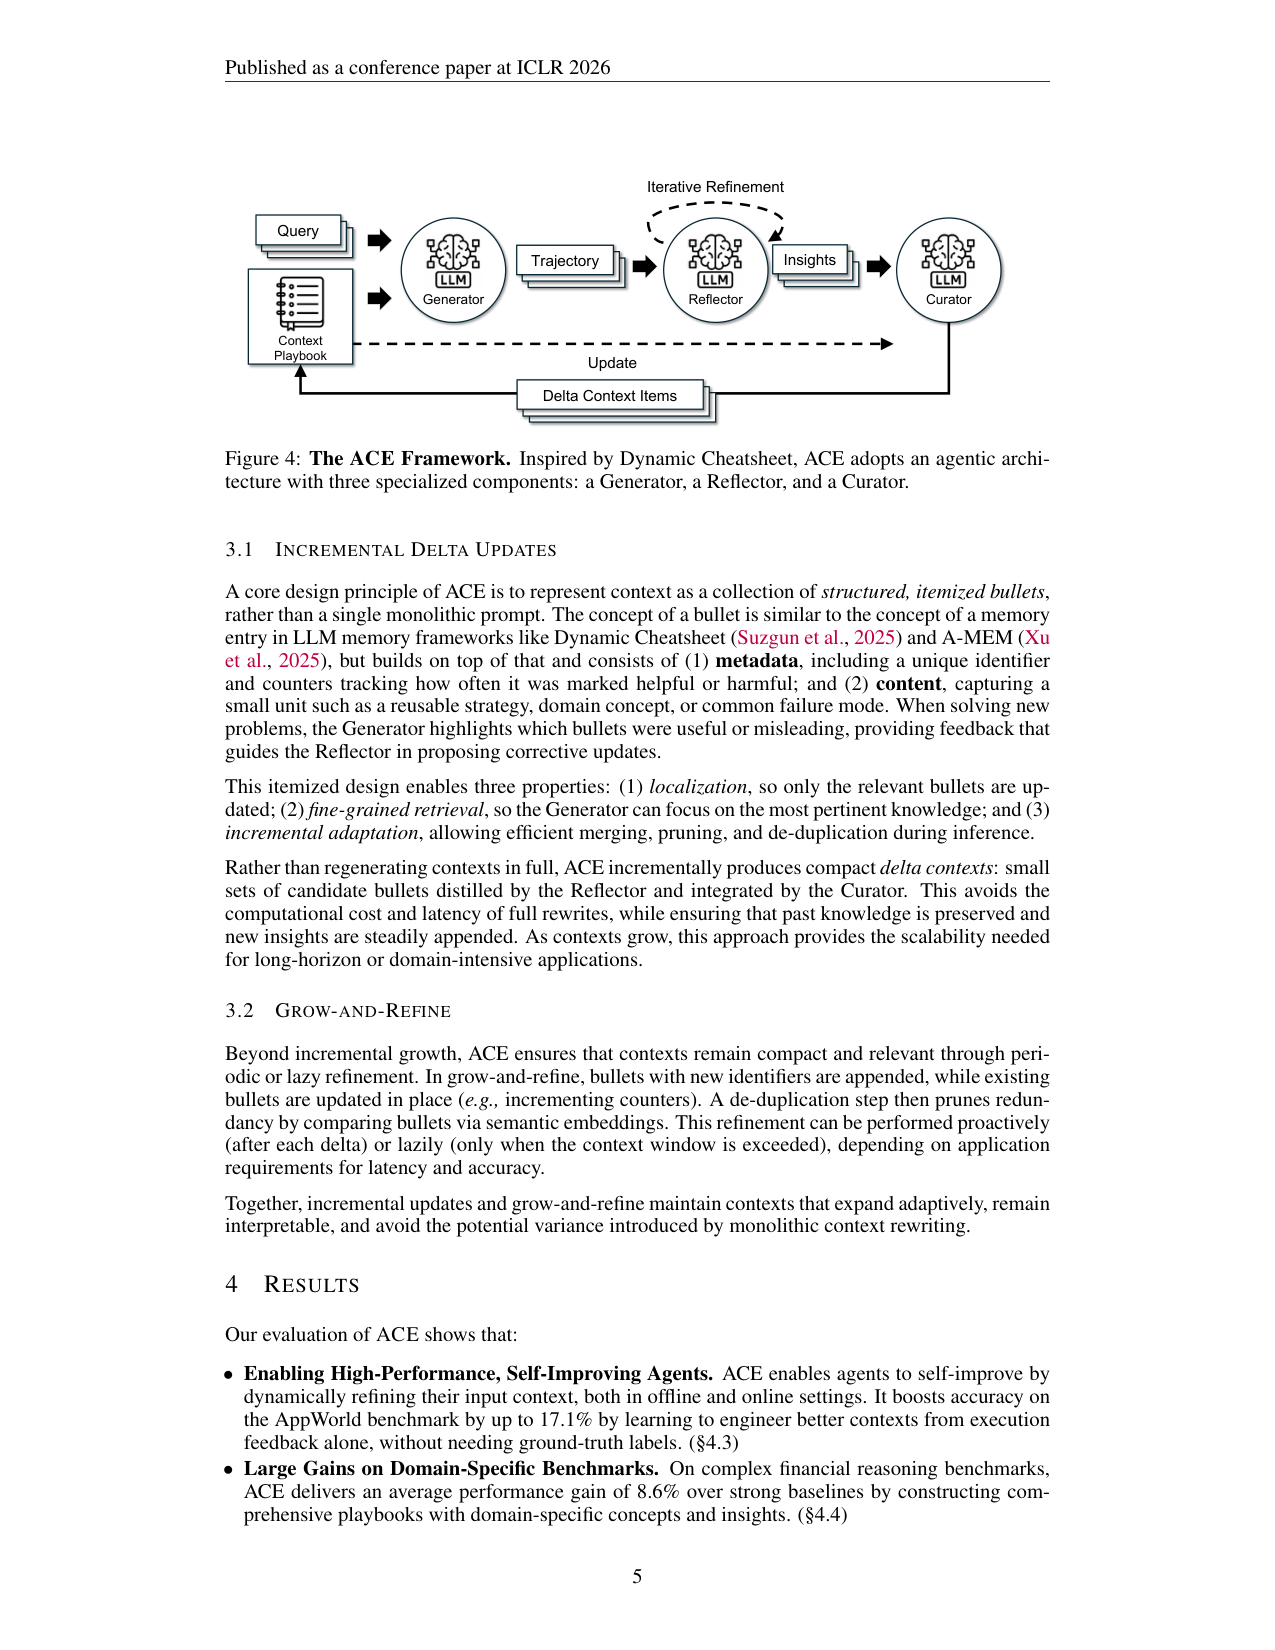
关键设计是条目的结构:每条 bullet 有 identifier(唯一标识)和 描述,外加 helpful/harmful 计数器。这带来三个性质:
1. 局部化:只更新相关的条目,不动整份上下文。
2. 细粒度检索:Generator 能聚焦到最相关的知识。
3. 增量适应:合并、剪枝、去重都可以在推理时低成本做。
再配一个 grow-and-refine 机制:新条目追加,旧条目原位更新计数器,冗余条目按语义嵌入比对去重——可以每个 delta 后主动做,也可以等上下文窗口快满时惰性做。
为什么合并必须用确定性逻辑?因为「策展」这个动作如果也交给 LLM 整体判断,就等于把 collapse 的风险请了回来——LLM 重写会压缩,压缩就丢细节。Curator 只做机械操作:新条目追加、旧条目改计数、重复条目删除,每一步都可预测、可审计、可并行。这让多路 delta 可以同时合并,批量适应成为可能。
为什么增量比整体重写稳
先给预期:下面这个对比要回答「整体重写到底坏在哪」。直觉是——LLM 重写长文本时倾向压缩,压缩就丢细节,而 agent 任务恰恰吃细节。
AppWorld 案例(Fig.2):
$$18{,}282 \text{ token / } 66.7\% \xrightarrow{\text{一次整体重写}} 122 \text{ token / } 57.1\%$$
右侧的 57.1% 低于无上下文 baseline 的 63.7%——压缩不仅没帮忙,还把已有的知识清零了。ACE 的 delta 更新把「重写」换成「追加 + 原位修改 + 去重」,细节只增不减,膨胀靠计数与去重控制。
关键结果:一张图看懂全面领先
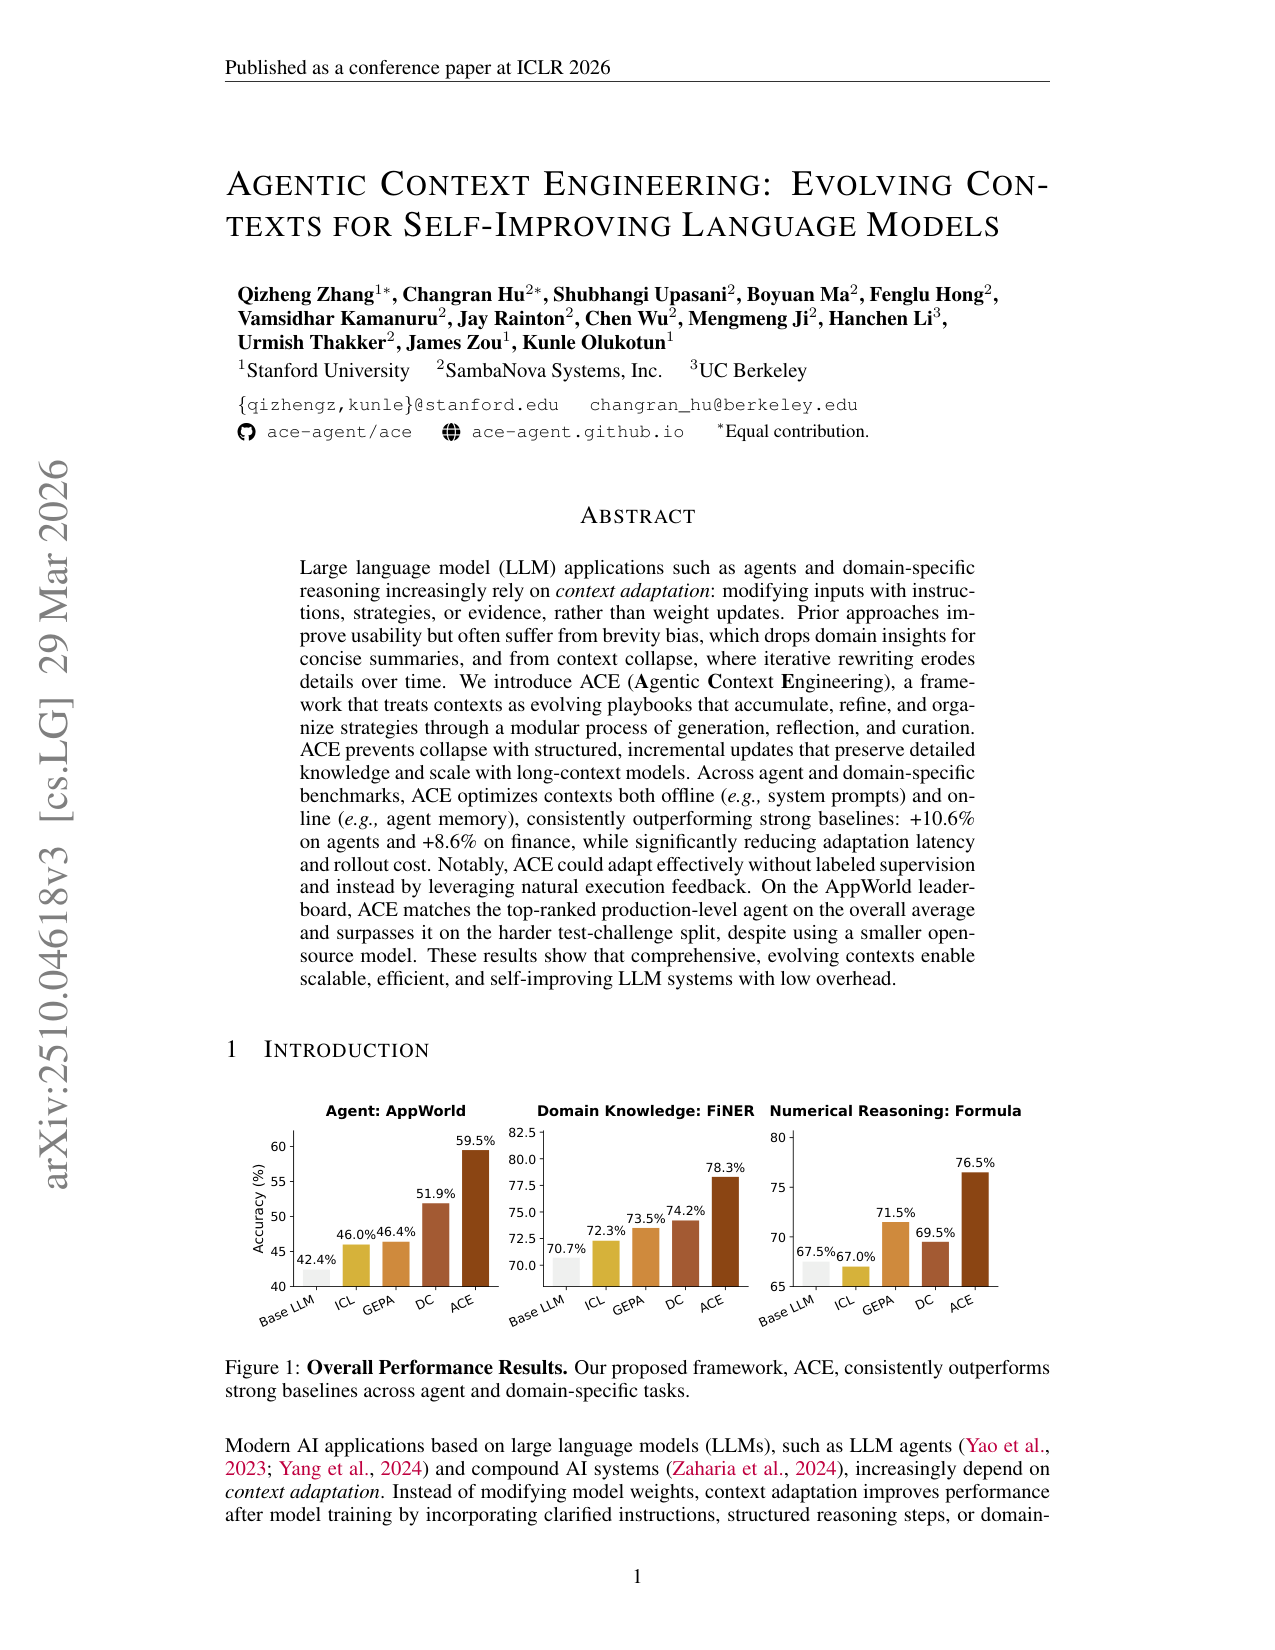
- AppWorld(agent 任务,Fig.1):Base ReAct 42.4% → 59.5%;对照 ICL 46.0%、GEPA 46.4%、DC 51.9%。比 ReAct+ICL 高 12.3 个点、比 ReAct+GEPA 高 11.9 个点。
成本侧同样干净:离线适应延迟 9,517 秒对 GEPA 的 53,898 秒(-82.3%),rollout 数 -75.1%;在线 FiNER 适应延迟 -91.5%、token 成本 $2.9 对 DC 的 $17.7(-83.6%)(Table 4)。playbook 变长也不用怕账单——GPT-5.1 的提示缓存实验里 91.8% 输入 token 命中缓存,计费成本比原始 token 数低 82.6%。
局限:Reflector 是软肋,反馈缺失就退化
1. 强依赖 Reflector:它提炼不出好洞察,上下文就变噪甚至有害(§5 自承);HotPotQA、Game of 24 这类任务不需要丰富上下文,ACE 反而冗余。
2. 无反馈信号时退化:没有 GT、没有执行结果,ACE 和 DC 都会掉点——上下文可能被误导信号污染(Table 2 的 ✗ 行)。
3. 膨胀风险仍在:多轮适应后 playbook 可能到 80K token(MCE 论文的观测),KV 缓存缓解计费,但延迟与显存没有充分评估。
4. 评估偏单基座:主体结果都在 DeepSeek-V3.1-671B 上,医疗与 text-to-SQL 只在附录。
一句话记住这篇
ACE 把上下文工程从「整份重写的 prompt」升级成「条目化、增量、可归因的 playbook」:Generator 产轨迹、Reflector 蒸馏洞察、Curator 打 delta 补丁。最该记住的数字是:AppWorld 42.4% → 59.5%(+17.1 个点),离线适应延迟省 82.3%;最该记住的边界是——反馈质量决定一切,机制仍是手工设计,这正是后来 MCE 要自动化的部分。
把上下文当「进化中的 playbook」:Generator/Reflector/Curator 三组件产出带 identifier 的结构化条目,用增量 delta 更新替代整体重写,治好 brevity bias 与 context collapse;AppWorld 上 ReAct+ACE 59.5% 对 base 42.4%,FiNER +7.6 个点、Formula +9.0 个点,离线适应延迟比 GEPA 省 82.3%。
问题
要解决什么:LLM agent 与领域推理的性能高度依赖上下文(指令、策略、证据),但上下文适应方法有两个通病:brevity bias——优化器把领域洞察压成简短通用摘要丢掉细节;context collapse——整体重写让知识随时间坍缩,AppWorld 案例中 18,282 token/66.7% 的上下文一步塌成 122 token/57.1%,比不用上下文还差(63.7%)。
为什么 prior work 不够:GEPA 等 prompt 优化器把 brevity 当优点,验证指标也偏向短指令;Dynamic Cheatsheet 这类在线记忆靠 LLM 整体重写,积累到一定规模就会把知识瞬间抹掉;两者都没有「结构化、增量、可归因」的上下文维护机制。
进化循环(搜索空间 → 算子 → 评估 → 选择)
搜索空间(什么被进化):上下文 playbook:bullet 条目集合(identifier + 描述 + helpful/harmful 计数器),条目是唯一可编辑表面;生成-反思-策展的 workflow 与更新规则是手工固定的(论文自承:update rules and the overall workflow are still handcrafted)。
变异/提案算子:
- Generator:生成推理轨迹并高亮用到的条目(有用/误导),提供反馈信号
- Reflector:从成功/失败轨迹蒸馏可复用洞察,可多轮迭代提炼
- Curator:把洞察合成紧凑 delta 条目,用确定性非 LLM 逻辑合并进 playbook
- grow-and-refine:新条目追加、旧条目原位更新计数器、语义嵌入去重
评估方式:执行反馈驱动:AppWorld 的代码执行成功/失败、金融任务 GT 标签与公式正确性;无标签时纯靠执行信号。评估基准:AppWorld(TGC/SGC,test-normal/test-challenge)、FiNER、Formula、DDXPlus、BIRD-SQL,按官方协议 pass@1。
选择与归档:条目级计数器跟踪 helpful/harmful 次数;周期或惰性 refine 用语义嵌入去重;无跨代淘汰——靠计数与去重控制膨胀;同一批样本可多 epoch 重访强化(multi-epoch adaptation)。
自我改进程度:L1 边缘:基座模型固定,playbook 内容随执行经验自进化,但三角色机制、条目结构、更新规则全部手工设计;论文明确说机制层仍 handcrafted,这正是 MCE 后续要自动化的部分。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|
输出
| 名称 | 类型 | 说明 |
|---|
数据集
| 数据 | 规模 | 备注 |
|---|
架构(摘要)
主干与结构
backbone:
参数:
类型:
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| AppWorld 平均准确率(agent 任务) | 59.5%(ReAct + ACE) | Base ReAct 42.4%;ICL 46.0%;GEPA 46.4%;DC 51.9% | Fig.1(p1)+ §4.3;AppWorld test 集,DeepSeek-V3.1 基座;相对 ReAct 提升 17.1 个点 |
| 金融领域 FiNER / Formula 准确率 | 78.3%(+7.6)/ 76.5%(+9.0) | base 70.7% / 67.5%;GEPA 73.5% / 71.5% | Fig.1(p1);DeepSeek-V3.1;XBRL 金融推理;平均 +8.6% over 强 baseline(abstract) |
| AppWorld 相对提升 | 比 ReAct+ICL 高 12.3 个点、比 ReAct+GEPA 高 11.9 个点;无 GT 标签时比 ReAct 平均 +14.8% | ReAct+ICL、ReAct+GEPA、ReAct(无标签) | §4.3(p7);在线设置下比 Dynamic Cheatsheet 平均 +7.6% |
| 离线适应延迟与 rollout 数 | 9,517 秒(-82.3%);357 次 rollout(-75.1%) | ReAct+GEPA 53,898 秒 / 1,434 次 | AppWorld,Table 4a(p10);在线 FiNER:5,503 秒 vs DC 65,104 秒(-91.5%),token 成本 $2.9 vs $17.7(-83.6%),Table 4b |
| KV 缓存复用率 | 91.8% 输入 token 命中缓存,计费成本相对原始 token 数 -82.6% | 按原始上下文 token 计费 | OpenAI API 提示缓存实验(GPT-5.1),§4.7(p10)——playbook 变长未必账单变贵 |
| AppWorld 公开榜单位置 | 59.4% 平均,与 top-1 IBM CUGA(60.3%)持平;test-challenge TGC +8.4、SGC +0.7 | IBM CUGA(GPT-4.1 系生产级 agent) | Fig.5(p23)+ §4.3;基座是开源 DeepSeek-V3.1 |
| 金融离线(有 GT)平均 | 81.9%(+12.8) | GEPA 72.5%(+3.4);MIPROv2 70.9%;ICL 69.6% | Table 2(p8),DeepSeek-V3.1-671B;无 GT 时 77.1%(+8.0)仍领先 |
Insights
- 结构化增量更新是抗 collapse 的关键:整体重写把 18K token 压成 122 token 直接掉点,条目级 delta 保留细节——上下文维护要像版本控制,逐条改而不是整份覆写(Fig.2)。
- 条目计数器是显式的 credit assignment:helpful/harmful 统计指导 Reflector 定向修正,比纯文本反思更可归因(§3.1)。
- 长上下文不等于贵:91.8% 输入 token 走 KV 缓存复用,playbook 越厚账单不一定越高(GPT-5.1 缓存实验,§4.7)。
- 反馈质量决定成败:无 GT、无执行信号时 ACE 与 DC 都会退化,上下文可能被误导信号污染(Table 2 ✗ 行 + §5 自承)。
vs 同类工作
- vs GEPA(prompt 优化):GEPA 主动压缩成简短指令,ACE 累积完整领域洞察;AppWorld 高 11.9 个点。
- vs Dynamic Cheatsheet(在线记忆):DC 用累计模式整体重写会 collapse;ACE 的 Curator 做增量 delta + 去重,在线平均高 7.6%,且 FiNER 适应延迟省 91.5%。
- vs MIPROv2:只联合优化指令与示范选择,不动结构;ACE 构造可复用、可解释、可选择性遗忘的 playbook(selective unlearning 是讨论里的延伸)。
局限
- Reflector 依赖:Reflector 提炼不出好洞察时上下文变噪甚至有害(§5 自承);对不需要丰富上下文的任务(HotPotQA、Game of 24)ACE 无优势甚至冗余。
- 反馈信号缺失时退化:无 GT/执行结果时 ACE 与 DC 都掉点(Table 2 的 ✗ 行),上下文污染风险真实存在。
- 上下文膨胀:多 epoch 后 playbook 可达 80K token(MCE 论文观测),KV 缓存缓解计费,但长上下文推理的延迟与内存未充分评估。
- 评估偏单基座:主要结果用 DeepSeek-V3.1-671B,DDXPlus(医疗)与 BIRD-SQL(text-to-SQL)结果在附录,跨模型/跨域泛化证据有限。
可复现性
- code:https://github.com/ace-agent/ace(论文脚注)
- notes:与 DSPy 官方实现的 GEPA/MIPROv2 同环境对比;DC 用官方实现(累计模式);训练/验证/测试划分沿用原始数据集。
ACE 架构:playbook 进化数据流
Mermaid 数据流
flowchart TD
    Q["新问题 Query"] --> G["Generator\n(生成推理轨迹,\n引用 playbook 条目)"]
    G -->|"轨迹 + 条目高亮(有用/误导)"| R["Reflector\n(蒸馏成功/失败洞察,\n可多轮迭代)"]
    R -->|"候选洞察"| C["Curator\n(合成 delta 条目)"]
    C -->|"确定性合并(非 LLM)"| PB["Context Playbook\n(identifier + 描述 + 计数器)"]
    PB -->|"检索最相关条目"| G
    PB -->|"去重(语义嵌入比对)\n周期/惰性 refine"| PB
    G -->|"最终答案"| ANS["Answer"]
    ENV["执行环境\n(代码执行成功/失败、\nGT 标签、公式正确性)"] -->|"反馈信号"| R
    ENV -->|"执行结果"| G
组件详解
- Generator(生成器):解决查询并产出推理轨迹,同时标记本次用到的 playbook 条目哪些有效、哪些误导。轨迹质量直接决定 Reflector 能提炼什么,所以执行反馈(代码是否跑通、答案是否正确)是它的主要输入。
设计要点
1. 局部化更新:整体重写是「全文替换」,delta 更新是「逐条补丁」——后者避免 context collapse(18,282→122 token 的断崖案例)。
2. 显式 credit assignment:计数器记录每条目被标记为 helpful/harmful 的次数,让条目质量可归因、可清理。
3. 成本特征:适应阶段延迟/rollout 大幅下降(GEPA 对照 -82.3%);推理阶段靠 KV 缓存复用摊薄长 playbook 的计费成本(91.8% 命中率、-82.6% 计费)。
4. 可选择性遗忘:上下文条目化让「删掉某条知识」变成一次原子操作,论文在讨论里把它和隐私/合规的 selective unlearning 挂钩。
ACE 在 agent 与领域任务上全面超过强 baseline
原文 caption:Overall Performance Results. Our proposed framework, ACE, consistently outperforms strong baselines across agent and domain-specific tasks.
支撑「全面领先」论断:AppWorld 上 ACE 59.5% 对 base 42.4%、GEPA 46.4%、DC 51.9%;FiNER 78.3 对 base 70.7;Formula 76.5 对 base 67.5。读法:看每组柱状图里 ACE 的领先幅度,以及它在 agent(左)与领域任务(中右)上的一致性。为什么重要:一张图给出全文收益的全貌——结构化、进化式的上下文优于固定示例、单指令优化和整体重写记忆。
ACE 框架:Generator → Reflector → Curator
原文 caption:The ACE Framework. Inspired by Dynamic Cheatsheet, ACE adopts an agentic architecture with three specialized components: a Generator, a Reflector, and a Curator.
展示机制:Generator 产轨迹、Reflector 蒸馏洞察、Curator 输出 delta 条目并确定性合并进 playbook。读法:看「迭代精炼」回路与「delta 条目」箭头——更新是局部的、条目化的,这直接对应抗 collapse 的设计。为什么重要:它解释了 ACE 凭什么避免整体重写的坍缩,是机制层的核心证据。
Context Collapse:整体重写把知识瞬间抹掉
原文 caption:Context Collapse. Monolithic rewriting of context by an LLM can collapse it into shorter, less informative summaries, leading to sharp performance drops.
证明「整体重写会坍缩」:AppWorld 上第 60 步上下文 18,282 token、准确率 66.7%,下一步塌成 122 token、准确率 57.1%,低于无上下文 baseline 63.7%。读法:看 token 数与准确率同时断崖。为什么重要:它把 ACE 要解决的病根可视化——长上下文一旦被整体重写,积累的知识可以瞬间清零,这是设计增量更新的直接动机。
AppWorld 榜单:59.4% 与 top-1 生产级 agent 持平
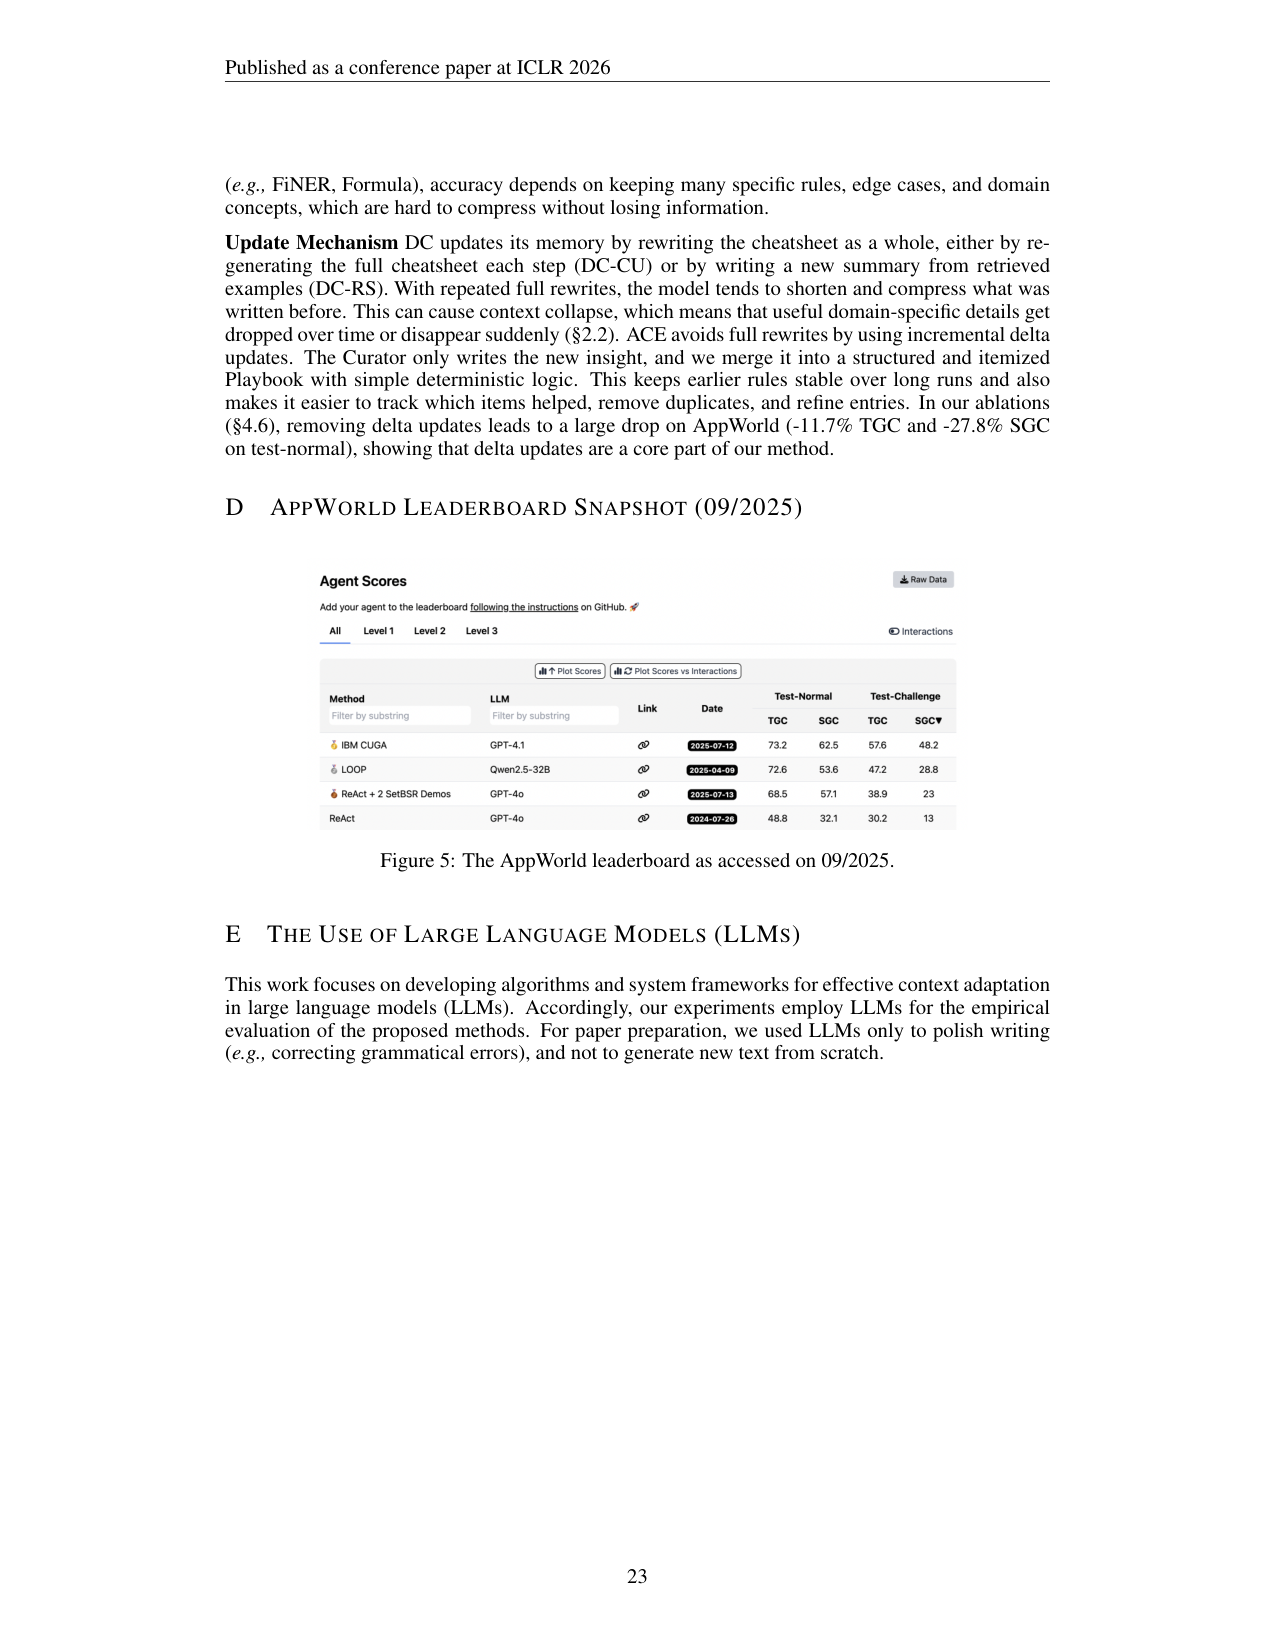
原文 caption:The AppWorld leaderboard as accessed on 09/2025.
支撑「开源小模型追平生产级 agent」:ReAct+ACE(DeepSeek-V3.1)59.4% 平均与榜首 IBM CUGA(GPT-4.1 系,60.3%)同一量级,并在 test-challenge 的 TGC/SGC 上反超 8.4/0.7 个点。读法:看 ACE 条在榜单中的位置与它背后的模型规模。为什么重要:它把实验室收益换算成真实竞争场景的位置——上下文工程让开源模型逼近前沿闭源 agent。
上下文该像一本会进化的笔记,还是越写越短的小抄?(对话版)
小播:今天聊一篇 ICLR 2026 的论文,讲的是怎么给 LLM 写「上下文」——就是每次提问塞给它的那堆指令和资料。
老播:这篇叫 ACE,Agentic Context Engineering。一句话结论:上下文应该像一本会进化的笔记本,条目化地增删,让它自己越用越懂你的任务——而当前主流做法是把整份上下文反复重写,越写越短,最后把知识丢掉。
小播:等等,「越写越短」不是好事吗?短不是更省 token?
老播:问题就在这。论文里有个特别直观的例子:在 AppWorld 这个 agent 基准上,一份上下文已经长到 18282 个 token,准确率 66.7%;下一步被整体重写,一下缩成 122 个 token,准确率掉到 57.1%——比完全不用上下文还低,不用是 63.7%。
小播:也就是说,压缩把之前积累的领域知识全抹掉了?
老播:对,这就是论文说的 context collapse。还有个反面毛病叫 brevity bias:优化器偏爱短指令,把该有的细节压成「写有效的测试」这种正确但没用的话。agent 任务恰恰吃细节,越压越差。
机制:三个角色分工
小播:那 ACE 怎么治?
老播:它把上下文组织成一条一条的结构化条目,每条有唯一编号、描述,还有「被标记有用/有害几次」的计数器。维护工作分给三个专职角色。
小播:哪三个?
老播:Generator,负责解问题、生成推理轨迹,同时标记这次哪些条目有用、哪些误导。Reflector,负责从成功和失败的轨迹里提炼可复用的经验。Curator,负责把经验合成一条条小的「增量补丁」,用确定性的规则合并回笔记本里。
小播:为什么合并要用确定性规则,不用 LLM?
老播:这是它的关键设计。用 LLM 整份重写才会 collapse;逐条打补丁,加新条目、改旧条目的计数器、按相似度去重,每一步都可预测、可审计。更新是局部的,知识只增不减。
小播:那和 Dynamic Cheatsheet 这类在线记忆有什么区别?
老播:DC 是整体重写,会坍缩;ACE 是增量更新,还多了去重和计数器。在线设置下 ACE 平均比 DC 高 7.6 个点,FiNER 上的适应延迟省了 91.5%。
数字:全面领先
小播:给点硬数字。
老播:AppWorld 上,基础 ReAct 是 42.4%,加上 ACE 到 59.5%。对照一下:固定示例的 ICL 是 46.0%,prompt 优化器 GEPA 是 46.4%,在线记忆 DC 是 51.9%。金融领域,FiNER 从 70.7 到 78.3,Formula 从 67.5 到 76.5。
小播:有没有更真实的场景?
老播:有。AppWorld 有公开榜单,ACE 用开源的 DeepSeek-V3.1 做到 59.4% 平均,和榜首 IBM CUGA 的 60.3% 持平——而 CUGA 是 GPT-4.1 系的生产级 agent。在更难的 test-challenge 分割上,TGC 还反超 8.4 个点。
小播:开源模型追平闭源生产级 agent?这是上下文工程的功劳?
老播:对,记住这个记忆锚点:它没换模型、没调权重,只靠让上下文自己进化。而且它不需要人工标注——纯靠代码执行成功还是失败这个信号,AppWorld 上就比 ReAct 平均高 14.8%。
成本:又快又省
小播:这么厚的上下文,成本会不会爆炸?
老播:分两段看。适应阶段:离线延迟 9517 秒对 GEPA 的 53898 秒,省 82.3%,rollout 数省 75.1%。推理阶段:playbook 是长,但现代服务有 KV 缓存复用——用 GPT-5.1 做提示缓存实验,91.8% 的输入 token 直接命中缓存,计费成本比原始 token 数低 82.6%。
小播:也就是说,上下文厚不一定会变贵?
老播:对,再记住一个记忆锚点:条目化加确定性合并是 ACE 的护城河——逐条打补丁、计数器记功过,知识只增不减,这就是它不 collapse 的原因。
老播:对,只要缓存命中率高。这是它敢把上下文越养越厚的经济学前提。
泼冷水:Reflector 是软肋
小播:它有什么短板?
老播:三个。第一,它强依赖 Reflector 的提炼能力——提炼不出好经验,上下文就会变噪甚至有害,论文自己在讨论里承认了。第二,没有反馈信号就退化:没有标准答案、没有执行结果的时候,ACE 和 DC 都会掉点,上下文可能被误导信息污染。
小播:第三?
老播:不是所有任务都需要厚上下文。HotPotQA 这类检索问答,Game of 24 这种固定策略游戏,短指令就够,ACE 反而冗余。还有膨胀风险:多轮适应后 playbook 能长到 8 万 token,缓存缓解计费,但延迟和显存压力没有充分评估。
小播:还有个点,它的机制本身是手工设计的吧?
老播:对,这一点很重要:Generator、Reflector、Curator 的分工、条目的结构、更新规则,全是人写的。内容在进化,机制没有。这篇论文自己也承认——这正是后来 MCE 那篇要解决的事:连「怎么管上下文」这个机制一起进化。
收尾
小播:最后用一句话总结?
老播:ACE 把上下文工程从「整份重写」升级成「条目化、增量、可归因的 playbook」:生成器产轨迹、反思器提炼经验、策展员打补丁。最该记住的数字是:AppWorld 从 42.4% 提到 59.5%,离线适应延迟省 82.3%。
小播:而最该记住的边界是:反馈质量决定一切,机制仍是手工设计。
老播:没错。这篇是「上下文工程」这条线的代表工作,读它之前先记住那个 18282 变 122 的坍缩例子——那就是它要治的病。