ThetaEvolve:单个 8B 模型 + RL,刷新 AlphaEvolve 的开放问题上界
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。
先看一个现象:AlphaEvolve 刷新数学开放问题上界,靠的是 Gemini 2.0 这类前沿模型的集成,而且它是闭源的、纯推理的——进化出来的策略只活在程序里,模型权重一点没学到。微软和 UW 的这篇 ThetaEvolve 做了两件事:把 AlphaEvolve 简化成单个开源 8B 模型 + 大规模程序数据库的可扩展系统,然后给这个系统装上 test-time RL,让模型在测试时真的「学会怎么进化」。
背景:把进化搜索从「集成堆料」变成「开源单模型」
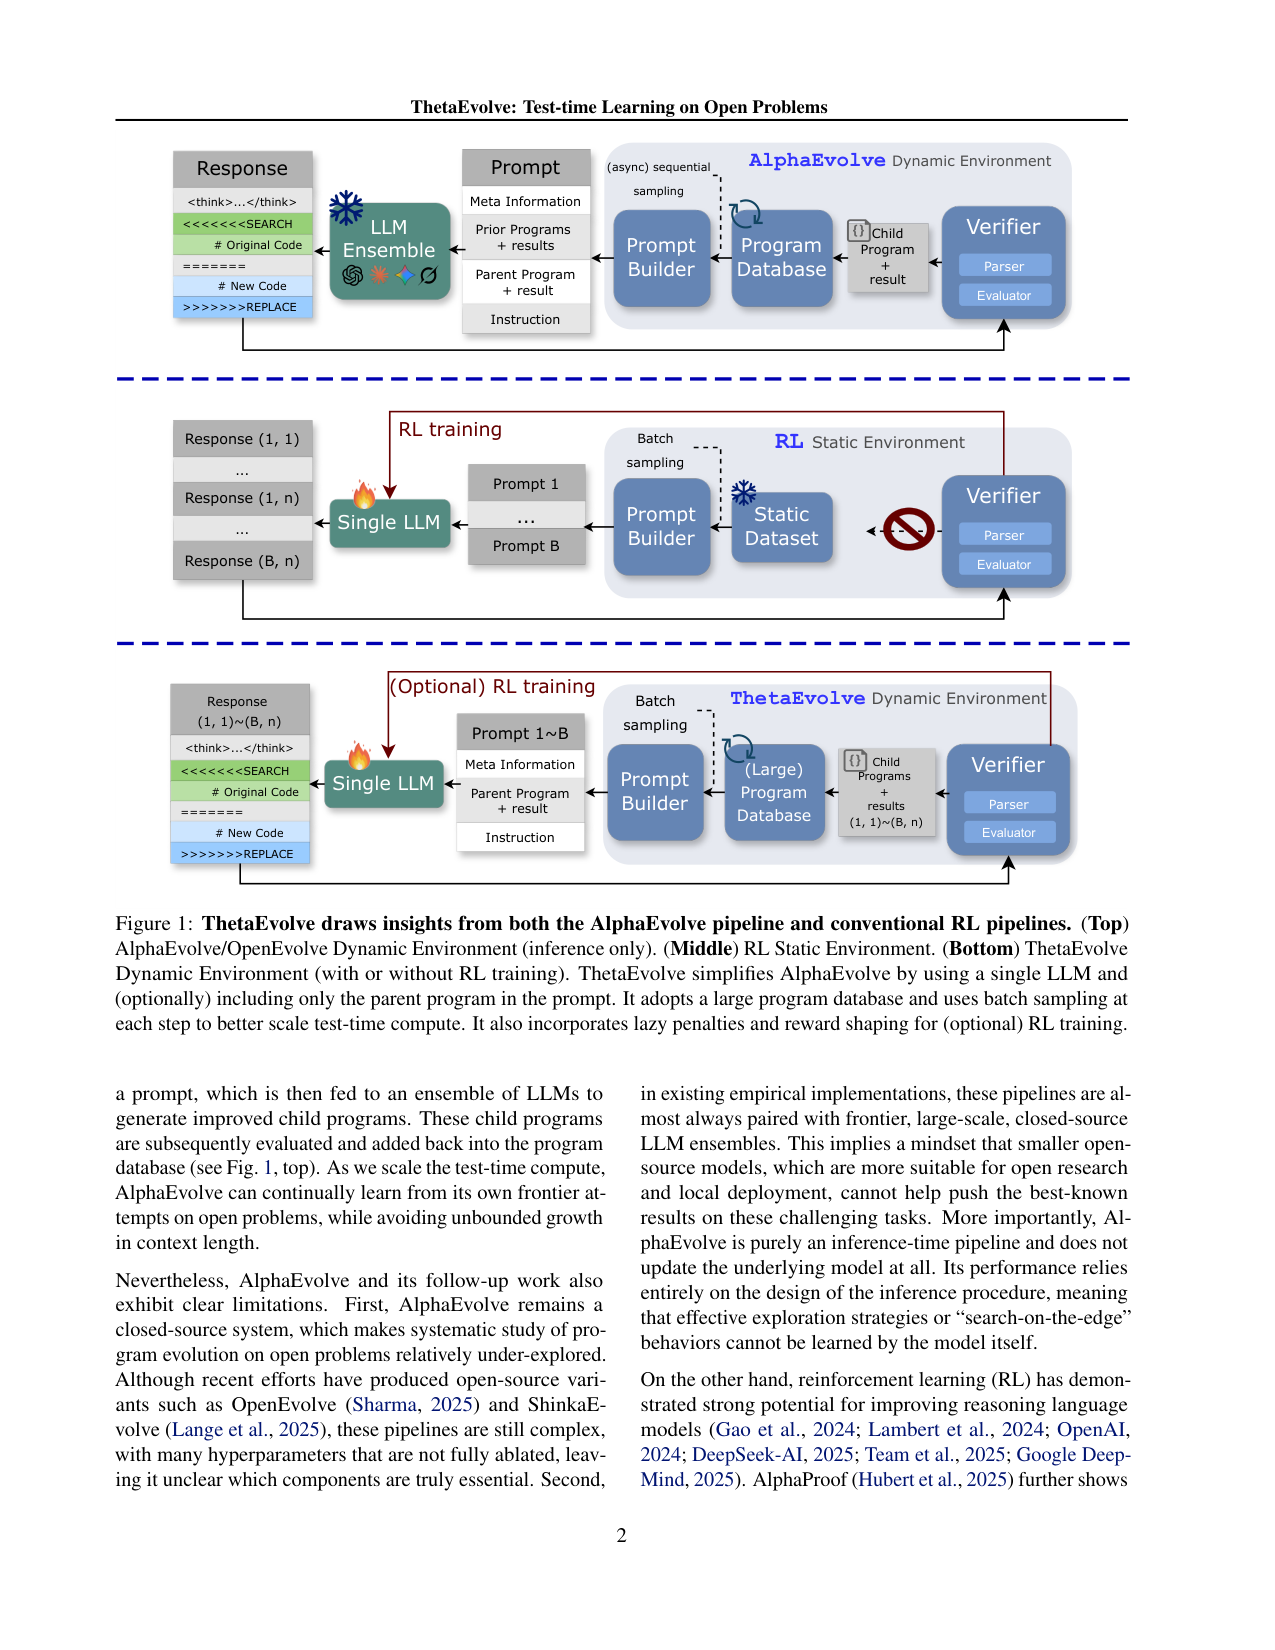
AlphaEvolve 的管线四件套:prompt builder 从数据库采样 parent 和历史程序、LLM 集成生成 SEARCH/REPLACE diff、验证器评估、结果入库。ThetaEvolve 的改动逐条对照:集成换成单 LLM;数据库 population 从 70(OpenEvolve)放大到 10000;单响应换成批量采样——每步取 B 个 parent、每个生成 n 个响应,一次产出 B×n 个 child,吃满 vLLM/SGLang 的批推理;再加一个 lazy penalty,禁止模型重复输出数据库里已有的程序。这些改动的目标很明确:把 test-time compute 变成可扩展的资源。
核心机制:两条公式管住 RL 训练
纯推理时,评估器的分就是 fitness;但 RL 训练时,模型会学「作弊」——既然最优程序已经在数据库里,直接复读它就能拿高分。ThetaEvolve 用分段打分挡住这条路:
$$s(p_p, r) = \begin{cases} -0.4 & \text{响应里没有 diff 块} \\ -0.3 & \text{改动无效(} c_p \equiv p_p\text{)} \\ -0.2 & \text{没有解(编译/运行/超时)} \\ -0.1 & \text{解非法(验证器不过)} \\ E(c_p) & \text{正常评估} \end{cases}$$
$p_p$ 是 parent 程序,$r$ 是 LLM 响应,$c_p$ 是应用 diff 后的 child,$E$ 是评估器。关键在第二行和额外的「重复惩罚」:凡是和数据库里已有程序等价的 child 一律罚,逼模型持续尝试真实改进,复读最优不会得分。
第二个机制是 reward shaping。有些任务的分数区间很窄(比如 0.90–0.96),原始分区分度不够,RL 学不动:
$$R(s) = k \cdot F(s), \quad F(s) = \big(\text{clip}(H(s),\, 0,\, 1)\big)^{\alpha}$$
$s$ 是原始分,$H$ 把分数映射到 [0,1] 区间,$\alpha$ 控制高分处的奖励斜率(越大越激进),$k=3$ 是缩放因子。目的:让「接近已知最优时的微小改进」也能产生稳定的训练信号。
关键结果:8B 模型首次刷新两个开放问题上界
全部带 baseline 和 setup。CirclePacking(26 圆、半径和):ThetaEvolve 用 DeepSeek-R1-0528-Qwen3-8B 拿到 2.63598308,AlphaEvolve 用 Gemini-2.0-Flash/Pro 集成是 2.63586276,ShinkaEvolve 用 6 模型集成是 2.63598283;而且 ThetaEvolve 发现的程序找解只要约 3 秒,ShinkaEvolve 的约 75 秒。FACI(第一自相关不等式):1.503133 vs AlphaEvolve 1.503164。RL 对照(Table 2):CirclePacking-T 上 w/RL best 2.6359857 vs w/o RL 同期 2.6359831;ThirdAutoCorrIneq 从初始 3.1586 到 w/RL 1.4930 vs w/o RL 1.5084;HadamardMatrix N=29 从 0.1433 到 w/RL 0.5764 vs w/o RL 0.5733。
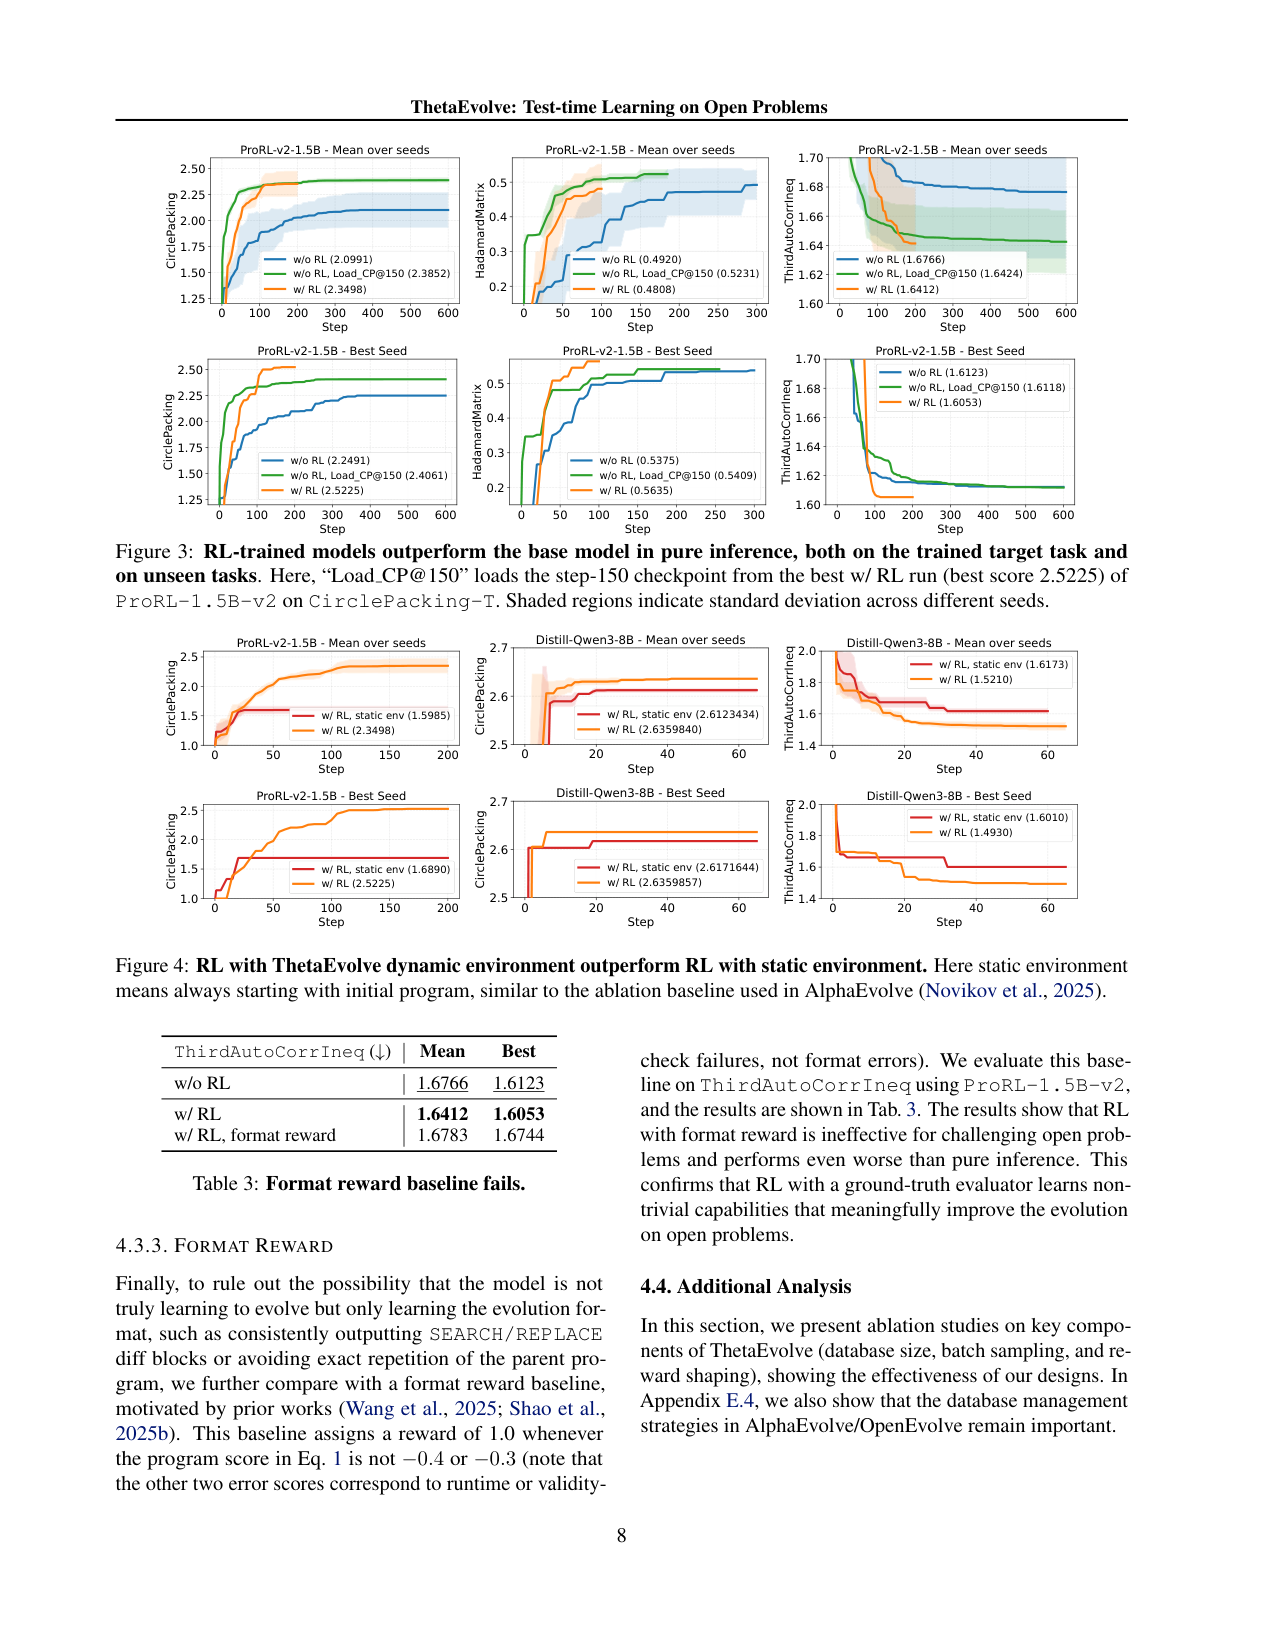
「模型真的学会进化了吗」:把 RL 训练到第 150 步的 checkpoint 拿出来做纯推理,比从头纯推理爬得更快、落点更高(Fig.3),而且这份能力迁移到未见任务——CirclePacking 上训练的 checkpoint 在另外三个任务上全面超过基座。对照组说明动态环境是必要的:静态环境(数据库不更新)下 RL 连纯推理都打不过(Fig.4)。
还有个值得展开的设计细节:数据库重排。每批 B×n 个 child 插入时顺序执行并重排,作者说开销与系统其它环节相比可忽略;但 population 10000 意味着「保留什么、删什么」的排序规则直接决定搜索走向——按客观分与多样性双指标排序,是 AlphaEvolve 数据库思路的简化版,论文对它做了规模消融(§4.4.1:放大数据库改善最终性能)但没有深挖排序准则本身。
RL 与纯推理的公平性也要记一笔:作者明确不做 dynamic sampling,让 RL 与推理消耗的样本数严格可比;训练用 3 个随机种子取均值与 best,但推理侧(w/o RL)的多 seed 统计没有同等报告,读表时把均值与 best 的差距当成方差提示。
局限:评估口径与调参依赖
四条。第一,评估口径差异要盯紧:CirclePacking 用 OpenEvolve 的 1e-6 容差(和 AlphaEvolve 严格验证是不同任务),ThirdAutoCorrIneq 修正了 AlphaEvolve 评估器的 typo,跨论文数字对照必须按同一验证器口径。第二,RL 的稳定性靠手工调参:asymmetric clipping、reward shaping 的 U/L/α/k 都是人为指定,没有敏感性分析。第三,数学上界接近已知最优,小改进完全依赖评估器正确性——作者对前作评估器 typo 的修正本身就说明了这个风险。第四,单 LLM 替换集成缺少机制解释:前作集成贡献的多样性,在这里为何不需要,论文没有展开。
一句话记住这篇
ThetaEvolve 把 AlphaEvolve 变成开源、单模型、可扩展的 test-time 学习系统:10000 规模的数据库管住搜索空间,批量采样管住吞吐,lazy penalty 管住 RL 作弊。最该记住的数字:单个 8B 模型把 circle packing 上界刷到 2.63598308,对照 AlphaEvolve 前沿集成的 2.63586276;最该记住的口径:跨论文比数字前,先确认验证器是不是同一个。
用单个开源 8B 模型(DeepSeek-R1-0528-Qwen3-8B)加大规模程序数据库(population 10000)把 AlphaEvolve 简化成可扩展的 test-time 学习系统,并首次让 8B 模型刷新 AlphaEvolve 列出的两个开放问题上界(circle packing 2.63598308 vs AlphaEvolve 2.63586276;FACI 1.503133 vs 1.503164),RL 训练的 checkpoint 还学到了可迁移的「进化能力」。
问题
要解决什么:把 AlphaEvolve 的进化搜索从「闭源、依赖 frontier LLM 集成、纯推理」改造为开源、单模型、可扩展 test-time compute 的系统,并支持用 RL 让模型在测试时持续学习。
为什么 prior work 不够:AlphaEvolve 需要多个前沿大模型集成才出新上界,纯推理系统无法把进化中学到的策略内化到模型权重;OpenEvolve 等开源实现的数据库规模小(70)、吞吐低,无法支撑大规模 test-time compute。
进化循环(搜索空间 → 算子 → 评估 → 选择)
搜索空间(什么被进化):程序代码:每步从数据库采样 B 个 parent,各生成 n 个 SEARCH/REPLACE diff 响应,得到 B×n 个 child 程序;数据库 population size 10000(对照 OpenEvolve 70)。权重层面对纯推理冻结,RL 模式下模型权重在训练轨迹中更新。
变异/提案算子:
- 单 LLM(不用集成):简化自 AlphaEvolve 的 prompt builder + parser
- 批量采样:B 个 parent × n 个响应并行生成,适配 vLLM/SGLang 批推理
- 可选迭代精炼:只采样 parent、不带 prior programs,缩短 prompt
- early checks + lazy penalty:无 diff(-0.4)、无有效改动(-0.3)、无解(-0.2)、非法解(-0.1),重复数据库已有程序也罚,防「懒惰输出」
评估方式:任务特定验证器:CirclePacking-T 用 OpenEvolve 1e-6 容差(严格版 CirclePacking 另算);First/Second/Third AutoCorrIneq 用构造函数求值(Third 修正了 AlphaEvolve 评估器 typo,跨论文数字不可直接比);HadamardMatrix(N=29)最大化行列式。RL 用 GRPO + asymmetric clipping(low 0.2/high 0.28,lr 1e-6),可选 reward shaping(k=3)。论文未给出:早期检查各惩罚分值的敏感性。
选择与归档:数据库按客观分与多样性排序、满员则删除;插入按顺序执行并重排(作者称开销可忽略)。RL 训练 3 个随机种子(42/1234/3407),每步对应 512 个新程序;不做动态采样以公平对比纯推理。
自我改进程度:L1 到 L2 的过渡:主进化循环只改程序、权重冻结(L1);但 test-time RL 会更新模型权重,且 RL 训练的 checkpoint 学到的进化策略能迁移到未见任务(接近 L2)。如实标注:权重更新发生在 RL 训练轨迹中,主循环本身不进化自身机制。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|
输出
| 名称 | 类型 | 说明 |
|---|
数据集
| 数据 | 规模 | 备注 |
|---|
架构(摘要)
主干与结构
backbone:
参数:
类型:
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| CirclePacking 半径和(越大越好) | 2.63598308(ThetaEvolve / Distill-Qwen3-8B) | AlphaEvolve(Gemini-2.0-Flash/Pro 集成)2.63586276;ShinkaEvolve(6 模型集成)2.63598283 | 开放任务;ThetaEvolve 用 OpenEvolve 容差评估 + 事后收半径到严格版;Table 1(§1) |
| First AutoCorrIneq 上界(越小越好) | 1.503133 | AlphaEvolve 1.503164;此前人类上界 1.5098 | 第一自相关不等式构造;Distill-Qwen3-8B;Table 1(§1) |
| CirclePacking-T(w/RL vs w/o RL,Distill-Qwen3-8B) | w/RL best 2.6359857;w/o RL 同期 2.6359831 | 初始程序 0.9598;AlphaEvolve best 2.63586276 | 65 个训练步(每步 512 个新程序)、3 seeds;Table 2(§4.2) |
| ThirdAutoCorrIneq(越小越好,Distill-Qwen3-8B) | w/RL best 1.4930;w/o RL 1.5084 | 初始程序 3.1586 | 评估器修正 AlphaEvolve typo 后使用,跨论文数字不可直接比;Table 2(§4.2) |
| HadamardMatrix N=29 行列式(越大越好) | w/RL best 0.5764;w/o RL 0.5733 | 初始程序 0.1433 | 29 阶 Hadamard 矩阵行列式最大化;Distill-Qwen3-8B;Table 2(§4.2) |
| RL checkpoint 迁移(未见任务) | CirclePacking-T 上 RL 训练的 checkpoint 在 Second/Third AutoCorrIneq 与 Hadamard 上显著优于基座模型纯推理 | 未训练基座模型;静态环境 RL | ProRL-1.5B-v2 与 Distill-Qwen3-8B;图 3 中/右(§4.3) |
| 静态环境 RL 对照 | 静态环境 RL 差于纯推理基线 | ThetaEvolve 纯推理与 w/RL | 始终从初始程序起步、数据库不更新的 GRPO;Figure 4(§4.3.2) |
Insights
- 计算规模可以替代模型规模:单个开源 8B 模型 + 10000 规模数据库刷新了需要前沿模型集成的上界。
- 数据库规模是 test-time compute 的杠杆:population 10000 vs OpenEvolve 70 直接改善最终性能(§4.4.1)。
- lazy penalty 是 RL 稳定训练的关键:禁止重复输出已有强程序,逼模型持续尝试改进而非复读最优。
- RL 学到的进化能力可迁移:CP 上训练的 checkpoint 在未见任务上爬得更快、落点更高。
- 动态环境(数据库持续更新)是 RL 有效的必要条件:静态环境 RL 连纯推理都打不过,因为开放问题的最终解无法从初始程序直接采样。
vs 同类工作
- 相
- 比
- A
- l
- p
- h
- a
- E
- v
- o
- l
- v
- e
- /
- A
- l
- p
- h
- a
- E
- v
- o
- l
- v
- e
- -
- v
- 2
- (
- 闭
- 源
- 、
- L
- L
- M
- 集
- 成
- 、
- 纯
- 推
- 理
- )
- ,
- T
- h
- e
- t
- a
- E
- v
- o
- l
- v
- e
- 开
- 源
- 、
- 单
- 模
- 型
- 、
- 可
- 批
- 量
- 采
- 样
- ,
- 并
- 首
- 次
- 引
- 入
- t
- e
- s
- t
- -
- t
- i
- m
- e
- R
- L
- ;
- 相
- 比
- S
- h
- i
- n
- k
- a
- E
- v
- o
- l
- v
- e
- (
- 同
- 样
- 开
- 源
- 但
- 仍
- 是
- 纯
- 推
- 理
- 、
- 6
- 模
- 型
- 集
- 成
- )
- ,
- T
- h
- e
- t
- a
- E
- v
- o
- l
- v
- e
- 证
- 明
- 单
- 8
- B
- 模
- 型
- +
- R
- L
- 能
- 达
- 到
- 或
- 超
- 过
- 其
- c
- i
- r
- c
- l
- e
- p
- a
- c
- k
- i
- n
- g
- 上
- 界
- ,
- 且
- 发
- 现
- 的
- 程
- 序
- 求
- 解
- 只
- 需
- 约
- 3
- 秒
- (
- S
- h
- i
- n
- k
- a
- E
- v
- o
- l
- v
- e
- 约
- 7
- 5
- 秒
- )
- 。
局限
- 评估设置差异影响跨论文对比:CirclePacking 用 OpenEvolve 1e-6 容差(与 AlphaEvolve 严格验证是不同任务),ThirdAutoCorrIneq 修正了评估器 typo 后结果不可直接比——作者在论文里明确标注,读者引用时要按同一验证器口径。
- RL 训练依赖手工调参:asymmetric clipping 系数、reward shaping 的 U/L/α/k 均为人为指定,论文未做敏感性分析。
- 验证实验规模有限:两个模型(1.5B/8B)、四个任务、每步 512 个新程序;大规模下数据库 10000 的重排/检索成本只声明 negligible,未做压力分析。
- 数学上界改善幅度小(接近已知最优),小改进的成立完全依赖评估器正确性;评估器出 bug 会直接污染结论(作者对 AlphaEvolve 评估器 typo 的修正本身也说明这一点)。
- 单 LLM 替换集成:论文声称简化可行,但没有解释前作中集成贡献多样性的机制为何在这里不需要。
- 3 seeds 的 RL 主实验方差仍存在(均值与 best 差距可见),且未报告推理侧(w/o RL)的多 seed 统计。
可复现性
代码开源(github.com/ypwang61/ThetaEvolve);给出任务描述与验证器(附录 A)、meta-info 与 prompt 模板(附录 B.3)、超参数表(附录 B.2)、RL 配置与 3 个随机种子(§4.1);CirclePacking-T 与严格版 CirclePacking 的评估口径分开说明。
ThetaEvolve 架构:批量进化 + test-time RL 的数据流
flowchart TD
    A["程序数据库(population 10000,按分数与多样性排序)"] --> B["批量采样:B 个 parent"]
    B --> C["prompt builder:meta-info + parent + 结果(可选迭代精炼)"]
    C --> D["单 LLM:每 parent 生成 n 个响应(B×n 个 child)"]
    D --> E["parser:提取 SEARCH/REPLACE diff 并应用"]
    E --> F["early checks + lazy penalty 打分"]
    F --> G["验证器评估:E(cp),任务特定"]
    G --> H["插入数据库(顺序执行 + 重排)"]
    H --> A
    F --> I{"RL 模式?"}
    I -- 是 --> J["reward shaping R(s) = k·F(s)"]
    J --> K["GRPO 更新模型权重(checkpoint)"]
    K --> D
    I -- 否 --> L["纯推理:循环到预算耗尽"]
    L --> M["输出:数据库中最优程序"]
组件详解
程序数据库:进化的记忆体,规模 10000,是 OpenEvolve(70)的 140 倍。新程序插入时按「客观分 + 多样性」双指标排序、满员删除;采样 parent 供变异。作者对规模做了消融——放大数据库直接改善最终性能,这是 test-time compute 的杠杆之一。
批量采样与单 LLM:每步独立采样 B 个 parent、各生成 n 个响应,一次产出 B×n 个候选,专门适配 vLLM/SGLang 的批推理引擎。单 LLM 替换 AlphaEvolve 的集成,作者断言简化可行但未解释集成多样性的机制为何不再需要。
Early checks 与 lazy penalty:在调用昂贵验证器之前,先用规则过滤——无 diff 块(-0.4)、改动无效(-0.3)、无解(-0.2)、解非法(-0.1);任何与数据库已有程序等价的 child 额外受罚。这条防的是 RL 的「复读最优」作弊路径,是训练稳定性的关键。
验证器:任务特定的自动评估器,是系统里唯一真值来源。CirclePacking-T 用 1e-6 容差,严格版 CirclePacking 另算;ThirdAutoCorrIneq 修正了 AlphaEvolve 评估器的 typo。评估器正确性直接决定结论有效性。
RL 回路:GRPO + asymmetric clipping(low 0.2 / high 0.28)+ 可选 reward shaping,训练 3 个随机种子。权重更新让模型「学会进化」——RL checkpoint 做纯推理仍显著优于基座,且该能力迁移到未见任务。动态环境(数据库持续更新)被证明是必要的:静态环境 RL 差于纯推理。
输出:预算耗尽后取数据库最优程序;RL 模式下还交付一个学会了进化策略的模型 checkpoint。
与 AlphaEvolve 的三处简化对照:第一,集成 → 单模型,推理吞吐瓶颈从模型池转移到批引擎;第二,单响应 → B×n 批量,把 test-time compute 变成可线性扩展的资源;第三,数据库 70 → 10000,搜索空间记忆量级不同。这三处简化不是免费的——集成提供的多样性、小数据库隐含的强选择压力都被去掉,论文用「8B 单模型刷新上界」证明净收益为正,但没有逐项归因。
评估器口径的工程含义:CirclePacking-T(1e-6 容差)与 AlphaEvolve 严格版是不同优化问题;论文事后把半径整体收缩 1e-6 回到严格版并证明仍优于 AlphaEvolve。读架构图时记住:数据库、验证器、RL 奖励三者的口径必须一致,跨论文对比先对齐验证器。
AlphaEvolve 管线(上)与 ThetaEvolve 批量采样 + RL(下)对比
原文 caption:AlphaEvolve Dynamic Environment vs ThetaEvolve: batch sampling of B parent programs with n responses each, single LLM, large program database, and optional RL training loop. (caption 精简自原文)
架构差异一目了然:上面是 AlphaEvolve 的异步单响应循环(LLM 集成 + 小数据库),下面是 ThetaEvolve 的批量采样(B×n 响应)与 RL 反馈回路(reward → 权重更新 → 采样分布改变)。读图重点看数据库规模标注与 RL 那条回路——「test-time learning」就落在这条回路上。
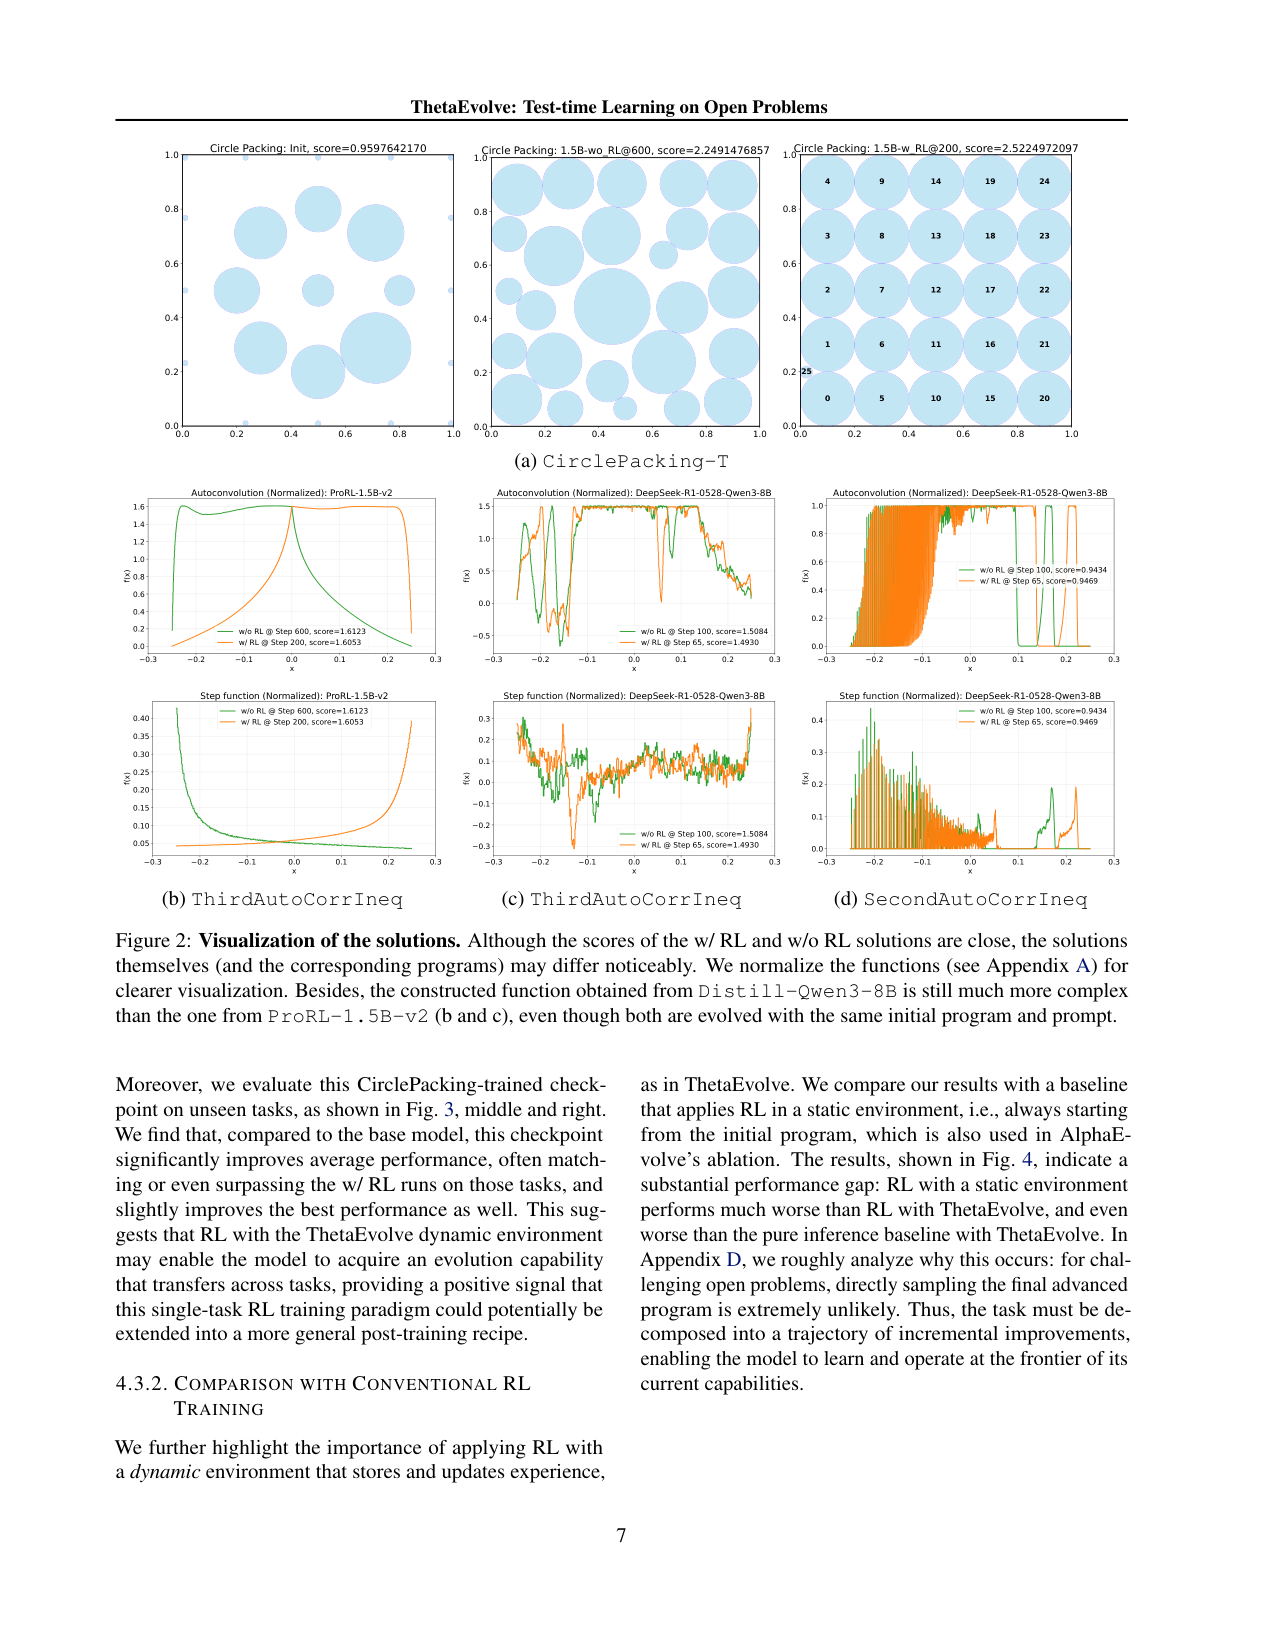
进化出的函数解可视化:w/RL 与 w/o RL 结构差异
原文 caption:Visualization of the solutions. Although the scores of the w/ RL and w/o RL solutions are close, the solutions themselves (and the corresponding programs) may differ noticeably. (caption 精简自原文)
支撑「分数接近但结构不同」的判断:同一任务(Third/Second AutoCorrIneq)下,w/RL 与 w/o RL 构造的函数在形态上明显不同;8B 模型构造的函数比 1.5B 复杂得多。读法:对比每个任务的左右两栏曲线,别只看分数——它说明接近最优上界后,小分数差对应的是搜索空间的实质性差异。
RL 训练曲线:模型是否真的学会进化
原文 caption:Training curve of ProRL-1.5B-v2 on CirclePacking-T. 'Load CP@150' loads the step-150 checkpoint from the best w/ RL run and performs pure inference. (caption 精简自原文)
回答「RL 是否更新了有用的权重」:加载 RL 训练到第 150 步的 checkpoint 做纯推理(Load CP@150),曲线比 w/o RL 爬得更快、最终分更高——说明模型参数里真的沉淀了进化策略,而随机初始化的纯推理没有这份积累。读法:比较三条曲线在相同程序数处的纵坐标。
单个 8B 开源模型,刷新了需要前沿模型集成的数学上界(对话版)
小播:今天聊微软和 UW 的 ThetaEvolve。一句话先给结论:AlphaEvolve 当年刷新数学开放问题上界,靠的是 Gemini 2.0 这类前沿模型的集成;这篇用一个开源的 8B 模型,把同样的任务跑出了更优的结果,还给系统装上了 test-time 强化学习,让模型在测试时真的学会「怎么进化」。
老播:数字是这样的:26 圆 circle packing,半径和,ThetaEvolve 用 DeepSeek-R1 蒸馏版的 Qwen3 8B 拿到 2.63598308,AlphaEvolve 用 Gemini 集成是 2.63586276,ShinkaEvolve 用六个前沿模型集成是 2.63598283。8B 对集成,赢了。
小播:先记第一个记忆锚点:计算规模可以替代模型规模——数据库和推理吞吐堆起来,单模型也能刷新上界。
第一段:它要解决什么问题
老播:背景是 AlphaEvolve 那套进化管线:程序数据库存历史程序,prompt builder 采样父程序,LLM 生成代码修改的 diff,验证器评估,结果入库。AlphaEvolve 有两个问题:闭源、纯推理。纯推理的意思是进化出来的策略只活在程序里,模型权重一点没学到。
小播:所以 ThetaEvolve 的改动方向就两条:开源可复现,加上 test-time 学习。
老播:对,四条具体改动。第一,集成换单 LLM。第二,数据库规模从 OpenEvolve 的 70 放大到 10000。第三,单响应换批量采样——每步取 B 个父程序、每个生成 n 个响应,一次产出 B 乘 n 个候选,吃满批推理引擎。第四,加 lazy penalty,禁止模型重复输出数据库里已有的程序。
第二段:机制怎么转
老播:先讲 lazy penalty 为什么关键。RL 训练时,模型会发现数据库里已经有最优程序了,直接复读它就能拿高分。ThetaEvolve 用分段打分挡住:响应里没有 diff 块,扣 0.4;改动无效,扣 0.3;编译运行超时没有解,扣 0.2;解出来但验证器不过,扣 0.1;正常改动才用评估器打分。再加上一条:任何和数据库里已有程序等价的 child 一律罚。一句话,逼模型持续尝试真实改进,复读最优不会得分。
小播:第二个记忆锚点:lazy penalty 是 RL 稳定训练的关键闸门。
老播:第二个机制是 reward shaping。有些任务的分数区间很窄,比如第二自相关不等式在 0.90 到 0.96 之间,原始分区分度不够,RL 学不动。做法是把分数映射到 0 到 1,再做个幂次放大,靠近已知最优时给更陡的奖励梯度,缩放因子 k 取 3。目的是让接近上界时的微小改进也能产生稳定信号。
小播:那评估和数据库怎么配合?
老播:每个 child 过早期检查后进验证器,验证器是任务特定的:circle packing 用 1e-6 容差,严格版另算;第三自相关不等式那边,作者发现 AlphaEvolve 的评估器有 typo,修正后才用,所以跨论文数字不能直接比。通过的新程序插入数据库,按客观分和多样性排序,满员删除。
第三段:关键结果
老播:全部带 baseline 和 setup。CirclePacking:ThetaEvolve 的 8B 模型 2.63598308,前面说了。第一自相关不等式 FACI:1.503133,AlphaEvolve 是 1.503164,人类已知上界 1.5098。CirclePacking 训练对比(Table 2):带 RL 的 best 2.6359857,同期纯推理 2.6359831,初始程序只有 0.9598。第三自相关不等式:从初始的 3.1586 压到带 RL 的 1.4930,纯推理 1.5084。Hadamard 矩阵 29 阶:从 0.1433 到带 RL 的 0.5764,纯推理 0.5733。
小播:还有一个细节,它发现的 circle packing 程序跑一次只要 3 秒?
老播:对,ShinkaEvolve 那个程序要 75 秒左右。搜索得慢,求解得快,这是两件事。
小播:那「模型真的学会进化了吗」怎么证明?
老播:他们把 RL 训练到第 150 步的 checkpoint 拿出来,做纯推理——结果比从头纯推理爬得更快、落点更高。说明进化策略真的被写进了参数,不是只在程序里。而且这份能力迁移:在 circle packing 上训练的 checkpoint,拿到另外三个没见过任务上,全面超过基座模型。对照组更重要:静态环境,就是数据库不更新、每次从初始程序起步的 RL,连纯推理都打不过——开放问题的最终解,无法从初始程序直接采样得到,必须靠中间步骤积累。
小播:第三个记忆锚点:动态环境是 RL 有效的必要条件。
第四段:局限
小播:冷水。哪里要小心?
老播:四条。第一,评估口径。circle packing 用的是 1e-6 容差版本,和 AlphaEvolve 严格验证是不同任务;第三自相关不等式修正了评估器 typo。跨论文比数字,先确认验证器是不是同一个。第二,RL 稳定性靠手工调参:裁剪系数、reward shaping 的上下界和幂次都是人为指定的,没有敏感性分析。第三,数学上界接近已知最优后,改进幅度很小,小数字的成立完全依赖评估器正确——作者修正前作 typo 这件事本身就说明评估器会出错。第四,单模型替换集成缺少机制解释:前作集成贡献的多样性,为什么这里不需要,论文没展开。
小播:还有个细节,推理侧的多 seed 统计好像没报告?
老播:对,RL 那边报了 3 个随机种子,纯推理侧没有同等报告,读表时把均值和 best 的差距当成方差提示。
收尾:一句话记住这篇
老播:收尾。ThetaEvolve 把 AlphaEvolve 变成开源、单模型、可扩展的 test-time 学习系统:10000 规模的数据库管住搜索空间,批量采样管住吞吐,lazy penalty 管住 RL 作弊,reward shaping 管住训练信号。最该记住的数字:单个 8B 模型把 circle packing 上界刷到 2.63598308,对照 AlphaEvolve 前沿集成的 2.63586276。最该记住的口径:跨论文比数字前,先确认验证器是不是同一个。
小播:这篇值得读,它是「测试时学习」从概念到工程落地的一次完整示范。我们下期见。