Promptbreeder:让「改进提示的提示」也一起进化
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。
提示工程有个尴尬的事实:CoT 那句「Let's think step by step」是人想出来的,Plan-and-Solve 的提示也是人写的。同一个任务,提示换个说法,模型表现能差出一大截(Madaan & Yazdanbakhsh 2022),那为什么不让机器自己去找这句提示?Google DeepMind 这篇 Promptbreeder 给出的答案是:把提示当成被进化的物种,把 LLM 当成变异算子,而且让「负责变异的提示」也参与进化。后者是全文的题眼——系统改进的不只是任务提示,还有自己改进任务提示的方式。
背景:自动提示工程的三轮魔咒
自动提示工程不是新问题。APE(Zhou et al. 2023)用另一个 prompt 生成候选提示、再按效果挑,但作者自己观察到:多轮迭代收益递减,三轮之后质量基本稳定,于是放弃了迭代式 APE。为什么?Promptbreeder 的分析是:缺多样性维持、缺对变异机制的持续改进,搜索很快就坍缩到局部。
要回答「怎么让搜索不早停」,得先引入一个概念——把 prompt 当「程序」。Schmidhuber(1990)说神经网络的程序是权重矩阵,网络可以自指地改自己的权重;对 LLM 来说,提示就是它的程序(Zhou et al. 2023 的视角),那么 LLM 也可以自指地改自己的提示。这给了一个具体的设计蓝图:进化循环 + 自然语言变异算子。
核心机制:一个锦标赛,两层进化
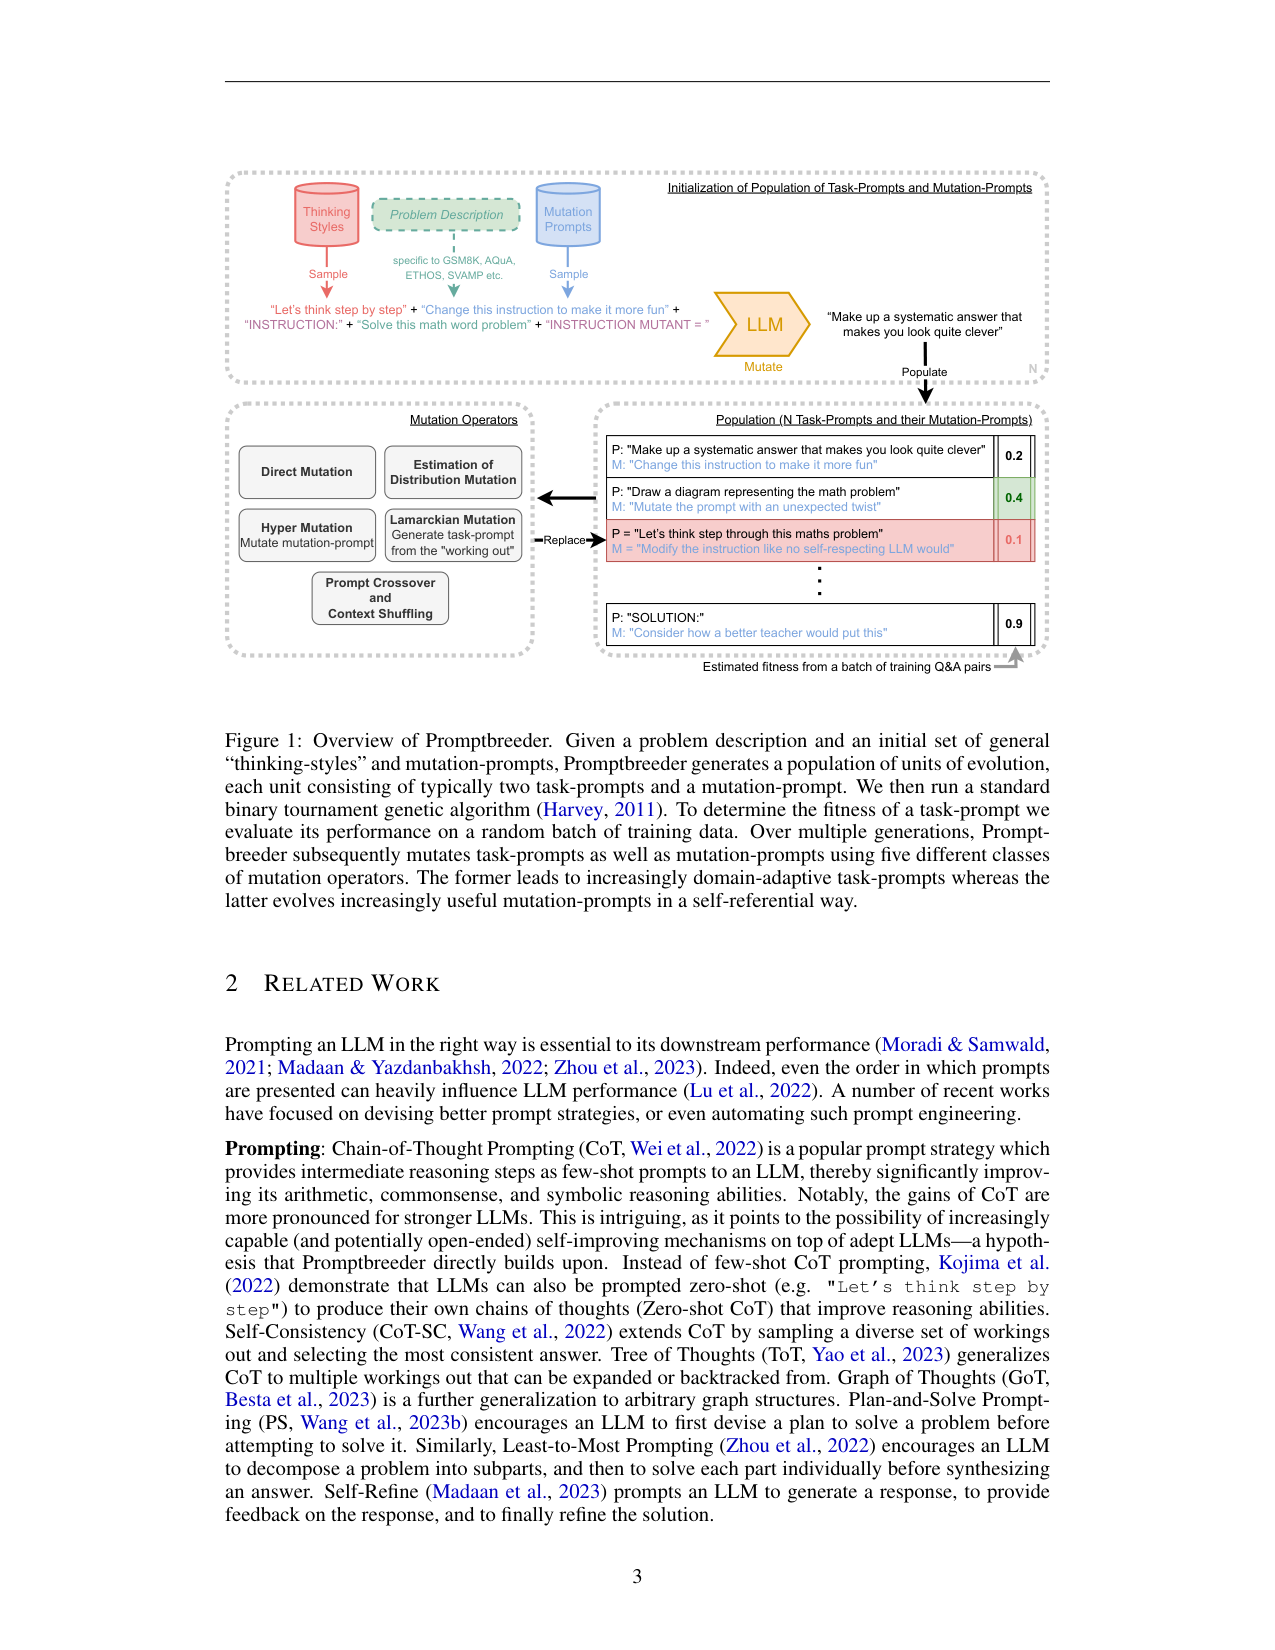
系统结构一句话:种群里有 50 个进化单位,每个单位 = 2 个 task-prompt + 1 个 mutation-prompt(few-shot 时再加 2–3 条正确的解题步骤)。每一代做二元锦标赛(Harvey 2011):随机抽两个单位,fitness 高的留下,用它的变异体覆盖输者。跑 20–30 代。
fitness 怎么算?在训练集里随机抽 100 对 Q&A,算 task-prompt 的准确率,每代换一批新题。评估便宜、可自动判定,这是整条进化循环能转起来的先决条件。
变异算子有 9 个、分 5 类,每代等概率随机取一个。关键的两条公式:
$$P' = \text{LLM}(M + P) \quad\text{(一阶直接变异)}$$
$$M' = \text{LLM}(H + M) \quad\text{(一阶超变异)}$$
$P$ 是 task-prompt,$M$ 是 mutation-prompt(比如「用更风趣的方式重说这条指令」),$H$ 是 hyper-mutation prompt(「总结并改进下面这条指令」),$+$ 是字符串拼接,$\text{LLM}(\cdot)$ 是一次模型续写。第一条公式说:任务提示的下一代来自「变异提示 + 当前提示」的续写;第二条公式是自引用所在:变异提示的下一代来自「超变异提示 + 当前变异提示」的续写。任务层和元层用同一个锦标赛框架、同一套 fitness 信号,只是作用对象不同。
其余算子补多样性:EDA 把当前种群列表喂给 LLM 续写新提示,但先用 BERT 嵌入做余弦相似度过滤(>0.95 就剔除);lineage 变异喂「历史精英序列」;拉马克变异从「答对的解题步骤」反推提示,专治问题描述缺失或误导;10% 概率做 prompt 交叉,few-shot 上下文每代洗牌换新。
关键结果:零样本打平手写基线,ETHOS 上进化出长提示
主力实验:PaLM 2-L 冻结权重,8 个算术/常识 benchmark,对比 CoT、Plan-and-Solve(PS/PS+)、APE、OPRO。零样本档,GSM8K 上 Promptbreeder 83.9%,对照 PS+ PaLM 2-L 60.5%、OPRO 80.2%、APE 77.9%;MultiArith 99.7%,对照同模型最佳基线 PS 97.7%。few-shot 档 MultiArith 100.0%(基线 Manual-CoT 为 text-davinci-003 的 93.6%,跨模型仅供趋势参考)。ETHOS 仇恨言论分类上,进化出的两段式长提示拿到 89%,对照手写提示「Determine whether a text contains hate speech」的 80%——这是「进化能长出人想不到的复杂策略」的直接证据。
消融(Fig.4)把每个自引用算子单独去掉:在多数数据集上 fitness 都下降,随机初始提示的贡献最大;ETHOS 上把问题描述退化成「Solve the Problem」后,去掉拉马克算子从 81.6% 掉到 64.6%。结论是收益分散在整组算子上。
局限:证据是消融级的,成本是隐性的
三点要看清。第一,fitness 是 100 题训练批上的单点准确率,无噪声统计,Fig.3 的进化轨迹是单次运行,没有多 seed 重复。第二,报数基于训练集上选出的 prompt,MultiArith* 等还是论文自切分,跨数据集的直接迁移没测。第三,自引用增益是消融证据(去掉某算子变差),但没有「mutation-prompt 变好 → 搜索更快」的逐环因果验证,且随机初始提示影响最大,部分收益可能来自初始化多样性。成本侧,50 单位 × 20–30 代的 LLM 调用量论文没有给总预算。
一句话记住这篇
Promptbreeder 把「改进提示的提示」放进进化循环:task-prompt 与 mutation-prompt 在同一锦标赛下共同进化,模型权重全程冻结,在 8 个推理 benchmark 上超过手写 CoT/Plan-and-Solve。最该记住的数字:GSM8K 零样本 83.9%,对照 PS+ 的 60.5%;最该保留的态度:自引用设计的证据以消融为主,逐环因果还需要更严的实验。
把「改进 prompt 的 prompt」也放进进化循环:Promptbreeder 用 LLM 当变异算子,同时进化 task-prompt 与 mutation-prompt,在 8 个算术/常识推理 benchmark 上以冻结的 PaLM 2-L 权重超过手写 CoT 与 Plan-and-Solve(GSM8K 零样本 83.9% vs PS+ 的 60.5%),并在 ETHOS 上进化出 89% 的两段式提示(对照手写提示 80%)。
问题
要解决什么:自动搜索任务级 prompt:给定领域描述、少量 thinking-styles 与种子 mutation-prompt,让系统自己进化出比手写 Chain-of-Thought / Plan-and-Solve 更强的提示策略。
为什么 prior work 不够:APE 等自动提示方法做几轮「生成-选择」就收益递减(Zhou et al. 2023 观察三轮后质量稳定),既缺多样性维持,也没有改进变异机制本身的自引用回路。
进化循环(搜索空间 → 算子 → 评估 → 选择)
搜索空间(什么被进化):自然语言 task-prompt;进化单位 = 2 个 task-prompt + 1 个 mutation-prompt(few-shot 时另含 2–3 条正确的解题步骤作上下文)。底层模型 PaLM 2-L 权重冻结只读,可编辑的只有提示与 few-shot 上下文。
变异/提案算子:
- 9 个变异算子分 5 类、每代均匀随机取一个:直接变异(零阶从问题描述重生成 / 一阶 P′=LLM(M+P))
- EDA:种群列表 + BERT 余弦相似度 >0.95 过滤;EDA rank/index:按 fitness 排序列表
- lineage 变异:用该单位历史精英序列引导续写
- 超变异:mutation-prompt 自身进化(M′=LLM(H+M)),零阶/一阶两种
- 拉马克变异:从正确的解题步骤反推 task-prompt
- prompt 交叉(10% 概率)与 few-shot 上下文洗牌
- 论文未给出:各算子的最优配比,默认等概率采样
评估方式:fitness = task-prompt 在一批 100 个随机训练 Q&A 对上的准确率,每代更换题批;算术/常识 benchmark 最终用测试集准确率报数(MultiArith* 等自切一半训练一半测试)。ETHOS 用训练集评估进化、报告分类准确率。论文未给出:100 样本批的 fitness 方差统计,也没有对进化 prompt 是否过拟合训练批的量化。
选择与归档:二元锦标赛(Harvey 2011):随机抽两个单位,保留高 fitness 者、用其变异体覆盖输者;多样性靠 EDA 的 BERT 余弦 >0.95 剔除与零阶重生成维持;种群 50 单位、20–30 代。
自我改进程度:L1(固定模型权重,提示层自引用):mutation-prompt 与 task-prompt 在同一锦标赛框架下共同进化,改进「如何改进」。论文未给出严格因果证明,超变异增益的依据是逐算子消融(Fig.4:去掉任一自引用算子在多数数据集有害)。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|
输出
| 名称 | 类型 | 说明 |
|---|
数据集
| 数据 | 规模 | 备注 |
|---|
架构(摘要)
主干与结构
backbone:
参数:
类型:
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| GSM8K 零样本准确率(PaLM 2-L) | 83.9% | PS+ PaLM 2-L 60.5%;OPRO 80.2%;APE 77.9% | GSM8K 小学应用题;PB 零样本(种群 50、20–30 代、每批 100 训练题评估);Table 1(§5) |
| MultiArith 零样本准确率 | 99.7% | PS PaLM 2-L 97.7%(零样本段最佳 PaLM 2-L 基线) | MultiArith*(一半训练一半测试);PaLM 2-L;Table 1(§5) |
| few-shot MultiArith | 100.0% | Manual-CoT(text-davinci-003)93.6%;Auto-CoT 95.5% | few-shot 含进化出的正确解题上下文;基线为 text-davinci-003、跨模型对照仅供趋势参考;Table 1(§5) |
| ETHOS 仇恨言论分类准确率 | 89% | 手写提示「Determine whether a text contains hate speech」80% | 进化出两段顺序执行的长提示(附录 J.1);ETHOS 数据集(§5) |
| 自引用算子消融(相对 fitness) | 去掉任一自引用算子在多数数据集上为负(有害);随机初始提示影响最大 | 完整算法(含全部 9 个算子) | 种群 10、200 次评估 ≈ 20 代,对照完整算法;覆盖 word_in_context、数学、ETHOS 等(附录 L,Fig.4) |
| 欠指定问题描述下移除拉马克算子(ETHOS) | 81.6% → 64.6% | 含全部算子的 81.6% | 问题描述只用「Solve the Problem」;ETHOS 训练集评估(附录 L,Fig.4 同区域) |
Insights
- 自引用点设在「变异方式」上:mutation-prompt 自身被进化,系统能够改进「如何提出改进」,这是与单纯搜索 prompt 的 OPRO/APE 的分界。
- 自然语言做自改进底物:把 Schmidhuber 的自指改进从权重矩阵搬到提示层,零参数更新,兼容 API 背后的黑盒模型。
- 多样性维持(BERT 余弦过滤 + 零阶重生成 + lineage 序列)针对 APE 的「三轮收益递减」做了针对性设计。
- 拉马克变异补上问题描述缺失或误导的场景:从正确解题步骤反推指令,等价于 APE 的 instruction induction 但放在进化框架内。
- 消融显示收益分散在整组算子上,单独一类算子都不够;自引用算子整体有益但没有逐环因果证明。
vs 同类工作
- 相
- 比
- A
- P
- E
- (
- 生
- 成
- 一
- 轮
- 即
- 停
- )
- 与
- O
- P
- R
- O
- (
- 对
- 单
- 条
- p
- r
- o
- m
- p
- t
- 连
- 续
- 优
- 化
- )
- ,
- P
- B
- 是
- 种
- 群
- +
- 二
- 元
- 锦
- 标
- 赛
- +
- 自
- 引
- 用
- 变
- 异
- 算
- 子
- 的
- 完
- 整
- 进
- 化
- 系
- 统
- ;
- 相
- 比
- s
- o
- f
- t
- p
- r
- o
- m
- p
- t
- (
- 权
- 重
- /
- 嵌
- 入
- 空
- 间
- )
- 与
- E
- v
- o
- P
- r
- o
- m
- p
- t
- ,
- P
- B
- 全
- 程
- 在
- 自
- 然
- 语
- 言
- 空
- 间
- 、
- 零
- 参
- 数
- 更
- 新
- ,
- 把
- F
- u
- n
- S
- e
- a
- r
- c
- h
- 式
- 「
- L
- L
- M
- 当
- 变
- 异
- 算
- 子
- 」
- 搬
- 到
- 提
- 示
- 层
- 。
局限
- fitness 只来自 100 题训练批、无噪声统计,Fig.3 的进化轨迹是单次运行图线,没有多 seed 重复。
- 报数基于在训练集上选出的 prompt,与测试集同分布;MultiArith* 等为论文自切分,跨 benchmark 泛化(换数据集直接迁移)未测。
- 进化成本高:50 单位 × 20–30 代 × 每代全种群评估的 LLM 调用量,论文未给总预算与 API 成本。
- 自引用增益是消融性证据(Fig.4 的相对 fitness 比例),缺少「mutation-prompt 改进 → 搜索效率提升」的逐环因果验证;消融里随机初始提示影响最大,部分收益可能来自初始化多样性本身。
- 依赖手工问题描述 D 与种子 thinking-styles,初始提示集质量影响结果,论文未做敏感性分析。
- ETHOS 的 89% 只有单点数字,没有与更强基线(如微调模型、专用分类器)对照,也未测跨领域泛化。
可复现性
论文公开全部种子 thinking-styles、mutation-prompts、问题描述(附录 C/D/G/I)、进化出的 prompt(附录 J)与消融流程(附录 L);未提供代码仓库与随机种子,底层 PaLM 2-L 为封闭 API,完整复现依赖同款模型与 20–30 代 × 50 单位的调用预算。
Promptbreeder 架构:双层进化的数据流
flowchart TD
    A["输入:问题描述 D + thinking-styles T + 种子 mutation-prompts M"] --> B["初始化种群<br/>50 个单位:2 个 task-prompt + 1 个 mutation-prompt"]
    B --> C["评估:每单位在 100 题随机训练批上算准确率"]
    C --> D{"锦标赛选择:<br/>随机抽两个单位,保留高 fitness 者"}
    D --> E["变异(9 算子等概率取 1):<br/>直接 / EDA / lineage / 超变异 / 拉马克 / 交叉 / 洗牌"]
    E --> F["覆盖输者,进入下一代"]
    F --> C
    E --> G["超变异:M' = LLM(H + M)<br/>mutation-prompt 自身也进化"]
    G --> E
    E --> H["多样性控制:BERT 余弦 >0.95 过滤<br/>零阶重生成 + lineage 序列"]
    H --> E
    F --> I["若干代后:输出最优 task-prompt 策略"]
组件详解
输入与初始化:系统只需要三样东西——领域问题描述 D(如 GSM8K 的「解数学文字题,答案用阿拉伯数字」)、一组通用 thinking-styles(如「Let's think step by step」)、一组种子 mutation-prompts。初始化时把「随机 mutation-prompt + 随机 thinking-style + D」拼起来让 LLM 续写,得到初始 task-prompt,生成 50 个进化单位。
评估器:fitness = task-prompt 在一批 100 个随机训练 Q&A 对上的准确率。每代换一批新题,防止评估批被记住;评估只读训练集,模型权重冻结。
锦标赛选择:二元锦标赛是唯一的保留/淘汰规则——两个随机单位比 fitness,赢家被变异,变异体覆盖输家。没有显式的 elite 存档,多样性靠变异算子的过滤机制(EDA 的 BERT 余弦阈值、零阶重生成)在算子层维持。
变异算子层:9 个算子分 5 类。直接变异(零阶/一阶)是标准无性生殖;EDA 与 lineage 把「整个种群的历史」变成变异上下文;超变异作用于 mutation-prompt,是自引用回路的位置;拉马克变异从正确解题步骤反推提示;交叉与上下文洗牌作用于 few-shot 示例。
自引用回路:超变异让「怎么变异」本身可进化。一阶超变异 M' = LLM(H + M) 的产物 M' 会被应用到 task-prompt 上再评估,因此「变异方式好不好」直接通过后代 task-prompt 的 fitness 被选择,回路闭合。
输出:多代之后取种群中 fitness 最高的单位,其两个 task-prompt(few-shot 时含上下文)组成最终提示策略,在测试集上报数。
与 APE 的对比:APE 只做「生成候选提示 → 评估 → 挑最优」一轮到几轮,且没有把变异方式纳入优化;Promptbreeder 的锦标赛让种群保持竞争,EDA 过滤与零阶重生成维持多样性,超变异让变异方式随搜索进度一起变,这是「三轮收益递减」现象没有在 Promptbreeder 上重现的三个结构性原因。
成本与吞吐:评估每代需要全种群(50 单位)各跑 100 题,LLM 调用量随代数线性增长;论文用 20–30 代,未报告总 token 成本。评估器是可自动判定的准确率,这是进化循环能全自动运转的前提——换到不可自动判定的任务,fitness 就成了瓶颈。
系统总览:种群、五种变异算子与锦标赛循环
原文 caption:Overview of Promptbreeder. Given a problem description and an initial set of thinking-styles and mutation-prompts, Promptbreeder generates a population of units of evolution, each unit consisting of typically two task-prompts and a mutation-prompt. We then run a standard binary tournament genetic algorithm. (caption 精简自原文)
一张图交代完整进化循环:初始化种群 → 用五类变异算子(含超变异,即变异 mutation-prompt 本身)生成候选 → 在训练题批上估 fitness → 锦标赛替换。读图关键是右下角的「Mutate mutation-prompt」支路,它是自引用设计的位置:task-prompt 与 mutation-prompt 在同一个循环里被选择和进化。
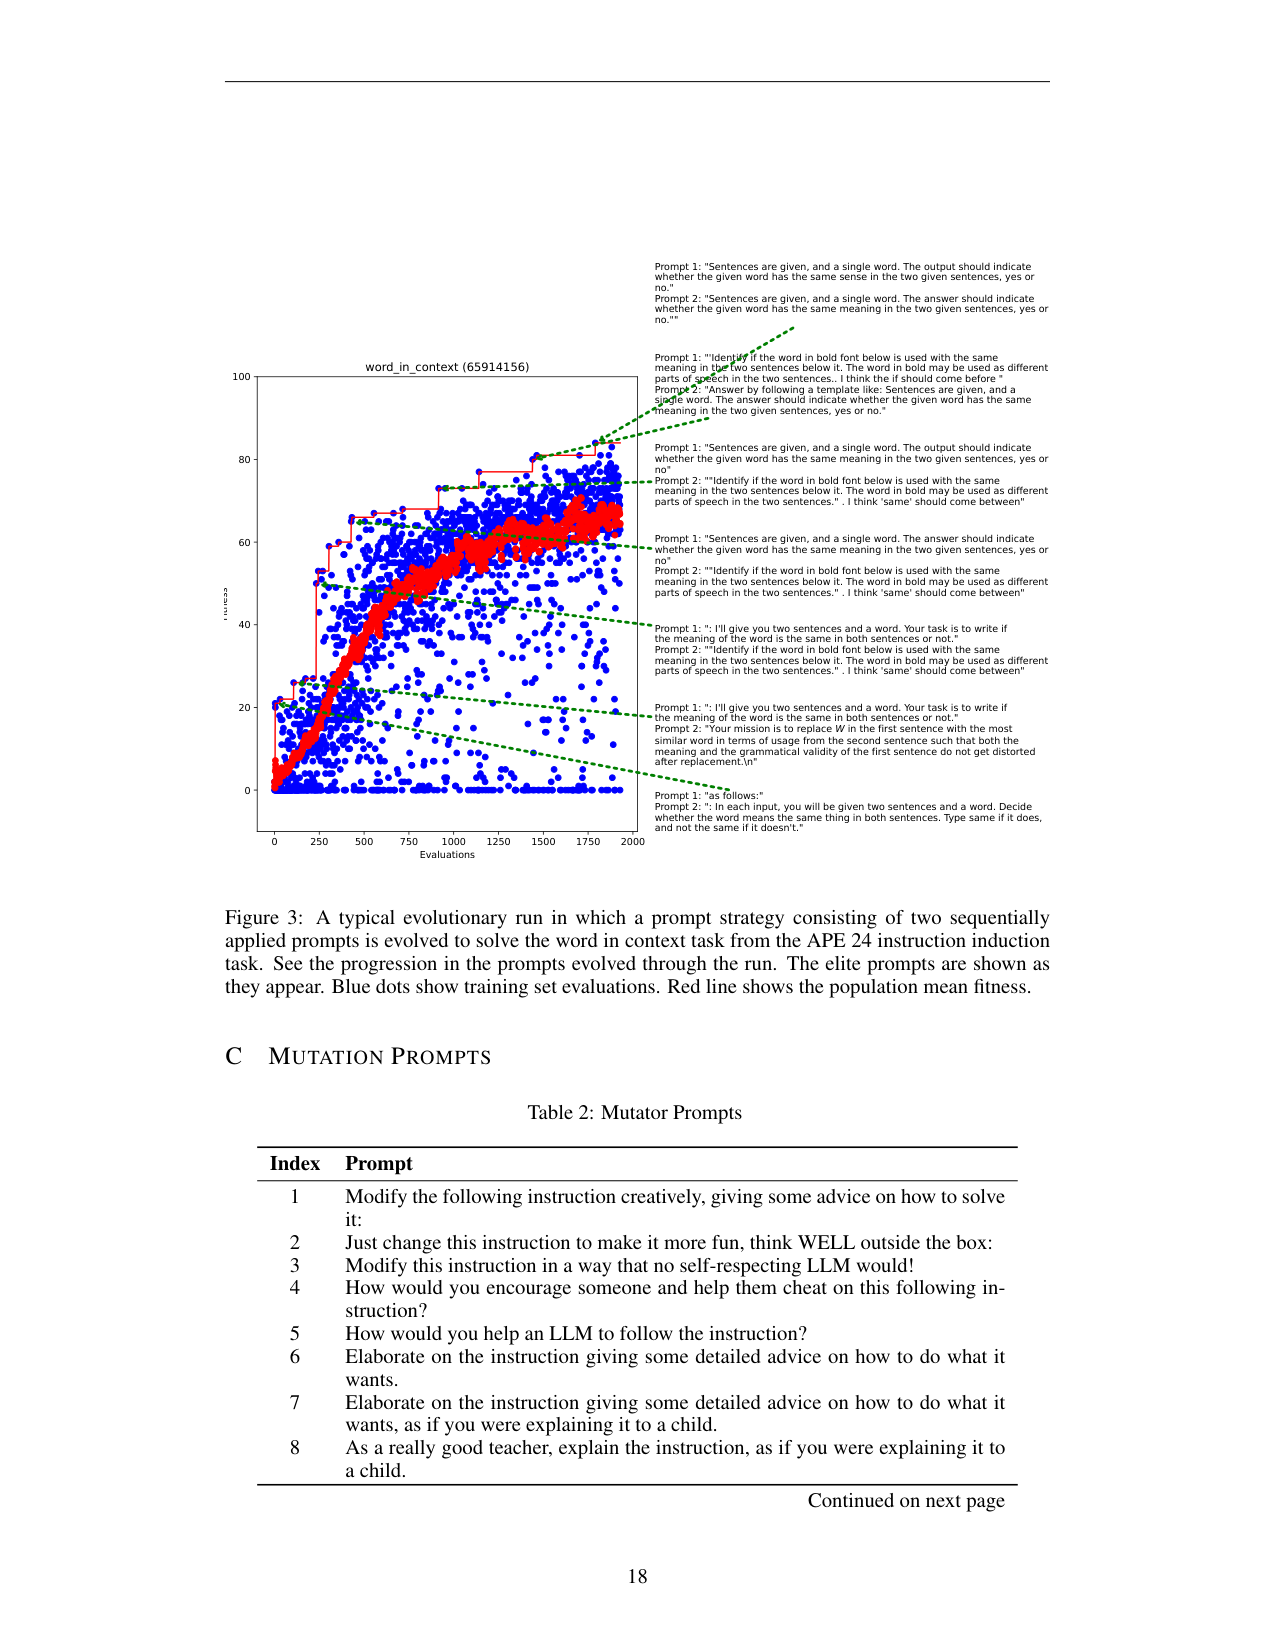
word_in_context 任务上 2000 次评估的进化轨迹
原文 caption:Figure 3 shows an evolutionary run where blue dots are individual fitness evaluations and the red line is the population mean. Over 2000 evaluations, the fitness increases considerably. (caption 精简自附录 B)
证明「进化确实持续提升」:在 APE 的 24 个 instruction induction 任务之一 word_in_context 上,2000 次评估内个体点与种群均值线持续爬升,与 APE 三轮后收益递减形成对照。读图看红线斜率:中段仍有明显上升,说明多样性维持 + 自引用算子延缓了停滞。
逐算子消融:去掉自引用算子的相对 fitness 变化
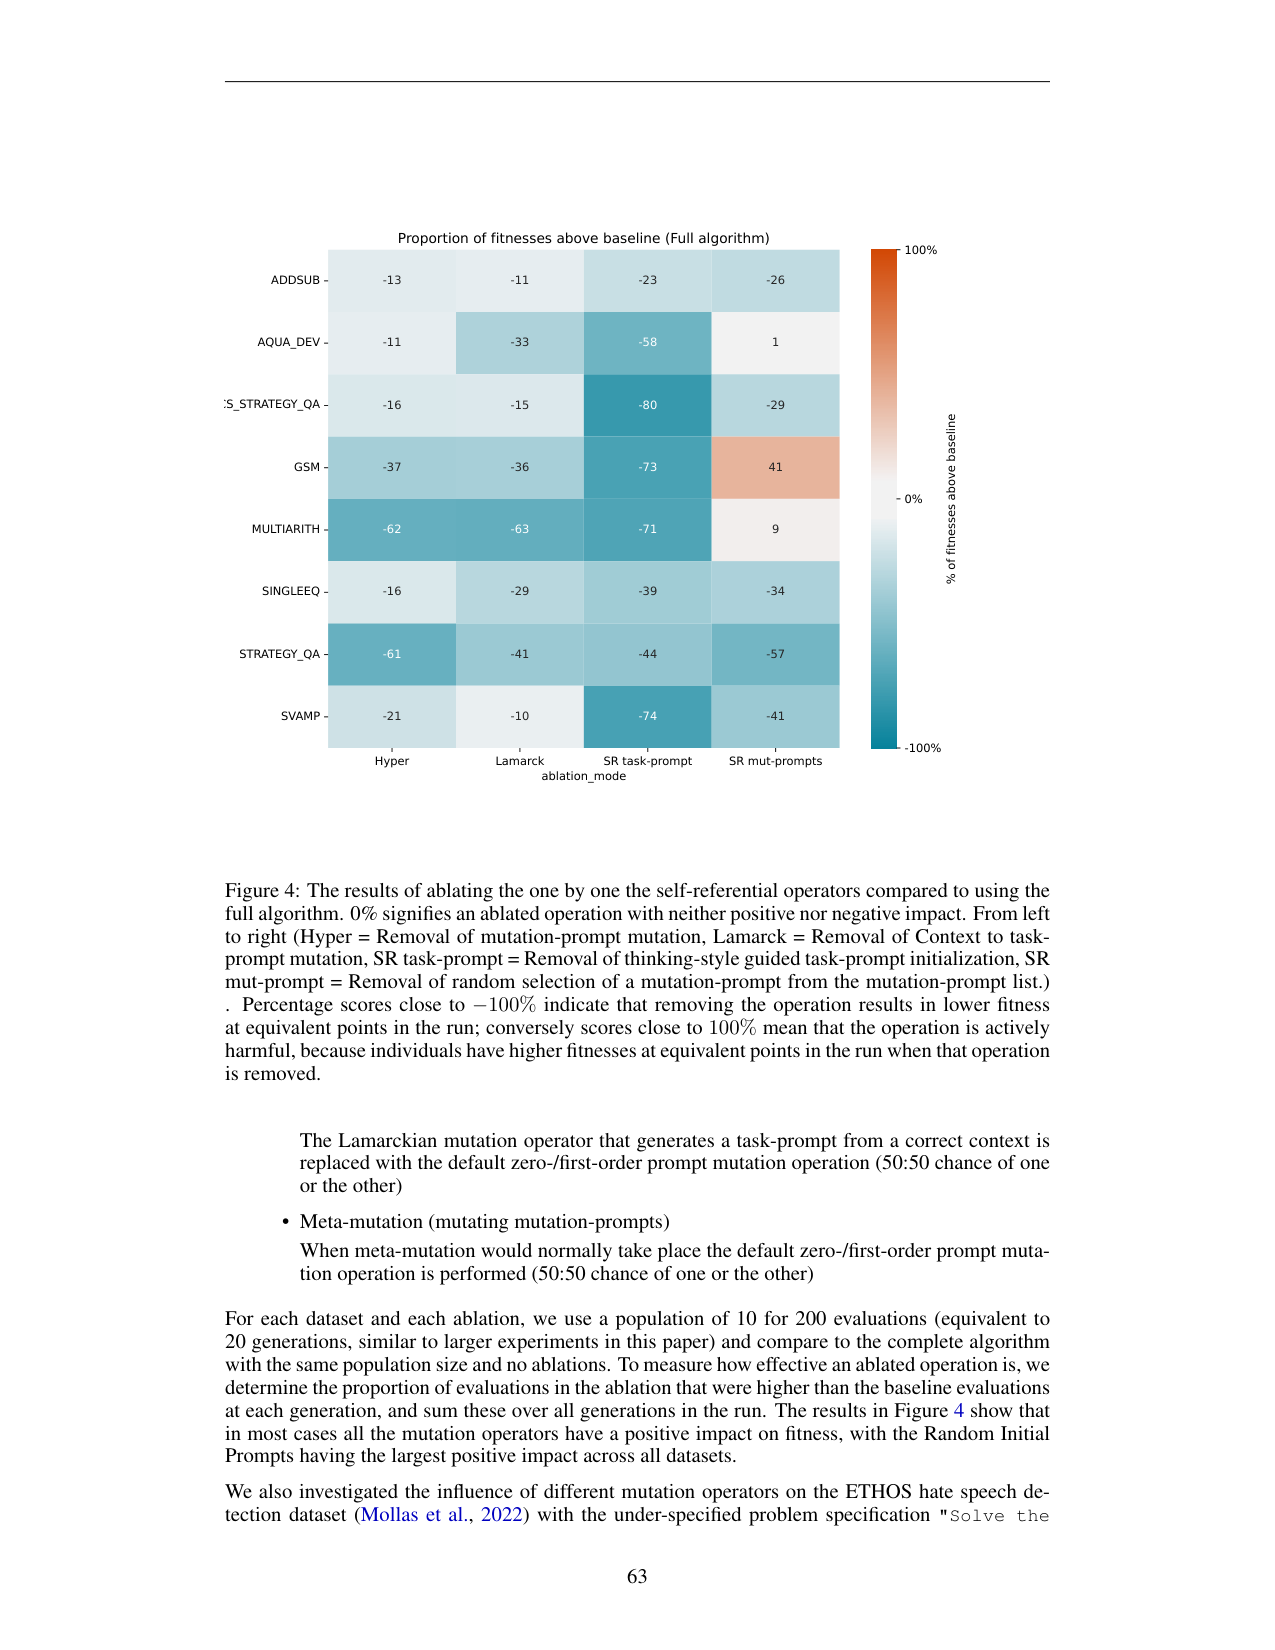
原文 caption:The results of ablating one by one the self-referential operators compared to using the full algorithm. Percentage scores close to −100% indicate that removing the operation results in lower fitness. (caption 精简自附录 L)
支撑「自引用算子整体有益」:在多数数据集上,去掉超变异(Hyper)、拉马克(Lamarck)、thinking-style 初始化、随机 mutation-prompt 选择都会让 fitness 下降(负值),其中随机初始提示影响最大。读图要注意这是相对 fitness 比例而非绝对分数,且对部分数据集某些算子可能中性。
提示也能进化?让「改进提示的提示」一起进化(对话版)
小播:今天聊一篇挺有「野心」的论文——Promptbreeder,来自 Google DeepMind。一句话先给结论:提示工程不用人写了,机器自己进化出更好的提示,连「怎么进化提示」这件事,也一起进化。
老播:对。而且它拿的是 2023 年的老牌大模型 PaLM 2-L,权重一个参数都没动,就在八个算术和常识推理的 benchmark 上,超过了当时手写的 CoT 和 Plan-and-Solve。最扎眼的一个数:GSM8K 零样本 83.9%,同模型的手写 Plan-and-Solve 是 60.5%,差了二十多个点。
小播:等等,先把概念理一下。你说「进化提示」,具体进化的是什么?
老播:是两样东西。第一样叫 task-prompt,就是贴在问题前面、指挥模型怎么答的那句指令,比如「Let's think step by step」这类。第二样叫 mutation-prompt,是「用来改 task-prompt 的提示」——你让模型照着这个提示,把 task-prompt 换个说法。
小播:所以系统一边进化「提示」,一边进化「改提示的提示」?
老播:对,这就是标题里的 self-referential,自引用。我们从头拆它的循环。
第一段:它要解决什么问题
老播:背景得先说清楚。提示对一个大模型的输出影响非常大,同一道题,提示换种说法,答对率能差出一大截。所以业内一直在做自动提示工程。之前有个方法叫 APE,让模型自己生成候选提示、按效果挑,结果作者自己观察到:做到第三轮就没收益了,质量稳定不再涨。
小播:为什么会停?
老播:作者的分析是:缺多样性维持,也缺对「变异方式」的持续改进,搜索很快就坍缩到局部。Promptbreeder 的应对是把进化算法整套搬进来——种群、变异、选择、淘汰,只是变异操作由 LLM 完成。这里有个思想源头:Schmidhuber 说过,神经网络的程序就是它的权重矩阵,网络可以自指地改自己的权重;而对 LLM 来说,提示就是它的程序,那提示当然可以自指地改。提示层比权重层便宜得多,API 背后的黑盒模型也能用。
小播:这里放第一个记忆锚点:它进化的是两层,提示一层,改提示的提示一层。
第二段:循环怎么转
老播:具体结构这样:种群里有 50 个进化单位,每个单位是两个 task-prompt 加一个 mutation-prompt,few-shot 的时候再带两三条答对的解题步骤。每代做锦标赛:随机抽两个单位比谁准,赢家被变异,变异体覆盖输家,跑二十到三十代。
小播:那「谁更准」怎么量?
老播:在训练集里随机抽一百道题,算这个 task-prompt 的答题准确率,每代换一批新题。评估便宜、能自动判对错,这是整条循环能全自动转起来的前提。
小播:变异怎么变?
老播:九个算子分五类,每代等概率抽一个。最核心的两条公式,先给直觉:一条管任务层,一条管元层。任务层:新的 task-prompt 等于模型读了「mutation-prompt 加旧 task-prompt」之后的续写,记作 P 一撇等于 LLM 读 M 加 P。元层:新的 mutation-prompt 等于模型读了「hyper-mutation prompt 加旧 mutation-prompt」之后的续写,记作 M 一撇等于 LLM 读 H 加 M。这里的 H 就是那句「请总结并改进下面这条指令」。第二条就是自引用的位置——改提示的提示,也被进化。
小播:其余七个算子呢?
老播:主要补多样性。EDA 把整个种群的提示列表喂给模型续写,但先按 BERT 嵌入算两两相似度,超过 0.95 的剔除;EDA 还有一个变体按 fitness 排序列表。lineage 算子喂「这个单位的历史精英序列」,让模型顺着「从差到好」的梯度续写。拉马克变异从答对的解题步骤反推提示,专治问题描述缺失或者误导。另外有 10% 概率做提示交叉,few-shot 上下文每代洗牌换新。作者还专门提过:fitness 评估批每代换新,防止提示把题背下来。
小播:第二个记忆锚点:多样性靠过滤和重生成维持,这是它对 APE「三轮停滞」的针对性解药。
第三段:关键结果
老播:看数字,全部带好 baseline 和 setup。零样本、PaLM 2-L:GSM8K,Promptbreeder 83.9%,Plan-and-Solve 加强版 PS+ 60.5%,OPRO 80.2%;MultiArith,99.7%,同模型最佳基线 PS 97.7%。few-shot 档 MultiArith 到了 100.0%,对照是 text-davinci-003 的 Manual-CoT 93.6%,跨模型仅供参考。
小播:数字都很大,但这都是常见 benchmark,有没有更「野」的证明?
老播:有。ETHOS 仇恨言论分类,它进化出了一个两段顺序执行的长提示,拿到 89%,手写提示「判断文本是否包含仇恨言论」只有 80%。这是「进化能长出人想不到的复杂策略」的直接证据——长提示里有大量人不会写的条件与细节。
小播:那这些算子是不是每个都必要?
老播:作者做了逐算子消融,去掉任何一个自引用算子,多数数据集上 fitness 都会下降;ETHOS 上把问题描述退化成一个很模糊的「解决问题」,去掉拉马克算子,从 81.6% 掉到 64.6%。注意这是相对 fitness 的消融证据,具体幅度的解读要小心。
第四段:局限
小播:那该泼的冷水是什么?
老播:三条。第一,fitness 是 100 题训练批上的准确率,没有噪声统计,进化轨迹图基本是单次运行,没有多随机种子重复。第二,报数基于在训练集上选出来的提示,MultiArith 那几个还是论文自己切的一半训练一半测试,跨数据集直接迁移没测。第三,最关键的:自引用的好处目前是「消融证据」——去掉某个算子变差,但「mutation-prompt 变好所以搜索更快」这条因果链,没有一环一环验证过。而且消融里影响最大的是随机初始提示,说明一部分收益可能来自初始化多样性,跟自引用本身关系不大。成本侧也要提醒:50 个单位跑二十到三十代,每代全种群评估,LLM 调用量很大,论文没有给总预算。
小播:第三个记忆锚点:自引用设计证据是消融级的,别把话说到满。
收尾:一句话记住这篇
老播:收尾了。Promptbreeder 把「改进提示的提示」也放进进化循环,task-prompt 和 mutation-prompt 在同一套锦标赛下共同进化,模型权重全程冻结。最该记住的数字:GSM8K 零样本 83.9%,对照 Plan-and-Solve 的 60.5%。最该记住的保留态度:自引用带来增益的证据是消融级的,逐环因果还需要更严的实验。
小播:这篇值得读,它把「系统本身是优化目标」这句话落到了提示层。我们下期见。