Continual Harness:不重置的自我改进——先通关宝可梦,再自动化它
> 量子位技术拆解 · reset-free 是支点:agent 一边玩一边改自己的 harness。完整结构化数据见「速查」tab。
先看一个现象:Claude Code、OpenHands 这些 coding harness 已经成了标配,但具身 agent(部分可观测、长时程决策)没有对应的自改进 harness——PokeAgent Challenge 报告,没有领域脚手架的前沿 VLM 在 RPG 上几乎零进展。普林斯顿、ARISE 与 Google DeepMind 的这篇论文(arXiv 2605.09998)分两步讲了一个完整故事:先用 Gemini Plays Pokémon(GPP)证明「人在环打磨 harness」能通关三个宝可梦,再把这个循环自动化成 Continual Harness,最后让开源模型的权重也加入共学。
核心思想:agent 行动、Refiner 编辑,同一个 episode 内交替
Continual Harness 的基线是 H_min:帧画面 + 局部 ASCII 地图 + 按键动作,无子 agent、无记忆、无技能。harness 状态拆成四个组件:system prompt $p$、子 agent 集 $G$、技能库 $K$(文本启发式 + 可执行程序)、记忆 $M$。agent 的每一步读观测 $s_t$、当前 harness $H_t$ 与轨迹 $\tau_t$ 输出动作;而 Refiner 每隔 $F$ 步(warm-up $W$ 之后)读最近轨迹窗口 $\tau_{t-F:t}$,找失败签名(导航循环、工具调用失败、目标停滞、漏探索),然后跑四趟 CRUD:重写 prompt、增删改子 agent、固化或修复技能、增改降权记忆。编辑就地生效:
$$H_{t+1} = H_t \oplus \Delta$$
$\Delta = (\Delta_p, \Delta_G, \Delta_K, \Delta_M)$ 是四个组件的编辑,$\oplus$ 表示 prompt 替换 + 其余组件做 create/read/update/delete。关键差异在 reset-free:agent 不重置,失败签名单调累积,所有后续 refinement pass 都能看到早期失败——reset-based 的 prompt 优化(如 GEPA)每次更新后重开 episode,结构上够不到只在游戏深处出现的失败(late-game 战斗、多步谜题、对话链)。
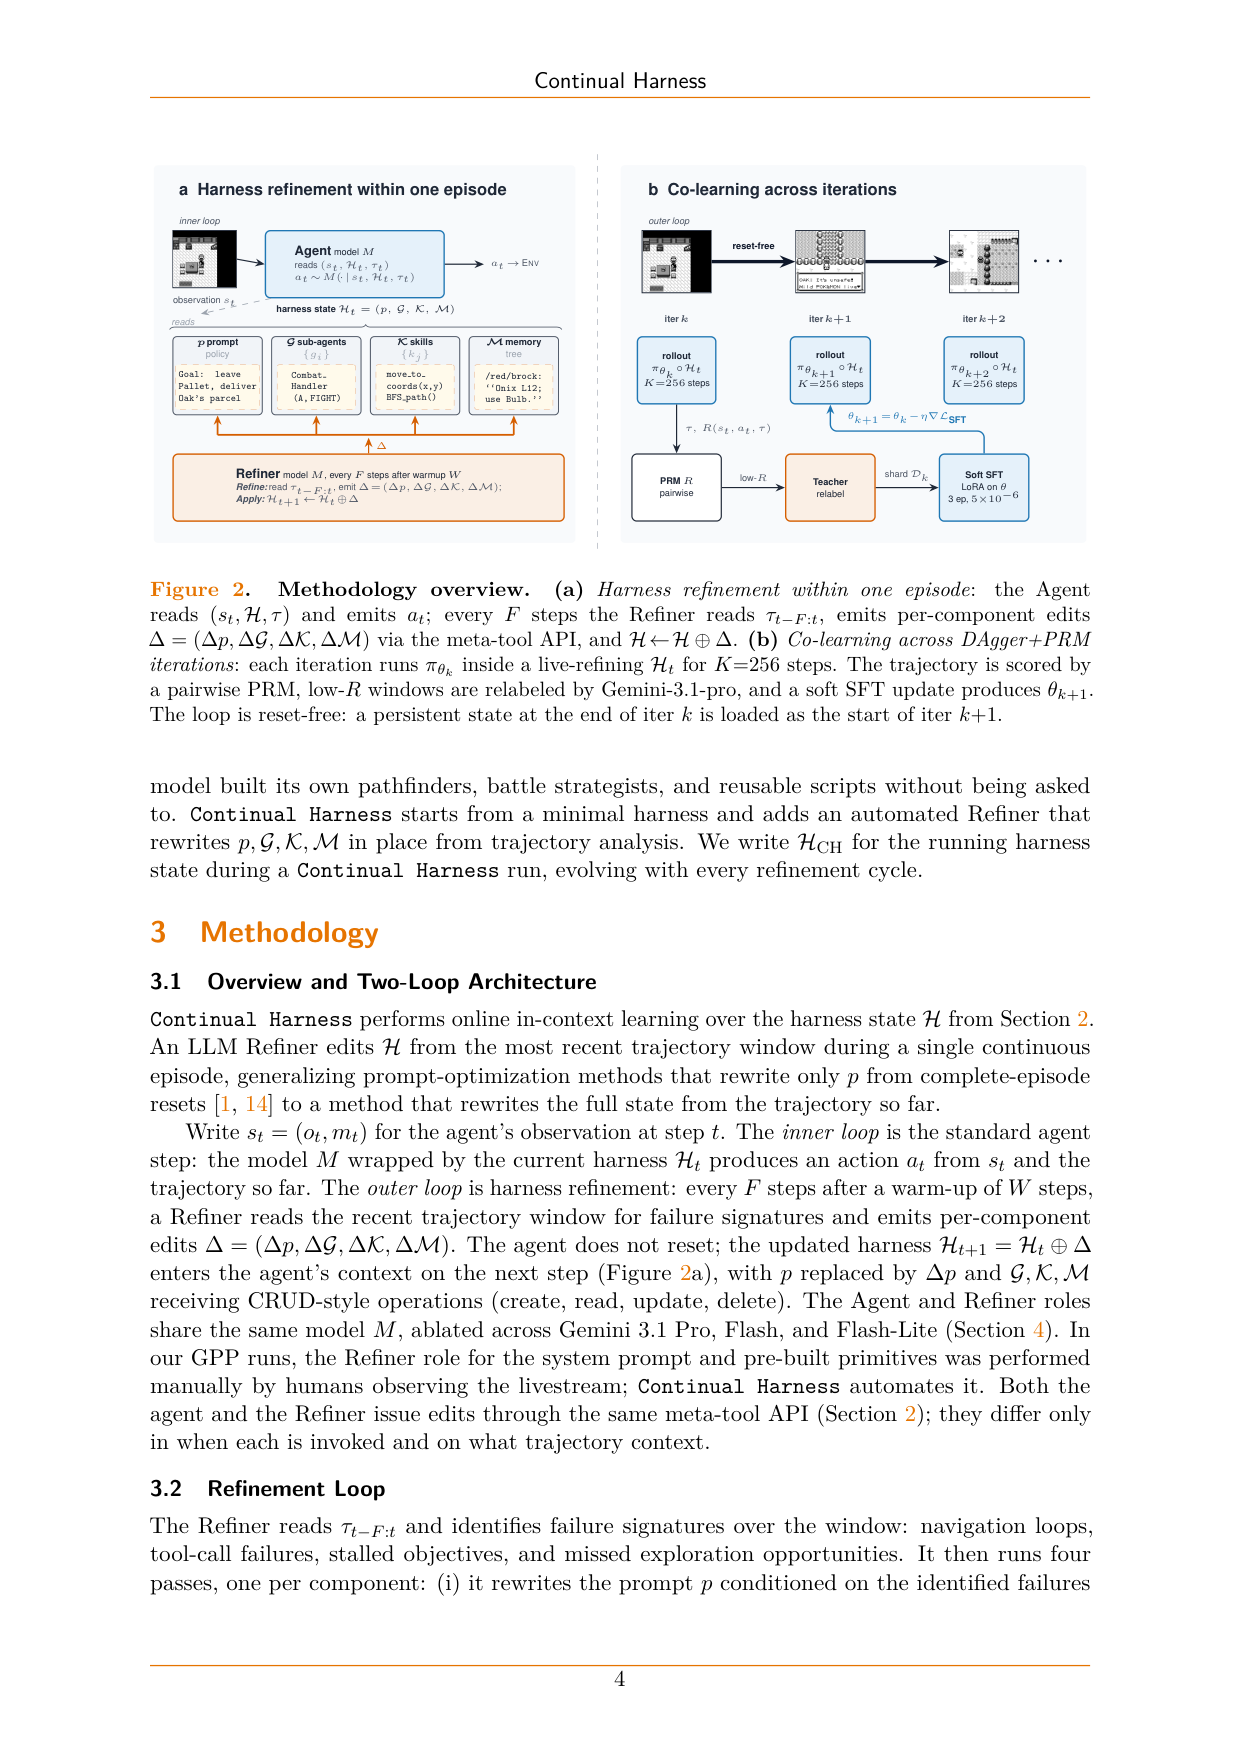
Red 用的是 11 个里程碑的子集序列(到 Thunder Badge),Emerald 是 9 个里程碑序列(到第 2 个道馆 Knuckle Badge);两条曲线都截断在各自 run 的最后一个监控里程碑,所以「里程碑达成率」是随 run 长度变化的活指标。## 关键结果一:从零自举,收复大部分专家差距
评估用 PokeAgent Challenge 的里程碑标准,主指标是累计按键数。在 Pokémon Red 与 Emerald 上,从 H_min 出发的 from-scratch CH 明显比 H_min 更省按键,收复了大部分到专家 harness 的差距:Gemini 3.1 Pro 上,Emerald 的 from-scratch CH 达到 100% 里程碑、中位成本约 $130,H_min 是 98% 里程碑、约 $215——约 40% 的成本下降;bootstrap-updating(继承一次成功 run 的 harness 并继续精化)在 Red 上每个里程碑都比 from-scratch 更高效,说明精化信号跨 run 累积。残余差距集中在道馆内部对话与多回合战斗策略,论文把它归为「还不稳定合成的组件」。
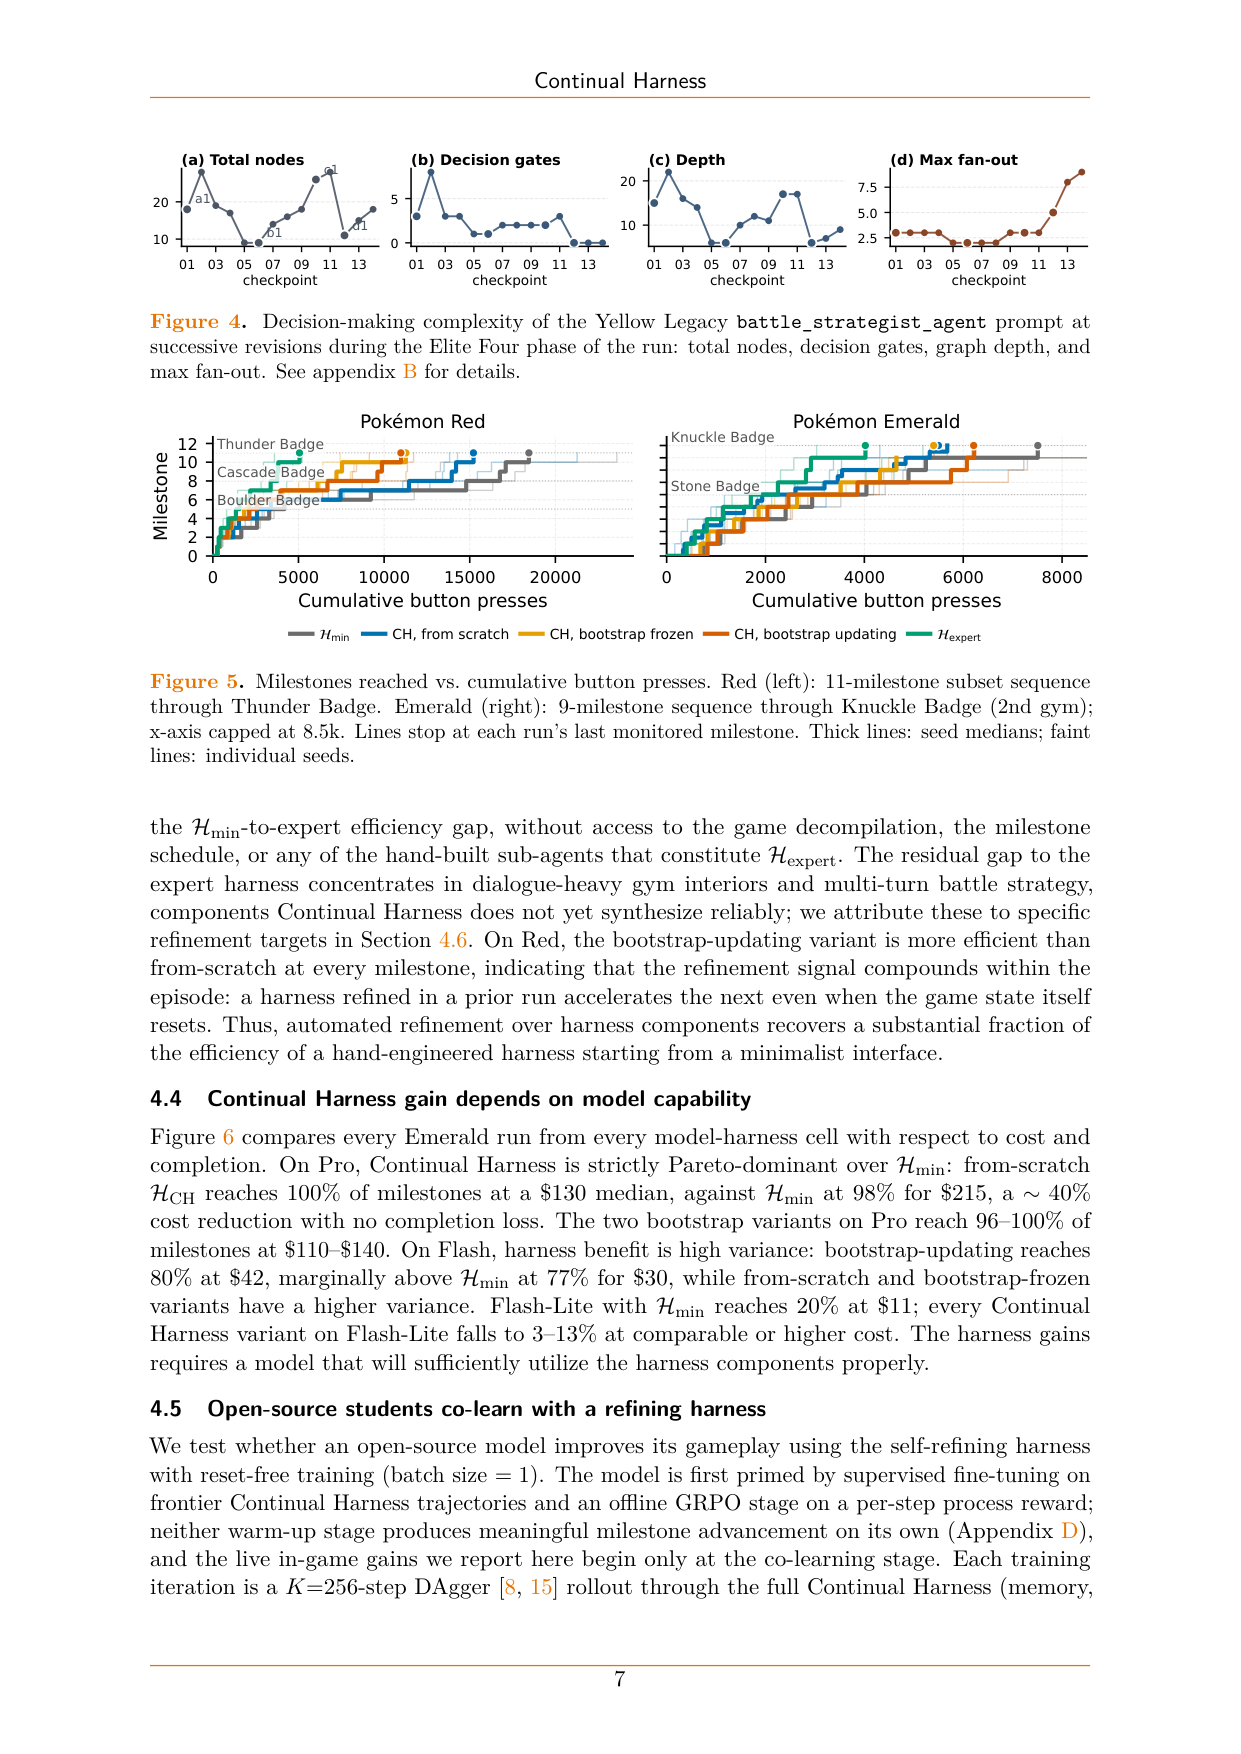
但收益高度依赖模型能力:Flash 上 bootstrap-updating 80% @ $42(H_min 77% @ $30,高方差);Flash-Lite 上 H_min 20% @ $11,而所有 CH 变体只有 3–13%——能力地板之下,自改进反而拖后腿。论文还给了机制层面的直接证据:导航技能的路径代价相对 Dijkstra oracle 从接近一半降到个位数,H_min 从不调用导航技能,而 CH 的 from-scratch run 在 24 小时内累积数百次调用并持续修复。
关键结果二:harness 与权重共学,reset-free 训练
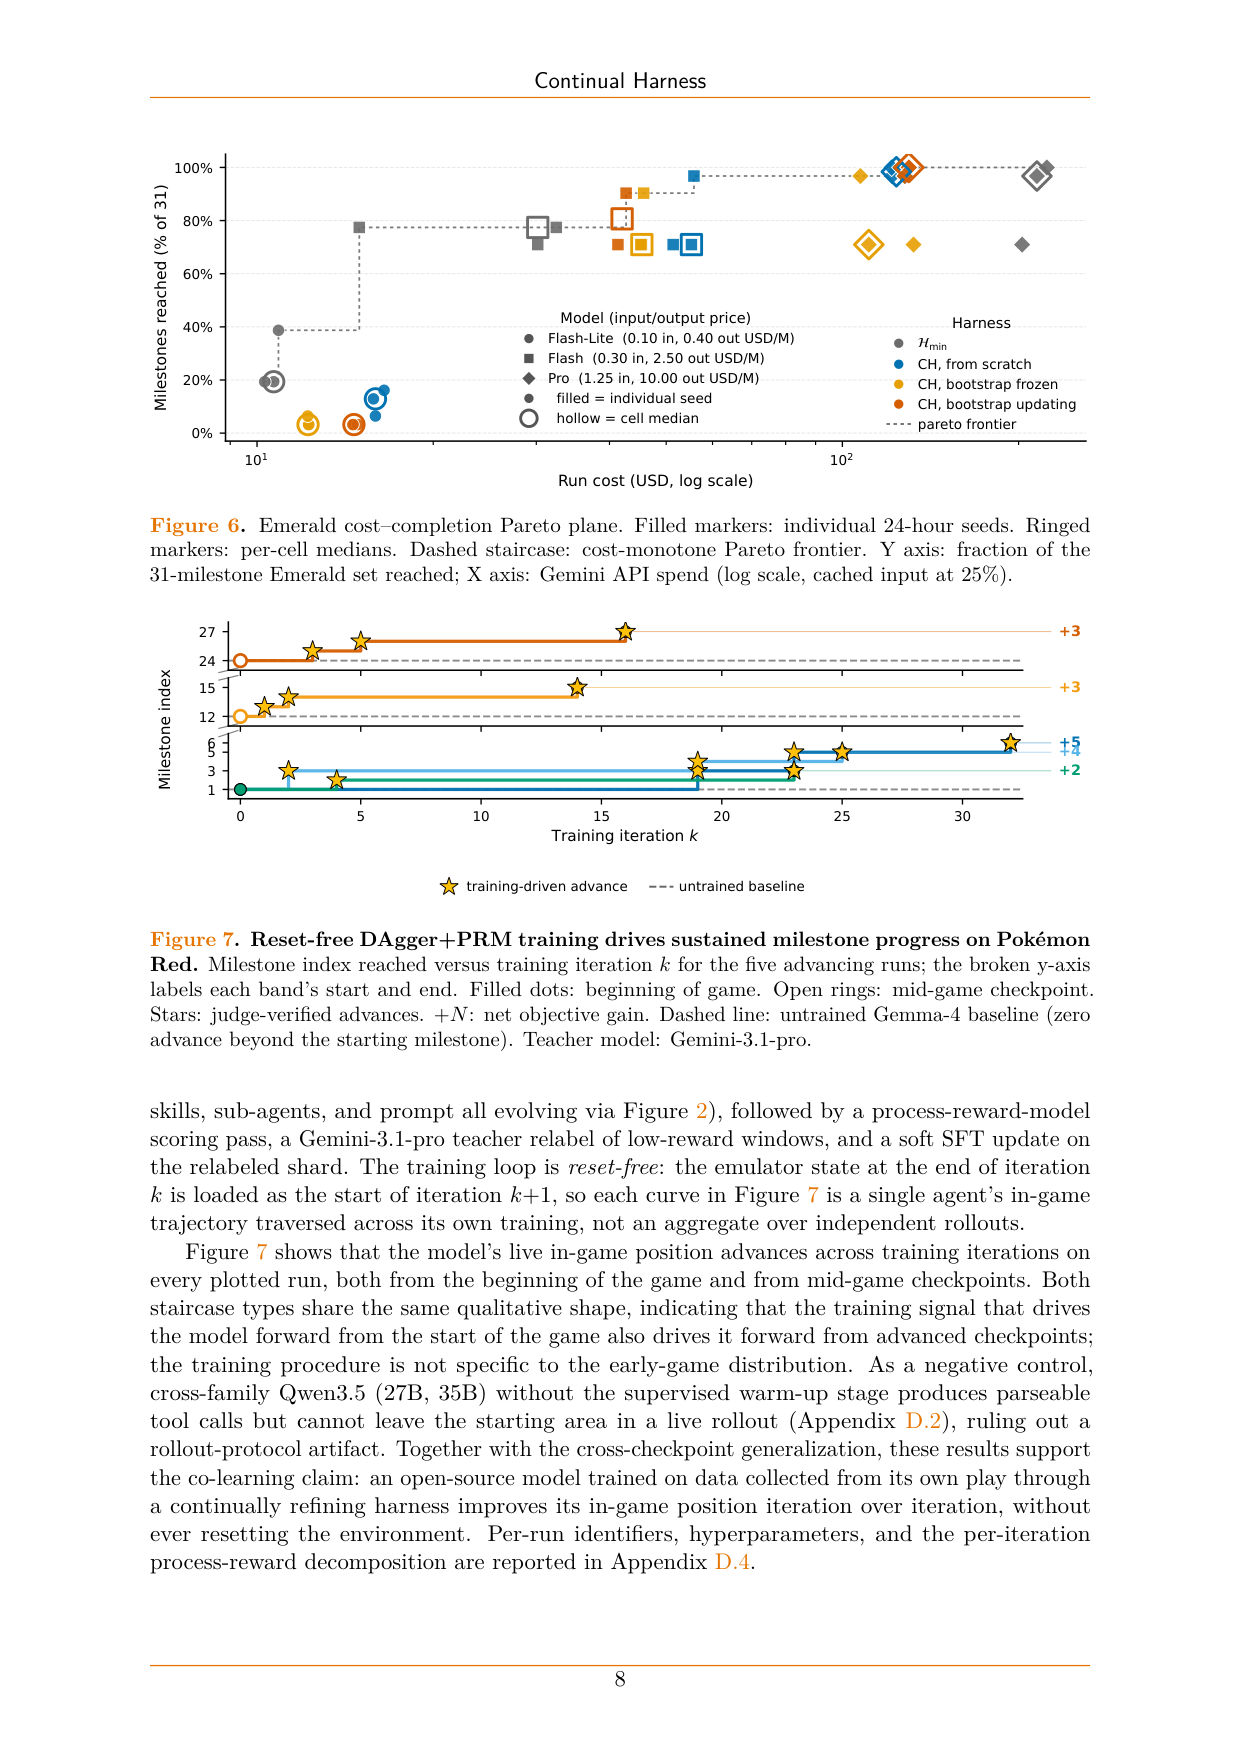
训练侧把「精化 harness」与「更新权重」接进同一个循环:每个迭代,Gemma-4 在实时精化的 harness 里跑 $K=256$ 步 DAgger rollout,pairwise PRM 给逐转移打分,低奖励窗口由 Gemini-3.1-pro 教师重标注,再做 soft SFT(LoRA,lr $5\times10^{-6}$,3 epochs,batch size 1)。reset-free 体现在 emulator 状态:迭代 $k$ 结束时的存档直接作为迭代 $k+1$ 的起点,模型在游戏里的位置跨训练累积。结果:5 条运行(从开局与中途 checkpoint 出发)全部跨迭代推进里程碑(净进展 +2~+5,judge 验证),未训练的 Gemma-4 基线零进展;无 SFT warm-up 的跨族对照 Qwen3.5(27B/35B)只会发工具调用、离不开出生点——排除了 rollout 协议伪影。
局限与边界
GPP 阶段还留下了量化证据:Yellow Legacy 运行里,技能与子代理的 CRUD 操作贯穿整个 run、持续到 20 万步量级而没有收敛到固定脚手架,且更新高度集中在一小组导航与战斗组件上(pathfinder、battle_strategist_agent 等);battle_strategist_agent 的 prompt 在 Elite Four 阶段反复经历增长与精简的循环,还发生过一次把逐决策逻辑吸收进 master_battle_agent 的结构性重写。这些是「持续精化而非一次定型」的直接证据,也是 Continual Harness 自动化流程要复刻的行为模式。
局限与边界
论文自承三条:能力地板(Flash-Lite 下 CH 全输给 H_min);共学依赖前沿教师(Gemma-4 ≤31B 不能同时当 teacher 和 trainee);共学未饱和(只报了训练窗口内的进展,没有收敛点,reset-free vs reset 的对比也没做)。我们补三条读出:评估局限在单一游戏的两作里,跨环境迁移性未证;$130/$215 这类成本含 Gemini API 价格,波动会扰动结论;PRM 是 pairwise 启发式打分(权重在附录),弱 PRM 会让教师重标注的选择有偏。
一句话记住这篇
Continual Harness 把 GPP 的人类打磨循环自动化成 reset-free 在线自改进:Refiner 每隔 F 步对 prompt/子 agent/技能/记忆做 CRUD,Gemini 3.1 Pro 从零自举在 Emerald 上 100% 里程碑 @ $130 vs H_min $215;再用 DAgger+PRM+教师重标注让 Gemma-4 权重与 harness 联合共学。最该记住的是它的边界条件:Flash-Lite 下所有自改进变体都低于最小 harness——harness 进化是放大器,不是发动机。
Continual Harness 把 Gemini Plays Pokémon(GPP)里的人类人工打磨 harness 循环自动化成 reset-free 的在线自改进:agent 与 Refiner 交替,Refiner 每隔 F 步对 prompt/子 agent/技能/记忆做 CRUD 编辑。在 Pokémon Red/Emerald 上,Gemini 3.1 Pro 从零自举达到 100% 里程碑、成本约 $130 vs 最小 harness 的 $215(约 −40%),收复大部分与专家 harness 的差距;再用 DAgger+PRM+前沿教师重标注实现『harness 与权重共学』,让开源 Gemma-4 在 Red 上跨训练迭代持续推进里程碑。
问题
要解决什么:coding agent 有 Claude Code/OpenHands 这类成熟 harness,但具身 agent(部分可观测、长时程决策)没有对应的自改进 harness;同时现有 prompt 优化方法每轮要重置 episode,无法覆盖只在游戏深处出现的失败。作者把 GPP 人类打磨 harness 的经验形式化,做成 reset-free 的自动循环,并进一步让模型权重参与共学。
为什么 prior work 不够:PokeAgent Challenge 报告无领域 scaffolding 的前沿 VLM 在 RPG 上几乎零进展;GEPA 等 prompt 优化方法在完整 episode 间更新、每轮重置到初始状态,既浪费又够不到 late-game 失败;专家 harness(PokeAgent/固定 GPP)需要大量人工搭建,且不随模型进化。
进化循环(搜索空间 → 算子 → 评估 → 选择)
搜索空间(什么被进化):完整 harness 状态 H = (p, G, K, M):system prompt p、子 agent 定义 G、技能库 K(文本启发式 + 可执行程序)、记忆 M(跨轨迹累积的事实/策略/观察);meta-tool API(define_agent / run_code / process_memory 等)固定;环境接口(帧 ot + ASCII 地图 mt + 按键动作 A)只读;模型权重在推理侧固定、在 co-learning 侧可更新。
变异/提案算子:
- 内循环:agent 读 (st, Ht, τt) 输出动作 at
- 外循环:每 F 步(warm-up W 后)Refiner 读最近轨迹窗口 τ_{t−F:t} 找失败签名(导航循环、工具调用失败、目标停滞、漏探索),跑四趟 CRUD——重写 prompt、增删改子 agent、固化/修复技能、增改降权记忆
- 编辑就地生效:H_{t+1} = H_t ⊕ Δ,不重置环境;失败签名单调累积供后续所有 refinement pass 使用
- co-learning:每迭代 K=256 步 DAgger rollout → pairwise PRM 打分 → 低奖励窗口由 Gemini-3.1-pro 教师重标注 → soft SFT(LoRA,lr 5×10⁻⁶,3 epochs)更新 θ
评估方式:PokeAgent Challenge 标准里程碑评估,主指标 = 累计按键数到里程碑;Pokémon Red(11 里程碑子集)/ Emerald(9 里程碑);Gemini 3.1 Pro/Flash/Flash-Lite × 至少 3 seeds,报 seed median;导航技能用 Dijkstra oracle 对比路径代价;co-learning 用净里程碑进展(judge 验证)。
选择与归档:无显式 fitness 淘汰:编辑以 CRUD 形式累积,被 Refiner 判定失败的机制在下轮修复,长期未调用组件被删除;bootstrap 变体继承先前成功 run 的 harness(冻结或继续 refinement);co-learning 用低奖励窗口筛选 + 教师重标注作为选择信号,reset-free 保存/加载 emulator 状态。
自我改进程度:L1→L2:推理侧是 L1(固定模型 + harness 自进化);co-learning 侧同时更新 Gemma-4 权重与 harness 状态,达到 L2 的『harness 与权重联合优化』——但权重更新由前沿教师重标注驱动,模型自身不自主选择更新策略。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|
输出
| 名称 | 类型 | 说明 |
|---|
数据集
| 数据 | 规模 | 备注 |
|---|
架构(摘要)
主干与结构
backbone:
参数:
类型:
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| Emerald 里程碑达成率与成本(Gemini 3.1 Pro,seed median) | from-scratch HCH 100% 里程碑 @ $130;Hmin 98% @ $215(约 −40% 成本) | Hmin(最小 harness);Hexpert 为专家上限参考 | 31 里程碑 Emerald 集,24h seed,API 价格 Pro $1.25 in/$10 out per M;bootstrap 变体 96–100% @ $110–140 |
| 模型能力依赖(Emerald cost-completion Pareto) | Pro 上 CH 严格 Pareto 支配 Hmin;Flash bootstrap-updating 80% @ $42 vs Hmin 77% @ $30(高方差);Flash-Lite 上 Hmin 20% @ $11、所有 CH 变体 3–13% | Hmin 各模型自身表现 | Gemini 3.1 Pro/Flash/Flash-Lite,至少 3 seeds;能力地板:弱模型利用不了 harness 组件 |
| 导航技能路径代价(vs Dijkstra oracle) | path-cost deficit 从接近一半降到个位数并保持(24h from-scratch run) | Dijkstra oracle 0% 缺陷;Hmin 从不调用导航技能 | Gemini 3.1 Pro,warp-to-warp 障碍导航任务;Refiner 在同 episode 内诊断并修复技能 |
| 开源模型共学(Pokémon Red,milestone 净进展) | 5 条运行全部跨训练迭代推进(净进展 +2~+5,judge 验证) | 未训练 Gemma-4 零进展;无 warm-up 的 Qwen3.5(27B/35B)无法离开出生点 | Gemma-4(E2B/E4B/26B MoE/31B);每迭代 K=256 步 DAgger + pairwise PRM + Gemini-3.1-pro 重标注 + soft SFT(LoRA, lr 5×10⁻⁶, 3 ep, batch=1);reset-free 存/载 emulator 状态 |
Insights
- reset-free 是方法论的支点:失败签名单调累积、编辑在 episode 内持续生效,能触及只在深局出现的失败(late-game 战斗、多步谜题、对话链),这是 reset-based 方法结构上够不到的(§3.2)
- harness 收益有模型能力地板:Flash-Lite 下所有 CH 变体反被拖累(3–13% vs Hmin 20%),说明 harness 组件需要模型有足够能力去利用(§4.4/§6)
- 技能可测量地逼近 oracle:导航技能的路径代价从近半缺陷降到个位数,且 bootstrap-updating 全程不差于 bootstrap-frozen——继承之上继续精化仍有价值(§4.6)
- GPP 完成记录是『emergent continual harness』的证据:模型自建 press_sequence 原语、命名多阶段战斗策略(Operation Zombie Phoenix)、在 notepad 里写 Goldenrod 谜题真值表(§4.2)
vs 同类工作
- vs GEPA / prompt 优化:它们在完整 episode 间更新并重置;Continual Harness 在 episode 内、从部分轨迹窗口更新完整 harness 状态(p, G, K, M)
- vs PokeAgent / 固定专家 harness:Hexpert 需要人工搭建 pathfinding/type chart/伤害计算器;CH 从 Hmin(帧+地图+按键)自举并收复大部分差距
- vs STaR / self-training:co-learning 的轨迹来自『自己 + 实时精化 harness』的分布,SFT 前还有 SFT warm-up 与离线 GRPO 两阶段预热,且教师是前沿模型
局限
- 能力地板:Flash-Lite 下 CH 全部低于 Hmin,refinement loop 在弱模型上无法自举(论文自承,§6)
- co-learning 依赖前沿教师:重标注用 Gemini-3.1-pro,评估的 Gemma-4(≤31B)不能同时担任 teacher 与 trainee(论文自承)
- 共学未饱和:只报告训练窗口内的持续进展,没有建立收敛点;reset-free vs reset 的 head-to-head 未做(论文自承)
- 我们读出:评估局限在单一游戏(Pokémon 两作),跨环境迁移性未证;$130/$215 成本含 Gemini API 价格,波动会影响结论;bootstrapping 需要先有一次成功 run,冷启动成本未计入
- 我们读出:PRM 是 pairwise 启发式打分(组件权重在附录 D),弱 PRM 可能让教师重标注窗口选择有偏;refiner 与 agent 是同一模型,自我诊断能力(能否发现自己引入的回归)未被单独测量
可复现性
- code:项目网站 https://sethkarten.ai/continual-harness 公开;论文未附代码/权重仓库
- weights:Gemini 3.1 Pro/Flash/Flash-Lite;Gemma-4(E2B/E4B/26B MoE/31B dense)
- sim_benchmark:PokeAgent Challenge 里程碑评估(Pokémon Red / Emerald),BalatroBench 式固定 seed 协议
Continual Harness 架构:reset-free 双环(推理精化 + 训练共学)
Mermaid 数据流
flowchart TD
    ENV["环境\n(帧 ot + ASCII 地图 mt + 按键 A)"] -->|"观测 st"| AGT["Agent 模型 M\n读 (st, Ht, τt) 输出动作 at"]
    AGT -->|"at"| ENV
    ENV -->|"轨迹 τ"| AGT
    AGT -->|"每 F 步(warm-up W 后)"| REF["Refiner(同一模型 M)\n读 τ_{t−F:t},找失败签名"]
    REF -->|"四趟 CRUD:Δp / ΔG / ΔK / ΔM"| H["harness 状态 H = (p, G, K, M)\nprompt · 子 agent · 技能 · 记忆"]
    H -->|"H ← H ⊕ Δ 就地生效"| AGT
    H -->|"meta-tool API:\ndefine_agent / run_code / process_memory"| REF
    H -->|"(训练侧)live-refining 环境"| RL["co-learning 迭代 k\nK=256 步 DAgger rollout"]
    RL -->|"轨迹 τ"| PRM["pairwise PRM 打分"]
    PRM -->|"低奖励窗口"| TEACH["Gemini-3.1-pro 教师重标注"]
    TEACH -->|"relabeled shard"| SFT["soft SFT\n(LoRA, lr 5e-6, 3 ep)"]
    SFT -->|"θ_{k+1}"| RL
    RL -->|"reset-free:迭代末 emulator 存档\n作为下轮起点"| RL
组件详解
- 最小环境接口:观测 = 渲染帧 + 局部 ASCII 地图(从画面可读的游戏状态生成)+ 固定按键集;无 walkthrough、无目标列表、无 pathfinding。部分可观测性来自 agent 看不到 NPC 意图与战斗机制内部。
设计要点- **成本口径**:Pareto 平面的横轴是 Gemini API 花费(含缓存输入 25% 折扣),里程碑达成率按 31 里程碑全集计算——成本数字随 API 定价波动,比较时要固定价格表。
设计要点
- GPP 量化参照:Yellow Legacy 运行中 CRUD 更新持续到 20 万步量级且集中于少数导航/战斗组件;battle_strategist_agent 的 prompt 在 Elite Four 阶段反复增长-精简,并发生一次结构重写——这是「持续精化」的经验底座,CH 的 Refiner 流程就是它的自动化版本。
设计要点
1. 同一拓扑、换 refiner:图 1 三范式(人 / 自动 / 共学)共享环境-agent-harness-refiner 结构,自动化的关键是让 LLM 承担「读轨迹、改 harness」。
2. reset-free 是支点:编辑在 episode 内累积、深局失败可被触及;bootstrap 变体证明精化信号跨 run 继承。
3. 能力地板:Flash-Lite 下 CH 全输给 H_min——harness 是放大器,弱模型利用不了组件。
4. 共学有前置依赖:SFT warm-up + 离线 GRPO 两阶段预热是 live 增益的前提,且教师必须是更强的模型。
方法论总览:episode 内 harness 精化 + 跨迭代共学
原文 caption:Methodology overview. (a) Harness refinement within one episode: the Agent reads (st, H, τ) and emits at; every F steps the Refiner reads τ_{t−F:t}, emits per-component edits Δ = (Δp, ΔG, ΔK, ΔM) via the meta-tool API, and H ← H ⊕ Δ. (b) Co-learning across DAgger+PRM iterations: each iteration runs πθk inside a live-refining Ht for K=256 steps. The trajectory is scored by a pairwise PRM, low-R windows are relabeled by Gemini-3.1-pro, and a soft SFT update produces θk+1. The loop is reset-free.
全篇机制图:(a) 说明『agent 行动 / Refiner 编辑』交替在同一个 episode 内进行,harness 状态 H=(prompt, 子 agent, 技能, 记忆) 是共同读写对象;(b) 说明训练侧 DAgger+PRM+教师重标注如何更新权重。读图抓两点:两图共享同一拓扑(环境- agent - harness - refiner),以及两条虚线边界——推理内循环不重置,训练外循环也 reset-free。
三种范式:人在环、自改进 harness、模型+harness 共学
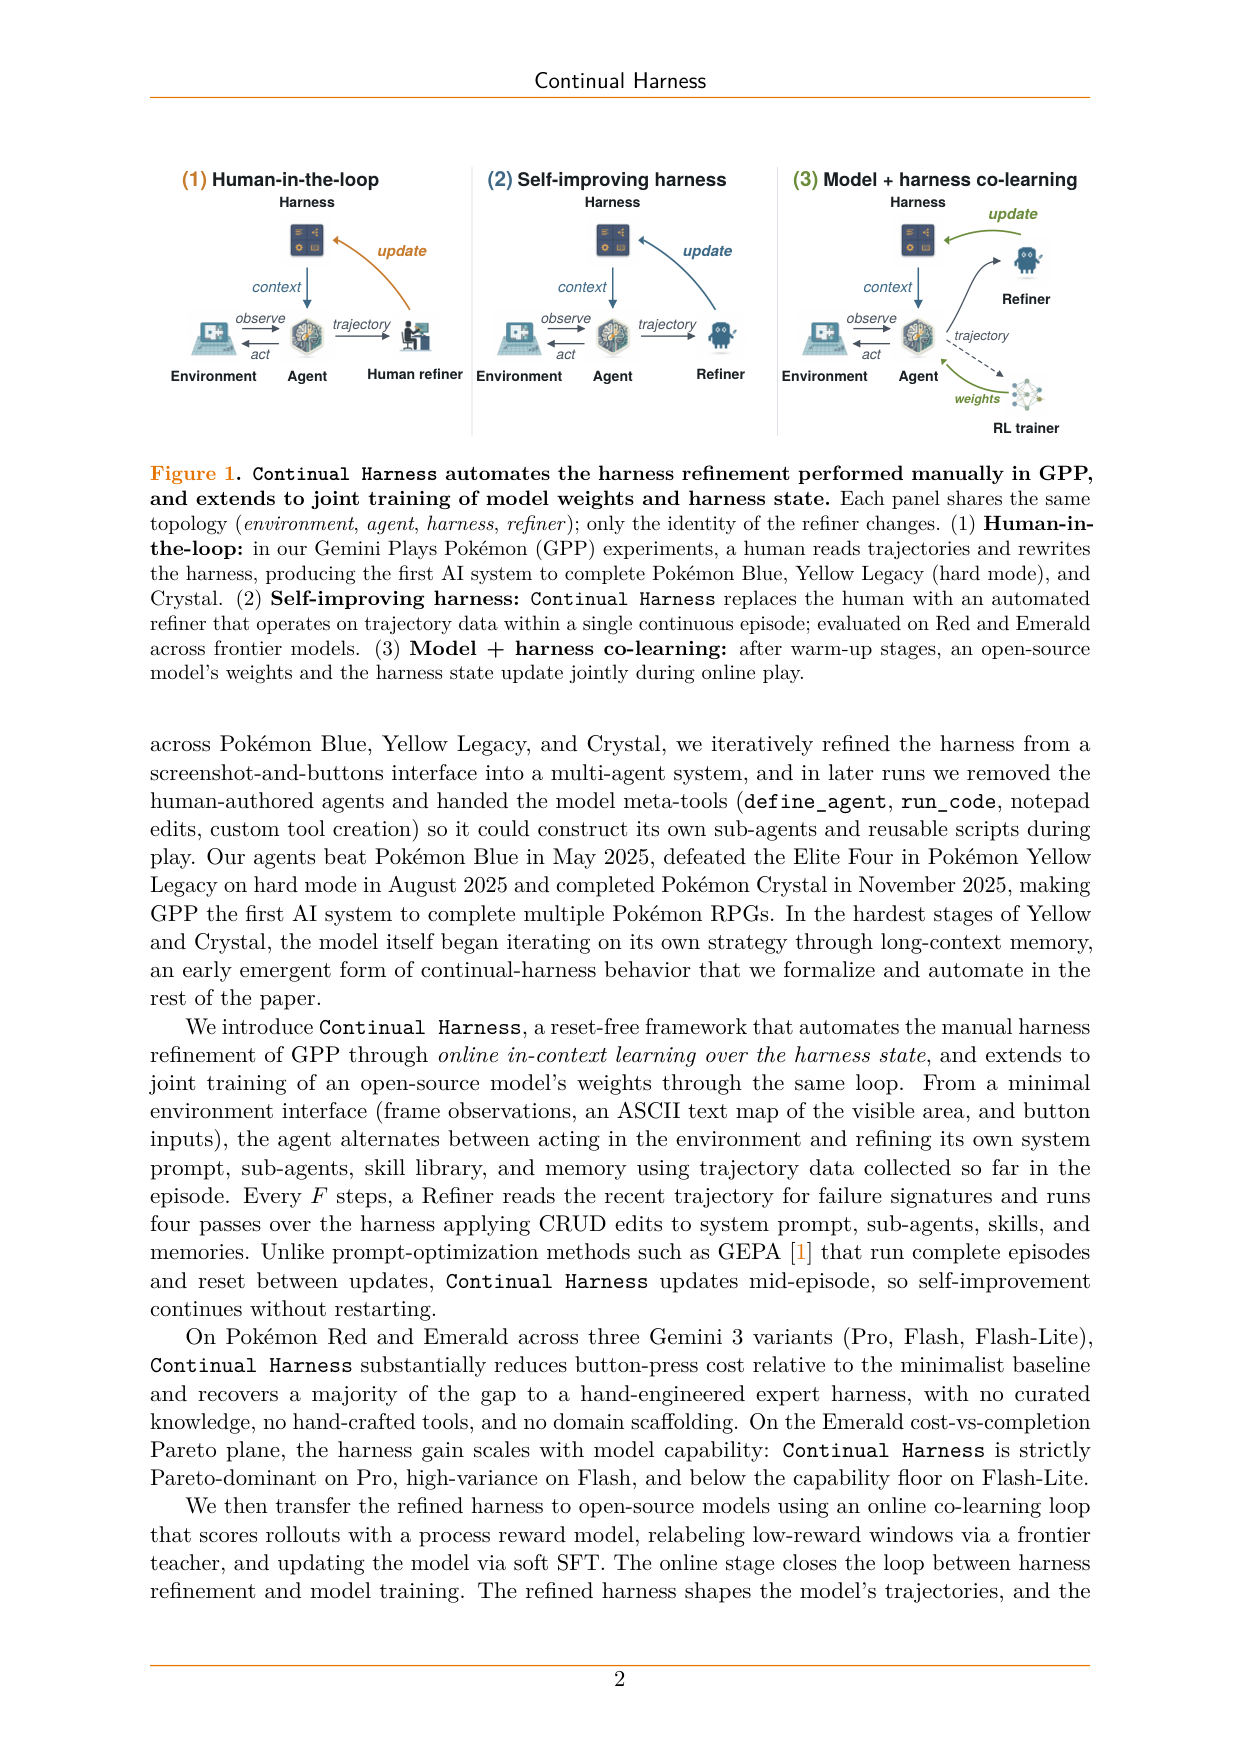
原文 caption:Continual Harness automates the harness refinement performed manually in GPP, and extends to joint training of model weights and harness state. Each panel shares the same topology (environment, agent, harness, refiner); only the identity of the refiner changes.
把论文放进连续谱:GPP(人类做 refiner,打通 Blue/Yellow Legacy/Crystal)→ Continual Harness(LLM Refiner 自动做)→ 共学(RL trainer 也参与)。读图理解『refiner 身份是唯一变量』:拓扑完全一致,自动化的关键是把『读轨迹、改 harness』这个动作交给模型,这也是论文声称的先例基础。
Red/Emerald 上里程碑 vs 累计按键:CH 收复大部分专家差距
原文 caption:Milestones reached vs. cumulative button presses. Red (left): 11-milestone subset sequence through Thunder Badge. Emerald (right): 9-milestone sequence through Knuckle Badge. Lines stop at each run's last monitored milestone. Thick lines: seed medians; faint lines: individual seeds.
主结果:从零自举的 CH 曲线明显在 Hmin 左侧(更少按键到同一里程碑),且大部分区间贴近 Hexpert;bootstrap-updating 在 Red 上每个里程碑都比 from-scratch 更省——证明『已精化 harness 跨 run 继承』有效。读图注意残余差距集中在道馆内部对话与多回合战斗,这是论文自己归因的短板。
reset-free DAgger+PRM 训练驱动持续里程碑进展
原文 caption:Reset-free DAgger+PRM training drives sustained milestone progress on Pokémon Red. Milestone index reached versus training iteration k for the five advancing runs; filled dots: beginning of game; open rings: mid-game checkpoint; stars: judge-verified advances. Dashed line: untrained Gemma-4 baseline (zero advance).
证明权重共学有效:每条曲线是一个 agent 单条 in-game 轨迹跨训练迭代推进(净进展 +2~+5),从开局与中途 checkpoint 出发都能推进;未训练 Gemma-4 baseline 零进展。读图同时看反例:无 SFT warm-up 的跨族 Qwen3.5(27B/35B)只能发工具调用、离不开出生点,排除 rollout 协议伪影。
Continual Harness:不重置的自我改进——通关宝可梦的 AI 是怎么学会改自己的(对话版)
小播:今天聊一篇又好玩又硬核的论文——AI 玩宝可梦玩通了三个世代,然后把「人类帮它改攻略」这件事变成了自动化。
老播:对,普林斯顿和谷歌 DeepMind 的团队,两个故事连在一起。第一个故事:他们的 Gemini Plays Pokémon 项目,人工打磨 AI 的玩法框架,第一个通关了宝可梦蓝、黄(困难模式)和水晶。第二个故事:把「人工打磨」这个循环自动化,叫 Continual Harness——agent 一边玩游戏一边改自己的框架,不用重置游戏。更狠的是,他们还让开源模型的权重一起参与学习。
小播:先等等,为什么拿宝可梦当测试?
老播:因为它是典型的具身长时程决策:画面部分可观测、一个任务要几万步、目标没有写在明面上。之前 PokeAgent Challenge 报告过,没有领域脚手架的前沿视觉语言模型在这类游戏上几乎零进展。而 coding agent 有 Claude Code 那种成熟框架,具身 agent 没有——这篇就是来补这个空白的。
第一段:问题——打磨框架为什么要自动化
小播:先讲第一个故事,人工打磨是什么样?
老播:他们的 GPP 项目,起点很朴素:一张游戏截图、一片 ASCII 地图、一组按键。人类在旁边看直播,发现 agent 卡在哪个道馆,就给它加一条提示、写一个子代理、存一条记忆。就这么一点点磨,磨出了通关三个世代的结果。
小播:那自动化之后呢?
老播:核心是把「人读轨迹、改框架」换成模型自己做。框架拆成四块:系统提示词、子代理、技能库、记忆。agent 正常玩,但每隔固定步数,一个叫 Refiner 的角色读最近一段轨迹,找失败特征——导航绕圈、工具调用失败、目标停滞——然后对四块做增删改查:重写提示词、新建或删除子代理、把成功的操作固化成技能、往记忆里写事实。
小播:这个循环和以前的自动改提示词有什么区别?
老播:最大的区别是三个字:不重置。以前的提示词优化方法,跑完一整局才更新,更新完从初始状态重开——每一局的失败经验都要重新积累。Continual Harness 在游戏中途就改,改完继续玩,失败特征跨轮次累积,所有后面的修改都能看到前面的失败。这样才够得到只在游戏深处出现的失败——后期道馆、多步谜题,这些重置式方法结构上就够不到。
第二段:机制——两个循环,推理侧和训练侧
小播:那「一边玩一边改」具体怎么工作?
老播:推理侧是一个双环:内环是 agent 正常行动,外环是 Refiner 每隔 F 步做一轮编辑。框架状态是四块拼起来的,编辑就是替换提示词、给另外三块做增删改查,改完下一拍就生效。注意 Refiner 和 agent 是同一个模型,只是被调用的时机和上下文不同。
小播:那训练侧呢?你说权重也参与了。
老播:训练侧是另一个循环,叫共学。每一步,开源模型在「实时进化的框架」里跑 256 步的轨迹,一个过程奖励模型给逐转移打分,低分窗口交给一个前沿模型教师重标注,再用软 SFT 更新模型的 LoRA。关键还是不重置:这一轮的存档直接当下一轮的起点,模型在游戏里的位置跨训练累积。所以你会看到一条条从开局出发、随着训练轮次一路推进里程碑的曲线。
小播:那效果到底怎么样?数据呢?
老播:推理侧,拿 Gemini 3.1 Pro 在宝可梦绿宝石上比:从零自举的 Continual Harness 打到 100% 的里程碑,中位成本约 130 美元;最小框架只能到 98%,花 215 美元——省了约 40% 的成本。对照专家框架是人工搭的、带寻路和伤害计算器,CH 收复了它和最小框架之间的大部分差距。导航技能还有更硬的证据:跟最短路算法对比,CH 自己进化出的寻路技能,路径代价从接近一半的缺陷降到个位数。
小播:那开源模型那边呢?
老播:训练侧用 Gemma-4 系列,从零开始,5 条运行全部跨训练迭代推进里程碑,净进展从 2 到 5 个里程碑,有裁判验证;未训练的基线零进展。对照组是跨家族的 Qwen3.5,没经过监督预热,只会发工具调用,离不开出生点——排除了「这是 rollout 协议本身的假象」这种解释。
第三段:关键结果——能力地板与依赖
小播:听起来很顺,有没有翻车的地方?
老播:有,而且论文自己写得很直白:模型能力有个地板。Gemini 的 Flash-Lite,最便宜的型号,最小框架能打到 20% 里程碑、花 11 美元;但所有 CH 变体反而只有 3% 到 13%,花的钱差不多甚至更多。也就是说,自改进框架是放大器——模型太弱,放大的是噪声而不是能力。
小播:那训练侧的依赖呢?
老播:共学高度依赖前沿教师。重标注用的是 Gemini 3.1 Pro,而他们评估的开源模型最大 31B,当不了自己的老师——「自己教自己」这个闭环还没成立。另外作者承认共学没有跑到收敛,只报了训练窗口内的持续进展,不知道最后能到哪。
小播:还有什么要打折读的?
老播:我们补三条。一是评估局限在宝可梦这一个游戏的两作里,跨环境迁移性没证。二是成本数字含 API 价格,130 对 215 美元会随价格波动。三是过程奖励模型是成对打分的启发式,权重放附录里——如果它打分不准,教师重标注选出来的窗口就会有偏。还有一条工程细节:bootstrap 变体要先有一次成功的从零运行来继承框架,这个冷启动成本没算进账里。
收尾:一句话记住这篇
小播:最后用一句话总结?
老播:Continual Harness 把「人类帮 AI 打磨玩法框架」自动化成不重置的在线自改进——agent 玩着玩着自己改提示词、子代理、技能和记忆,Gemini 3.1 Pro 从零自举在绿宝石上 100% 里程碑、成本 130 美元对最小框架的 215 美元;再用过程奖励加教师重标注,让开源模型 Gemma-4 的权重和框架一起进化。
小播:最该记住的数字呢?
老播:Flash-Lite 那条:最小框架 20% 里程碑、11 美元,所有自改进变体 3% 到 13%。这个数字比 130 对 215 更值得记——它划出了自改进的适用边界:harness 进化是放大器,不是发动机;模型能力不够,越改越差。