GEPA:让 LLM 用自然语言反思自己的失败,然后进化提示
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。
先看一个现象:现在给大模型适配新任务,主流路线是 RL——GRPO 这类方法把「答对没答对」压成一个标量奖励,再算策略梯度更新权重。好用,但贵:业界跑 GRPO 常常要数万次 rollout。这篇 ICLR 2026 Oral 论文(GEPA,伯克利/斯坦福等)提出一个对比鲜明的判断:LLM 跑出来的东西本来就是自然语言——推理链、工具调用、编译器报错——为什么要把这些信息压成一个数字再学?直接在语言里反思、在语言里改提示,样本效率能差一个数量级。
背景:rollout 是稀缺资源
GEPA 要优化的对象叫复合 AI 系统:一个由多个 LLM 模块 + 工具调用组成的工作流(检索、执行代码、多跳问答都算)。问题形式化成:在 rollout 预算 $B$ 内找最优提示集合:
$$\langle \Pi^{*}, \Theta^{*} \rangle = \arg\max_{\langle \Pi, \Theta \rangle}\; \mathbb{E}_{(x,m)\sim T}\, \mu\big(\Phi(x; \Pi, \Theta), m\big), \quad \text{s.t. } \#\text{rollouts} \le B$$
$\Phi$ 是系统,$\Pi$ 是所有模块的提示、$\Theta$ 是模型权重,$\mu$ 是评估指标(exact match、F1、pass rate 等),$T$ 是任务分布,$m$ 是评估元数据(gold 答案、rubric、单元测试)。这个式子同时允许优化提示和权重,好让 GEPA 和 GRPO 在同一个目标下比——比的是谁能在更少的 rollout 内逼近同样的 held-out 表现。
核心机制:反思式变异 + Pareto 前沿
先说清楚为什么「语言反思」能成立:rollout 被序列化后就是自然语言——每个模块的指令、推理链、工具调用、评估器的中间输出。现代 LLM 读得懂这些文本,所以反思模型可以替人做「哪个模块的哪句话导致了失败」的诊断,再产出具体的改写建议。这比策略梯度里那条稀疏的标量信号信息量大得多,代价是反射模型的判断质量本身要过关。
关键来了。GEPA 每一轮做三件事:选候选、反思变异、验证入库。候选从池子里按 Pareto 规则抽(下面讲);变异时,把候选放到一个小批量问题上执行,拿到轨迹和反馈函数 $\mu_f$ 返回的文本反馈——编译器错误消息、rubric 失败原因、逐 hop 的评估反馈——然后让一个 reflection LLM 看「当前提示 + 轨迹 + 分数 + 反馈」,把成败归因到具体模块,重写那个模块的提示。这是隐式 credit assignment:语言轨迹让「哪个模块背锅」变得可诊断。
为什么 Pareto 比追最优更稳?贪心(每次改当前最好的)第一次迭代后就会卡住。GEPA 的做法:对每个任务实例记下所有候选里最好的那个,得到实例级最优集合;去支配后,按「候选在多少个实例的最优集里出现」的概率随机采样下一个要进化的候选。这样搜索树同时朝多个方向的「赢家」分叉。
验证分两级:先在 minibatch 上比父代,改进了才在全验证集 $D_{\text{pareto}}$ 上评估并入池;否则丢弃。整个循环跑到预算 $B$ 用完,返回验证集上平均分最高的候选。
关键结果:35 倍更少的 rollout,六任务全面超过 GRPO
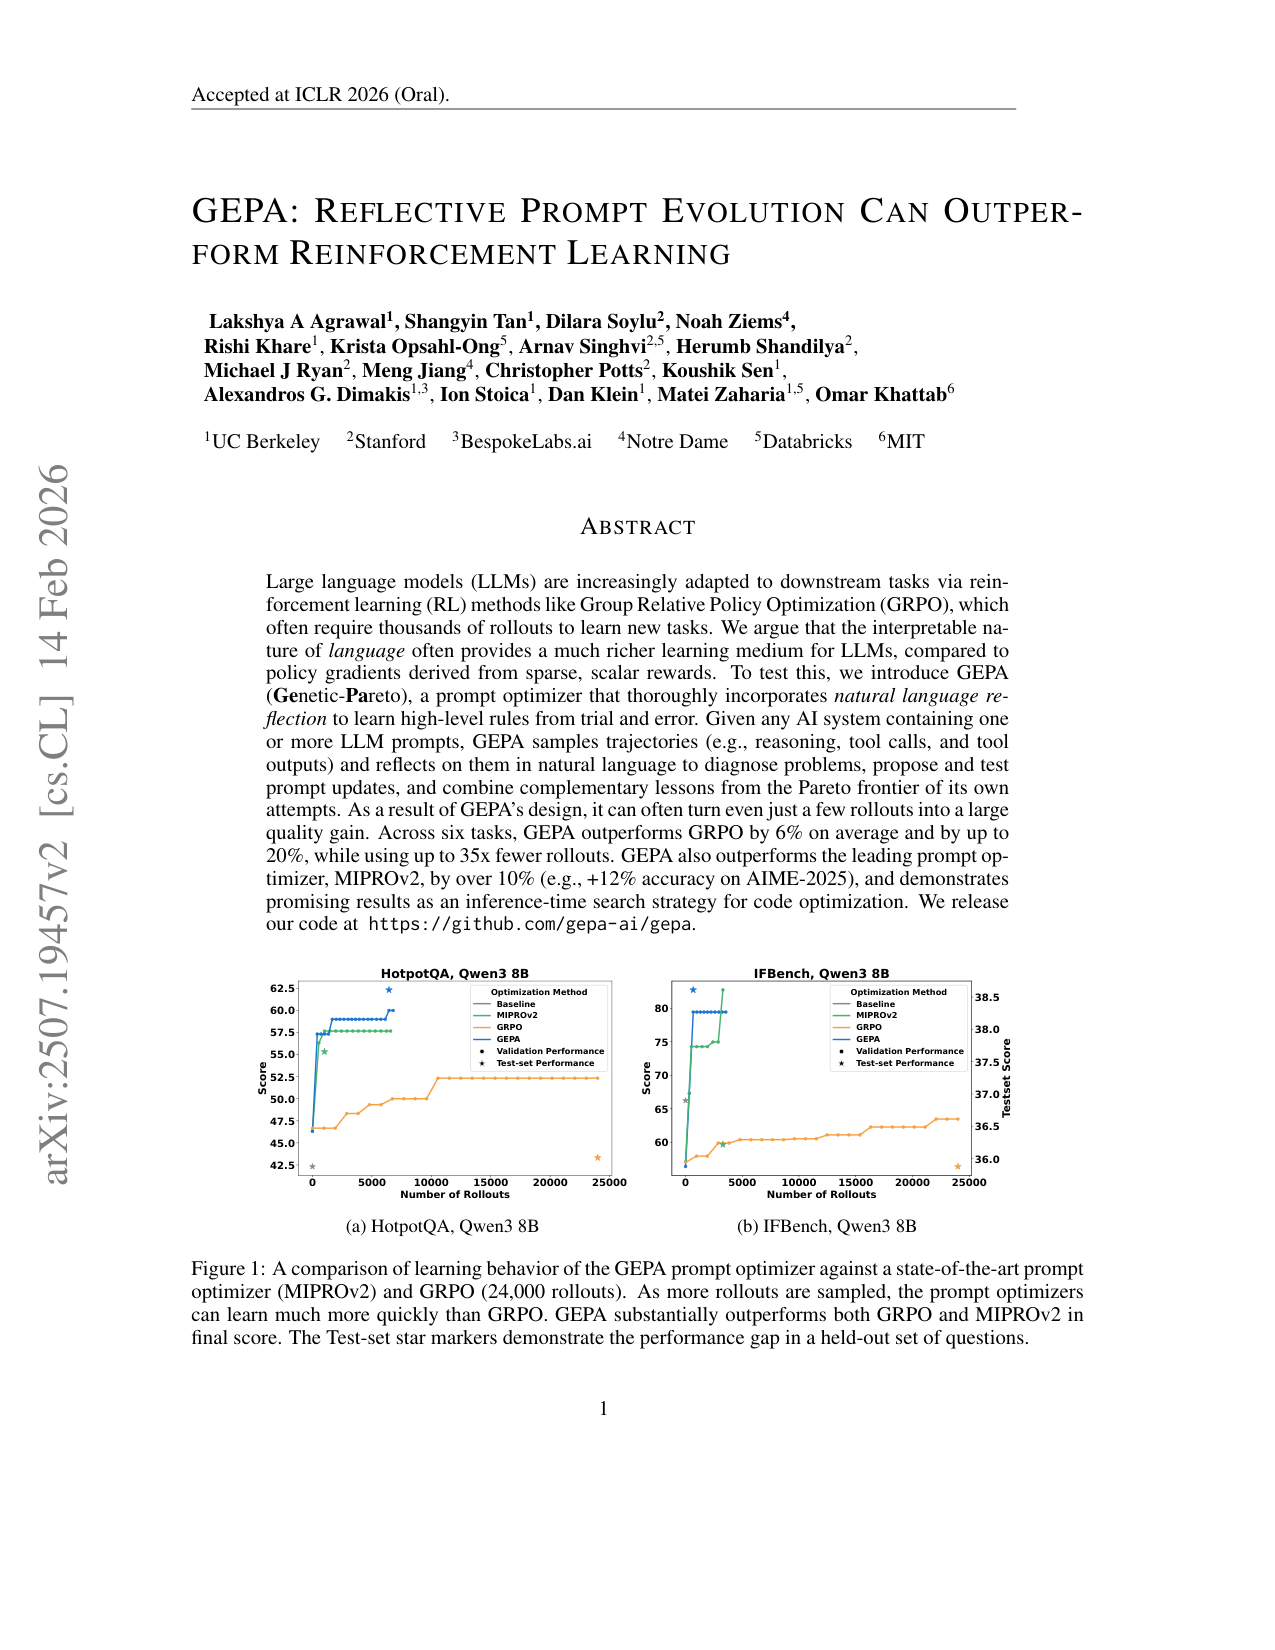
所有数字带 baseline 和 setup。Qwen3 8B 上六个任务(HotpotQA/IFBench/HoVer/PUPA/AIME-2025/LiveBench-Math):GEPA 聚合提升 +9.62 个百分点,GRPO(24,000 rollout/任务)+3.68,MIPROv2 +2.61;GEPA 的总预算每任务只有 1839–7051 次 rollout,最多 35 倍更少。单点看:HotpotQA 62.33 vs GRPO 43.33;IFBench 用 678 次 rollout 拿到 38.61%,GRPO 用 24,000 次只到 35.88%。闭源模型上更夸张:GPT-4.1 Mini 聚合 +12.19(GEPA)、+13.33(加 merge),MIPROv2 只有 +5.64;AIME-2025 上 GEPA 59.33 vs MIPROv2 51.33。
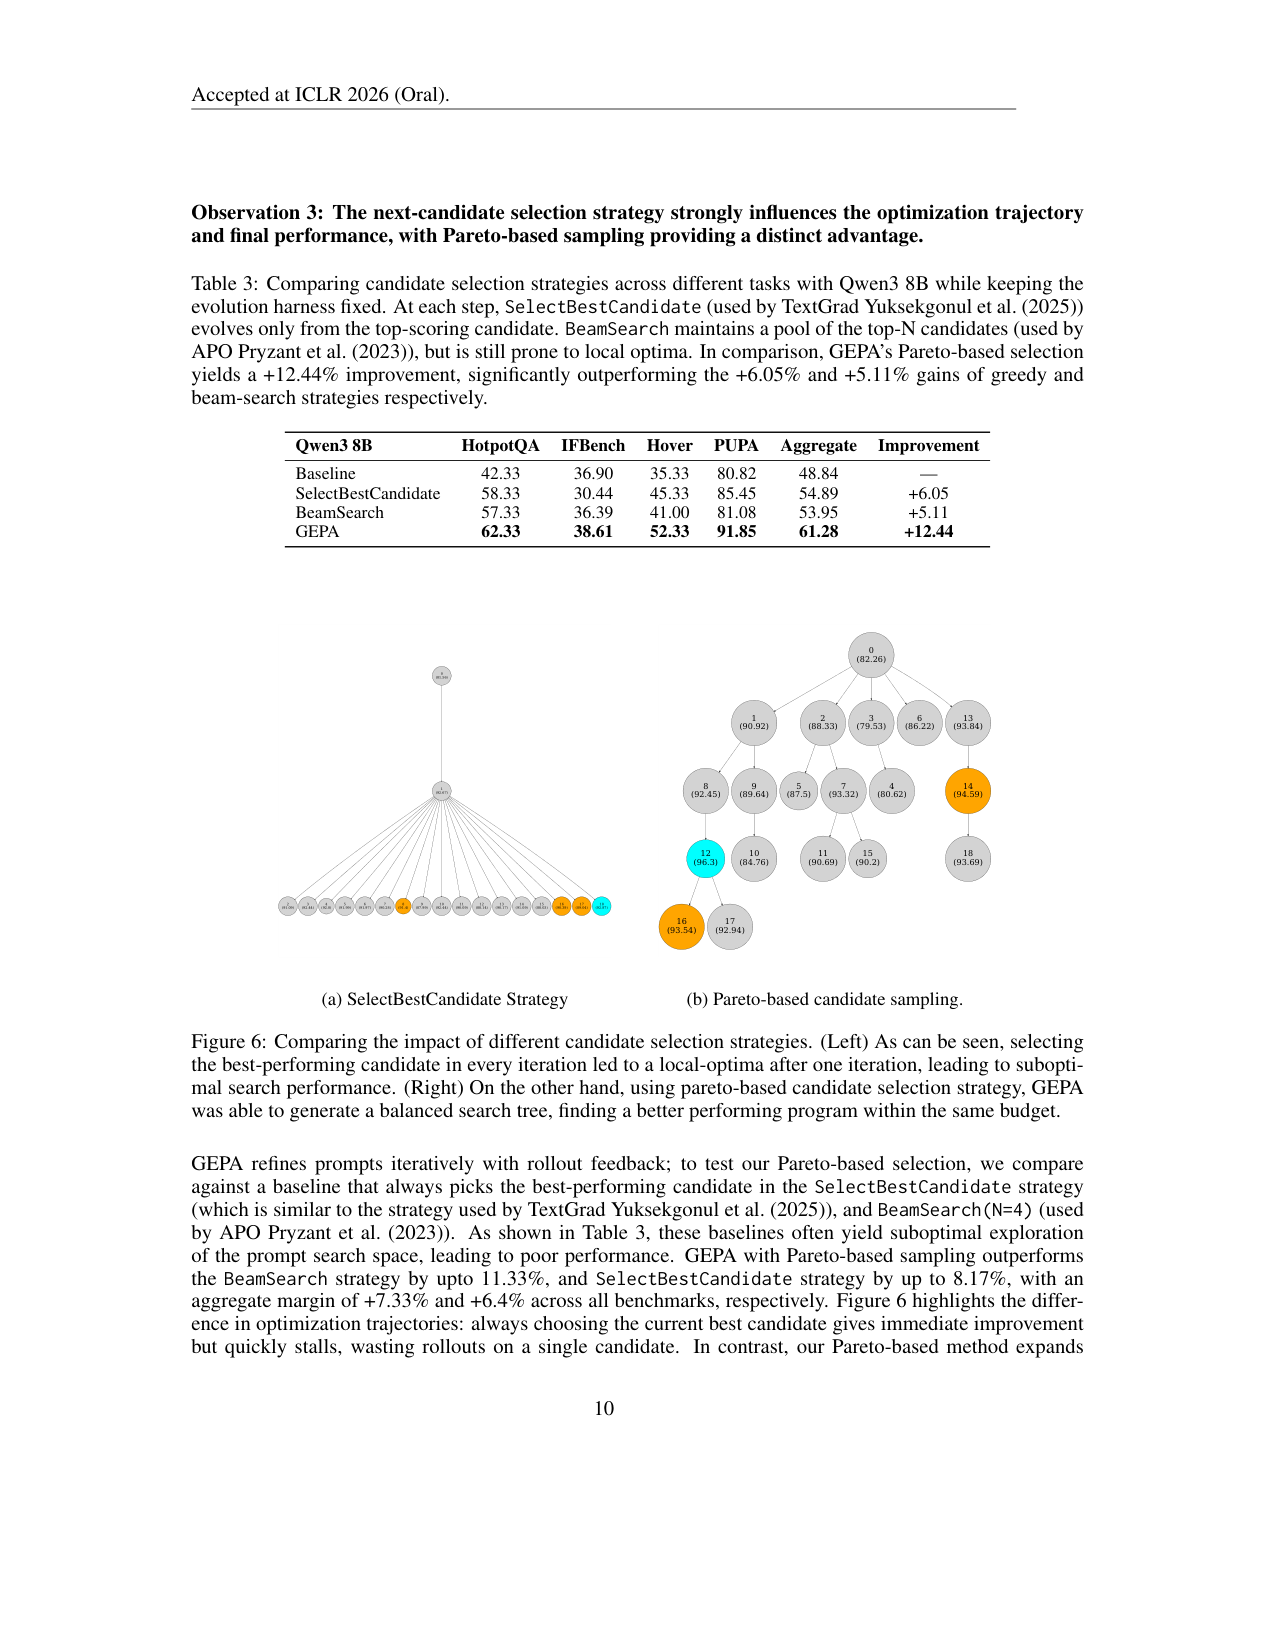
选择机制单独验证过:同一套进化 harness,只换候选策略,Pareto 采样 +12.44,SelectBest(TextGrad 式)+6.05,BeamSearch(N=4)(APO 式)+5.11——搜索轨迹的分叉宽度直接决定最终分数(Fig.6)。
GEPA 还能当 inference-time 搜索器用:AMD NPU 的 kernel 生成任务上(GPT-4o),进化出的提示把平均向量利用率从顺序精炼 agent 的 4.25% 拉到 30.52%(部分 kernel 到 70%),且不需要运行时 RAG;进化出的单条提示(Best-1)也有 26.85%。提示本身还短:比 MIPROv2 的 few-shot 优化结果最多短 9.2 倍,推理时省 token。
局限:数学推理仍是 RL 的主场
三条要认清。第一,AIME-2025(Qwen3 8B)上 GEPA 32.00,落后 GRPO 38.00——硬数学推理这种 reward 稀疏、验证明确的场景,权重 RL 仍然更强。第二,GEPA 依赖反馈函数 $\mu_f$ 给文本;评估者如果是 LLM,候选提示可能诱导出有利反馈,reward hacking 风险论文没有系统分析。第三,预算大多花在全验证集评估上(作者自承),真正用于学习的训练 rollout 每任务只有几十到几百次,样本效率的进一步提升要靠更小的验证集。另外候选池只增不减,长期运行没有淘汰规则。
一句话记住这篇
GEPA 把每一次 rollout 的轨迹和评估文本变成自然语言学习信号:反思式变异负责归因和改提示,Pareto 前沿负责绕开局部最优。最该记住的数字:IFBench 上 678 次 rollout 的 38.61%,对照 GRPO 24,000 次 rollout 的 35.88%;最该记住的边界:数学推理上 RL 仍占优,GEPA 的主场是带丰富文本反馈的复合系统。
把每一次 rollout 变成自然语言学习信号:GEPA 用轨迹与评估文本(编译器报错、rubric 失败)驱动反思式变异,用 Pareto 前沿按实例选择候选,在 Qwen3 8B 上以最多 35 倍更少的 rollout 超过 GRPO(HotpotQA 62.33 vs 43.33;IFBench 用 678 次 rollout 达 38.61% vs GRPO 用 24,000 次达 35.88%)。
问题
要解决什么:在 rollout 预算受限时优化复合 AI 系统(多 LLM 模块 + 工具调用的 workflow)的提示:如何从每个昂贵的 rollout 里榨出最多的学习信号。
为什么 prior work 不够:GRPO 等 RLVR 方法把结果压成标量奖励再估计策略梯度,需要数万次 rollout 才能适配新任务;贪心的提示优化(TextGrad 的 SelectBest、APO 的 BeamSearch)容易卡在局部最优。
进化循环(搜索空间 → 算子 → 评估 → 选择)
搜索空间(什么被进化):复合 AI 系统中各 LLM 模块的 system prompt 集合 ΠΦ(含指令与 few-shot 演示);模型权重 Θ 冻结只读,控制流 C 与评估器只读。粒度:逐模块提示,一次变异只改一个模块。
变异/提案算子:
- 反射式 prompt 变异:对选中候选在 minibatch 上执行、用反馈函数 µf 收集分数与文本反馈(含编译器错误、rubric 失败、逐 hop 反馈),reflection LM 归因成败到具体模块并重写其 prompt(round-robin 选模块)
- System-aware merge(交叉):按模块互补性组合两个候选——某模块只在 A 中进化过就取 A 的,反之取 B 的
- 论文未给出:反射 meta-prompt 自身的进化(反思机制固定)
评估方式:两级评估:先在规模 b 的 minibatch 上评估候选(改进才继续),改进后在全 Dpareto(npareto 个实例)上评估并记入候选池;预算 B 次 rollout 封顶。µf 在可用时返回模块级文本反馈。论文未给出:b 与 npareto 的敏感性分析、文本反馈质量的校验。
选择与归档:Pareto 前沿选择:对每个任务实例保留最优候选集合,去支配后按「候选出现在多少实例的最优集里」的概率采样下一个要进化的候选;候选池只增不减、保留祖先记录。论文未给出:候选池的淘汰/规模控制规则。
自我改进程度:L1(固定模型权重,进化提示):反射模型与演化模型同源,但反思与选择机制本身固定、未进化。论文未给出:反思机制改进自身的学习回路。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|
输出
| 名称 | 类型 | 说明 |
|---|
数据集
| 数据 | 规模 | 备注 |
|---|
架构(摘要)
主干与结构
backbone:
参数:
类型:
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| 六任务 aggregate improvement(Qwen3 8B) | +9.62 个百分点 | GRPO +3.68;MIPROv2 +2.61(相对基线 45.23) | HotpotQA/IFBench/HoVer/PUPA/AIME-2025/LiveBench-Math;GEPA 总预算 1839–7051 次 rollout/任务,GRPO 固定 24,000;Table 1(§4) |
| HotpotQA 分数(Qwen3 8B) | 62.33(GEPA) | GRPO 43.33(24,000 次 rollout);基线 42.33 | 多跳问答复合系统;GEPA 预算 6871 次 rollout;Table 1(§4) |
| IFBench 分数与样本效率 | 38.61%,仅用 678 次 rollout | GRPO 35.88%(24,000 次 rollout) | 指令跟随基准;Qwen3 8B;Table 1(§4) |
| 六任务 aggregate improvement(GPT-4.1 Mini) | +12.19(GEPA)/ +13.33(GEPA+Merge) | MIPROv2 +5.64;TextGrad +6.11;Trace +3.27 | 同六任务;GPT-4.1 Mini;Table 2(§4) |
| AIME-2025(GPT-4.1 Mini) | 59.33(GEPA) | MIPROv2 51.33;TextGrad 46.67;基线 49.33 | 30 道 AIME-2025 题;GPT-4.1 Mini;Table 2(§4) |
| 候选选择策略(Qwen3 8B 四任务) | Pareto 采样 +12.44 | SelectBest(TextGrad 式)+6.05;BeamSearch(N=4)(APO 式)+5.11 | HotpotQA/IFBench/HoVer/PUPA;同一进化 harness 只换选择策略;Table 3(§4) |
| NPUEval 平均向量利用率(GPT-4o) | 30.52%(GEPA Pareto;单条提示 Best-1 26.85%) | Sequential10 4.25%;+RAG 16.33%;+RAG+MIPROv2 19.03% | AMD NPU kernel 生成任务;GPT-4o;GEPA 无运行时 RAG;Figure 7(§5.1) |
| 提示长度 | 比 MIPROv2 短最多 9.2× | MIPROv2 联合优化指令与多条 few-shot 演示 | 各任务 GEPA 与 MIPROv2 优化后提示的 token 长度对比;Figure 18(§4) |
Insights
- 语言是比稀疏标量奖励更丰富的学习介质:轨迹与评估文本允许对模块级失败做隐式 credit assignment,这是样本效率的来源。
- 反思式更新能直接把少量 rollout 变成大增益,指令优化单独就能超过「指令+few-shot 联合优化」(MIPROv2)。
- 按实例维护 Pareto 前沿、按出现频率随机采样,是规避贪心局部最优的关键结构(Table 3 的 +12.44 vs +6.05)。
- 进化出的指令比 few-shot 演示更短(最多 9.2×),推理时省 token、降延迟,且泛化 gap 更小。
- 反转 reward 即可做对抗性提示搜索;把反思接入检索可做 inference-time 代码优化(NPU/CUDA kernel),框架本身领域无关。
vs 同类工作
- 相
- 比
- G
- R
- P
- O
- (
- 权
- 重
- 空
- 间
- R
- L
- 、
- 数
- 万
- r
- o
- l
- l
- o
- u
- t
- )
- 与
- T
- e
- x
- t
- G
- r
- a
- d
- /
- A
- P
- O
- (
- 贪
- 心
- 或
- b
- e
- a
- m
- 提
- 示
- 优
- 化
- )
- ,
- G
- E
- P
- A
- 用
- 自
- 然
- 语
- 言
- 反
- 思
- +
- P
- a
- r
- e
- t
- o
- 前
- 沿
- 做
- 提
- 示
- 进
- 化
- ,
- 主
- 打
- 样
- 本
- 效
- 率
- 与
- 可
- 解
- 释
- 的
- 模
- 块
- 级
- 归
- 因
- ;
- 相
- 比
- M
- I
- P
- R
- O
- v
- 2
- (
- f
- e
- w
- -
- s
- h
- o
- t
- 演
- 示
- 优
- 化
- )
- ,
- G
- E
- P
- A
- 仅
- 优
- 化
- 指
- 令
- 就
- 全
- 面
- 反
- 超
- 。
局限
- AIME-2025(Qwen3 8B)上 GEPA 32.00 落后 GRPO 38.00:纯推理与提示优化在硬数学推理上仍不及权重 RL。
- 依赖反馈函数 µf 提供高质量文本反馈;评估者本身是 LLM 时反馈可被候选提示诱导(reward hacking 风险),论文没有系统分析。
- 多数 rollout 预算花在 Dpareto 全量验证上(作者自承),样本效率的进一步优化依赖更小的验证集或动态子集。
- 反思质量受底层模型能力约束;跨模型迁移只做了「Qwen 优化 → GPT-4.1 Mini 评估」(+9%),反向与更系统的迁移未研究。
- 候选池只增不减、无淘汰规则,长期运行的规模与多样性边界未研究。
- NPU/KernelBench 实验被作者标注为 early results,需要更系统的验证;对抗性搜索只报 AIME 单场景。
可复现性
代码开源(github.com/gepa-ai/gepa);给出 Algorithm 1 伪代码、反射 meta-prompt(附录 C)、六 benchmark 的系统/反馈函数配置(附录 E)、train/validation/test 切分与逐任务 rollout 预算(Table 1);Qwen3 8B 与 GPT-4.1 Mini 推理设置统一。
GEPA 架构:反思式进化循环的数据流
flowchart TD
    A["输入:系统 Φ(含初版提示)、训练集 Dtrain、指标 µ、反馈函数 µf、预算 B"] --> B["切分:Dfeedback(反思用)+ Dpareto(验证用)"]
    B --> C["初始化候选池 P = [Φ],祖先表 A = [None]"]
    C --> D{"预算 B 用完?"}
    D -- 否 --> E["Pareto 采样:按实例最优集 + 去支配 + 频率概率,选一个候选"]
    E --> F["选模块 j(round-robin)"]
    F --> G["在 b 个样本的 minibatch 上执行,收集轨迹 + µf 文本反馈"]
    G --> H["reflection LLM 归因成败、重写模块 j 的提示 → 新候选 Φ'"]
    H --> I{"minibatch 上 σ' > σ ?"}
    I -- 否 --> J["丢弃 Φ'"]
    I -- 是 --> K["在全 Dpareto 上评估 Φ',加入候选池并记录祖先"]
    K --> D
    J --> D
    D -- 是 --> L["返回 Dpareto 平均分最高的候选"]
组件详解
输入与切分:GEPA 需要一个「可以实例化的系统」——任意由多个 LLM 模块与工具调用组成的工作流,外加一套初始简单提示。训练集切成两块:$D_{\text{feedback}}$ 供变异时采样 minibatch,$D_{\text{pareto}}$(约 $n_{\text{pareto}}$ 个实例)专供候选筛选与最终选择,避免进化过程直接碰验证集内容。
Pareto 采样器:维护「实例 × 候选」分数矩阵。对每个实例保留分数最高的候选集合,做逐对支配去除(一个候选在所有实例上都不比另一个强就被去掉),然后按剩余候选在多少实例的最优集里出现(频率 $f[\Phi]$)做概率采样。效果:每次进化的对象是「某一类任务的赢家」,搜索持续向多个方向分叉。
反思变异器:对选中候选跑 minibatch,把模块输入/输出/推理 + 分数 + 文本反馈(编译器错误、rubric 失败等)打包给 reflection LLM,让它归因并给出改写后的模块提示。模块按 round-robin 轮换,保证每个模块都有被改到的机会。
两级评估门:minibatch 门(便宜、快速否决)→ 全 Dpareto 门(精确、入库)。只有两级都过的新候选才进入候选池,并记录其父候选,形成可追溯的进化树。
输出:预算耗尽后,返回 Dpareto 上平均分最高的候选;该候选的提示集合即最终交付物。全程模型权重冻结,交付物是纯提示文本。
与贪心/beam 提示优化的区别:TextGrad 式 SelectBest 每轮只进化当前最优,图里表现为单条路径、一轮后就停在局部;APO 式 BeamSearch 维护 top-N 池但仍以分数排序采样,分叉有限。GEPA 的 Pareto 采样以「实例级赢家」为单位,牺牲了「每轮一定改全局最优」的确定性,换来搜索树宽度,这是 Table 3 里 +12.44 与 +6.05/+5.11 差距的来源。
为什么样本效率高:每个 rollout 的轨迹与文本反馈都被反射器消费,成为改写依据;minibatch 门在浪费预算前就否决差候选;Dpareto 验证虽然贵,但为最终选择提供了稳定的 held-out 信号。作者自承验证占了预算大头,进一步优化方向是更小的验证集或动态子集。
HotpotQA 与 IFBench 上 GEPA、MIPROv2、GRPO 的学习曲线
原文 caption:A comparison of learning behavior of the GEPA prompt optimizer against a state-of-the-art prompt optimizer (MIPROv2) and GRPO (24,000 rollouts). As more rollouts are sampled, the prompt optimizers can learn much more quickly than GRPO. (caption 精简自原文)
核心卖点的实证:横轴是 rollout 数,纵轴是分数。GEPA 的曲线起点低但斜率陡,在远小于 24,000 次 rollout 的预算内越过 GRPO;星号是测试集分数,说明收益不是验证集过拟合。读图注意 GEPA 与 GRPO 交点的横坐标——样本效率差就在这段距离里。
候选选择策略对比:SelectBest 与 Pareto 采样的进化树
原文 caption:Comparing the impact of different candidate selection strategies. Selecting the best-performing candidate in every iteration led to a local-optima after one iteration; Pareto-based candidate selection generated a balanced search tree. (caption 精简自原文)
证明「Pareto 采样是规避局部最优的机制」:左边 SelectBest 的树在第一次迭代后就集中在一条路径上(图里括号分数停在低值),右边 Pareto 采样的树向多个方向分叉并找到更高分。读法:比较两棵树的括号分数与分支宽度,这是 Table 3(+12.44 vs +6.05)的可视化版本。
NPUEval 上 GEPA 与顺序精炼 agent 的向量利用率对比
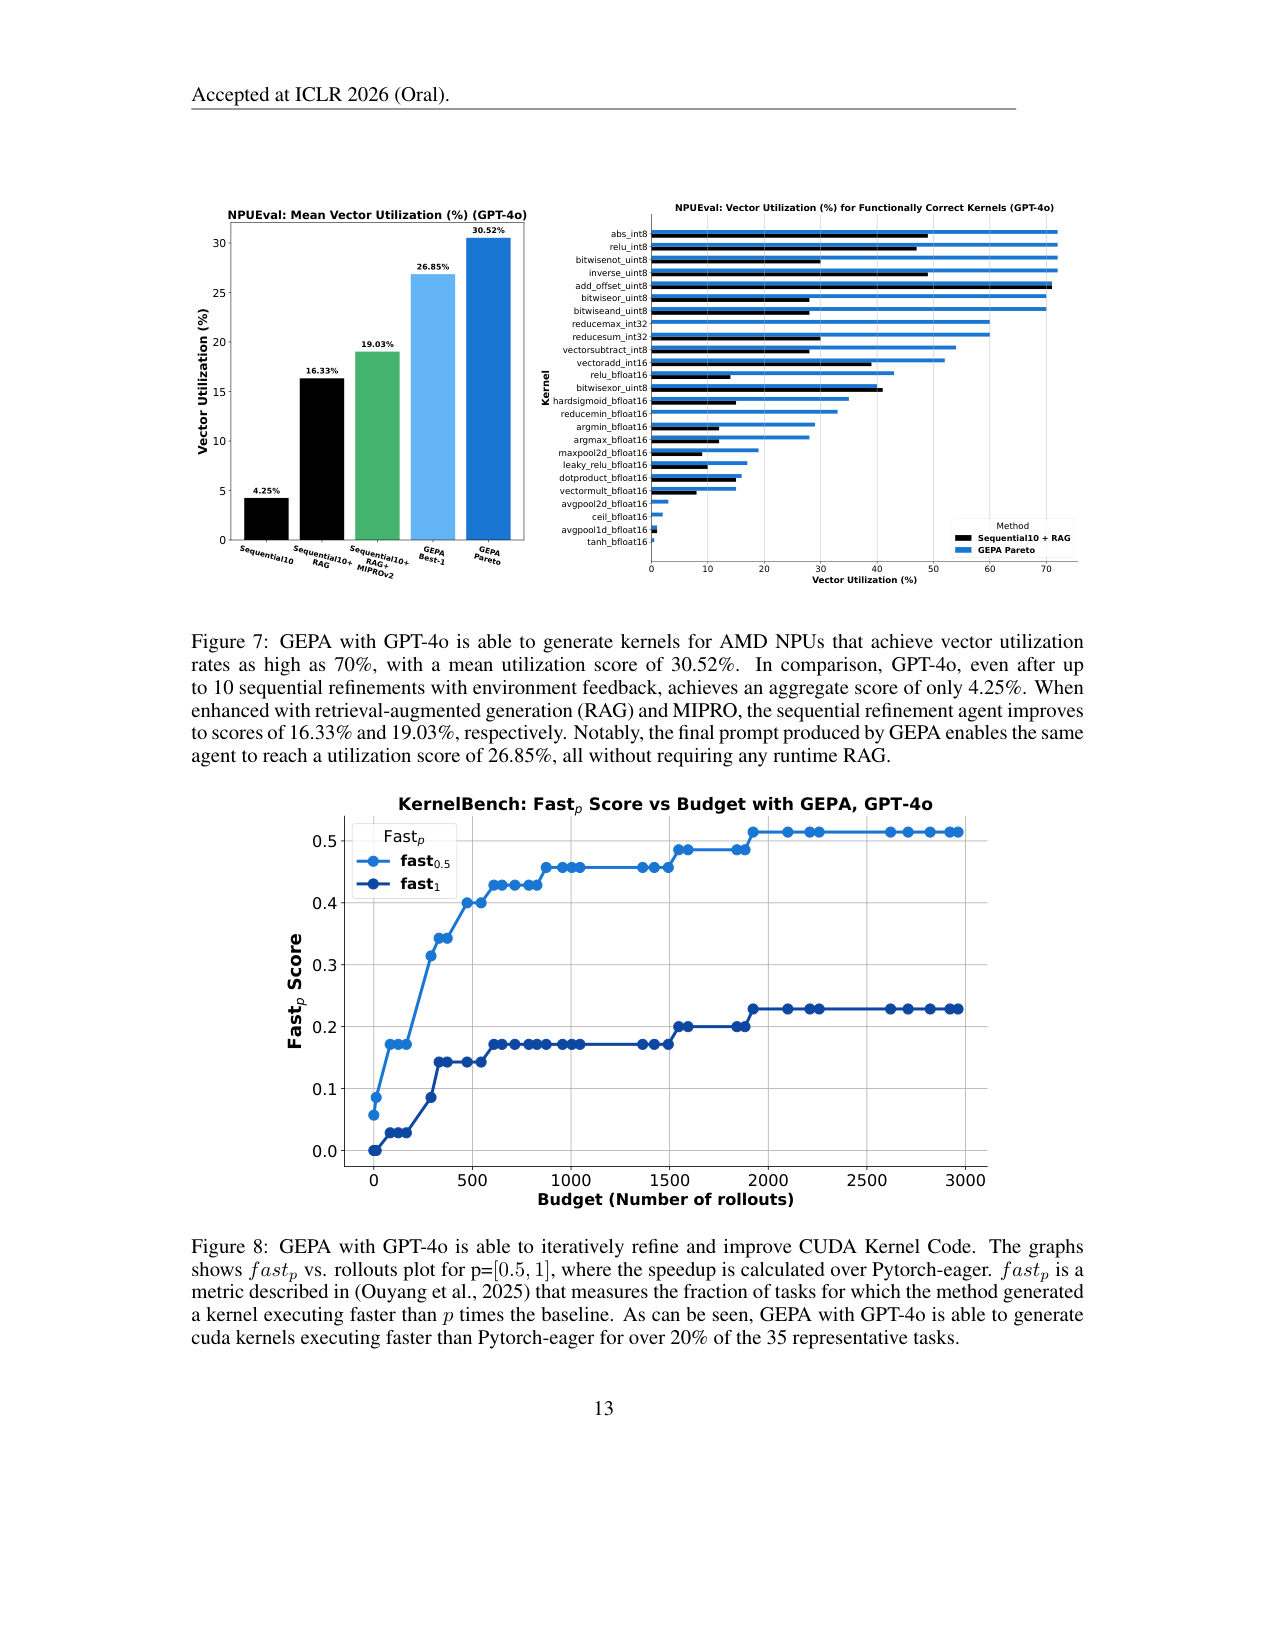
原文 caption:GEPA with GPT-4o is able to generate kernels for AMD NPUs that achieve vector utilization rates as high as 70%, with a mean utilization score of 30.52%. (caption 精简自原文)
证明 GEPA 作为 inference-time 代码优化搜索器可行:横条对比四档基线——纯顺序精炼 4.25%、加 RAG 16.33%、加 RAG+MIPROv2 19.03%、GEPA 的 Best-1 单条提示 26.85%、GEPA 全 Pareto 30.52%。读法:GEPA 不需要运行时 RAG,靠进化出的提示就把同一 agent 拉到近 7 倍利用率,说明反思+进化学到的知识可固化进提示。
让 LLM 用自然语言反思自己的失败,然后进化提示(对话版)
小播:今天聊一篇 ICLR 2026 的 Oral 论文,GEPA,来自伯克利、斯坦福这一批人。一句话先给结论:给大模型适配新任务,主流的强化学习要用几万次 rollout,这篇说,让模型自己看自己跑的轨迹、用自然语言反思、再进化提示,几十次到几千次 rollout 就能反超。
老播:最直观的例子:指令跟随的 IFBench 上,GEPA 用 678 次 rollout 拿到 38.61%,对照组 GRPO 用 24,000 次 rollout,只有 35.88%。一个零头,一个两万四。
小播:等等,GRPO 是什么,为什么要拿它当靶子?
老播:GRPO 是现在给推理模型做后训练的主流 RL 方法。思路是让模型跑一堆 rollout,把「答对没答对」压成一个标量奖励,再算策略梯度去更新权重。好用,但贵——业界跑 GRPO 常常要用到几万甚至几十万次 rollout。
小播:那 GEPA 凭什么少用这么多?先记第一个记忆锚点:GRPO 把信息压成数字再学,GEPA 在语言里直接学。
第一段:它要解决什么问题
老播:GEPA 要优化的对象叫复合 AI 系统:好几个 LLM 模块加上工具调用拼成的工作流,比如多跳问答、检索加验证、执行代码这类。论文把问题形式化成:在 rollout 预算 B 以内,找到让系统在 held-out 数据上表现最好的提示集合。
小播:为什么 rollout 这么金贵?
老播:因为一次 rollout 可能要调外部工具、跑编译器、烧 API 费用,贵。而 GRPO 学一次要几万次。GEPA 的核心观察是:rollout 跑出来的东西,本来就是自然语言——推理链、工具调用、编译器报错——信息量远大于一个「对了/错了」的数字。让模型直接在语言里反思,就是在用更丰富的信号学习。
第二段:机制怎么转
老播:每轮三件事:选候选、反思变异、验证入库。选候选用 Pareto 前沿,这个待会儿单独说。变异是关键:把一个候选放到一小批问题上执行,拿到完整轨迹和文本反馈,包括编译器错误消息、rubric 失败原因这类评估器中间输出,然后让一个反思模型看「当前提示、轨迹、分数、反馈」,判断是哪个模块的哪句话导致失败,重写那个模块的提示。
小播:这就是隐式的 credit assignment——把锅归到具体模块,再针对性改。
老播:对。改完先在 minibatch 上比父代,分数没涨就丢弃;涨了,才放到全验证集上精确评估、进候选池。预算用完,返回验证集上平均分最高的候选。
小播:那 Pareto 前沿是干嘛的?为什么不能每次都改当前最好的?
老播:因为贪心会卡住。论文对比了三种策略:每轮改最优(TextGrad 的做法)、维护 top-N 池(APO 的做法)、GEPA 的 Pareto 采样。做法是:对每个任务实例记下所有候选里最好的,去支配后,按「候选在多少个实例的最优集里出现」的概率随机采样。效果:搜索树同时朝多个方向的赢家分叉。数字上,同一套进化 harness 只换策略,Pareto 采样 +12.44 个百分点,贪心 +6.05,beam 搜索 +5.11。
小播:第二个记忆锚点:Pareto 前沿负责绕开局部最优,分叉宽度决定分数。
小播:那反思模型看的「反馈」具体长什么样?能举个例子吗?
老播:以代码类任务为例:系统生成一段 kernel,评估器先编译,报错信息就是反馈文本;编译过了,再跑性能分析,profile 结果也是反馈文本。这些在 GRPO 里都会被压成一个 0 或者 1,在 GEPA 里原样送给反思模型。多跳问答还有逐 hop 的反馈——第一跳检索错了,第二跳就算白算,反馈会指明是哪一跳的问题。
第三段:关键结果
老播:全部带 baseline 和 setup。Qwen3 8B,六个任务:HotpotQA、IFBench、HoVer、PUPA、AIME-2025、LiveBench-Math。GEPA 聚合提升 +9.62 个百分点,GRPO 固定 24,000 次 rollout 只有 +3.68,MIPROv2 是 +2.61。GEPA 每任务预算只有 1839 到 7051 次 rollout,最多省 35 倍。单点:HotpotQA 62.33 对 GRPO 的 43.33。
小播:开源模型上赢了,闭源模型呢?
老播:GPT-4.1 Mini 上更夸张:GEPA 聚合 +12.19,加上 merge 交叉到 +13.33,MIPROv2 只有 +5.64。AIME-2025 上 GEPA 59.33,MIPROv2 51.33。
小播:跨模型迁移呢?用 Qwen 优化出来的提示,换到别的模型上还灵吗?
老播:论文做了一个反向验证:完全用 Qwen3 8B 优化出来的提示,直接拿去喂 GPT-4.1 Mini,什么都不改,拿到 +9% 的聚合提升,比那些直接针对 GPT-4.1 Mini 优化的方法还高。说明进化出来的提示里有一部分是任务层面的通用知识,不绑定具体模型。
小播:那它还能干嘛?
老播:还能当推理时的搜索器。AMD NPU 的 kernel 优化任务上,用 GPT-4o,进化出的提示把平均向量利用率从顺序精炼 agent 的 4.25% 拉到 30.52%,部分 kernel 到 70%,而且不需要运行时 RAG。进化出的提示本身还短,比 MIPROv2 的 few-shot 结果最多短 9.2 倍,推理时省 token。
第四段:局限
小播:冷水来了。它哪里不行?
老播:第一,硬数学推理还是 RL 的主场。AIME-2025 用 Qwen3 8B 跑,GEPA 是 32.00,GRPO 是 38.00。第二,它依赖反馈函数给文本反馈,评估者如果是 LLM,候选提示可能诱导出有利反馈,reward hacking 的风险论文没有系统分析。第三,作者自己承认,预算大头花在全验证集评估上,真正用于学习的训练 rollout 每任务只有几十到几百次,效率还能再榨。另外候选池只增不减,长期运行没有淘汰规则。
小播:第三个记忆锚点:GEPA 的主场是「有丰富文本反馈的复合系统」,数学推理上 RL 仍占优。
收尾:一句话记住这篇
老播:收尾。GEPA 把每一次 rollout 的轨迹和评估文本变成自然语言学习信号,反思式变异负责归因和改提示,Pareto 前沿负责绕开局部最优。最该记住的数字:IFBench 上 678 次 rollout 的 38.61%,对照 GRPO 24,000 次 rollout 的 35.88%。最该记住的边界:带文本反馈的复合系统是它的主场,纯数学推理还是 RL 更强。
小播:这篇值得读,它把「样本效率」从权重空间搬到了语言空间。我们下期见。