Harness Engineering for Self-Improvement:把「模型外面的代码」变成优化对象
> 量子位技术拆解 · Lilian Weng 综述(2026-07-04)。完整结构化数据见「速查」tab。
先看一个判断:递归自我改进(RSI)这个词来自 1965 年的 I. J. Good——机器改进机器自己。但近路径大概率从改权重开始。Lilian Weng 这篇综述给出的近路径是:模型先改进自己的 harness——那个决定模型存什么、取什么、呈现什么的代码系统。Claude Code、Codex 这类产品已经证明:同一颗模型,harness 不同,行为天差地别。
核心概念:harness 是什么,进化对象怎么分层
harness 超出早期「agent = LLM + 记忆 + 工具 + 规划」的公式,还包括 workflow 循环(loop engineering)、评测、权限控制、持久状态管理——它更接近运行时与软件系统设计。综述归纳了三个反复出现的设计模式:
1. Workflow 自动化:plan → execute → observe/test → improve 的目标导向循环(Karpathy 的 autoresearch 是干净示例)。
2. 文件系统作持久记忆:长 horizon 任务里日志、diff、错误轨迹远超上下文窗口,把它们放文件里而不是塞进 context。
3. Subagent 与后端任务:主 agent 并行派发子任务,进程管理要显式、可检查。
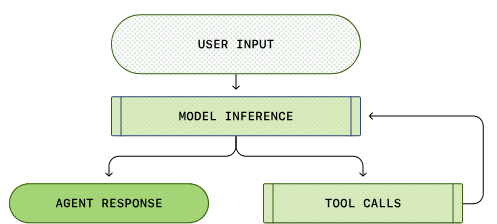
真正的主线是「进化对象分层」。综述给出递进链:指令 prompt → 结构化上下文 → workflow → harness 代码 → 优化器代码。模型越强,能优化的目标越复杂。对应到方法:
- 上下文工程:ACE 用 Generator/Reflector/Curator 维护带 identifier 的条目 playbook(图 B),更新规则仍手工;MCE 再进一步,用 agentic crossover 进化「怎么管上下文」的 skill,上下文变成文件与代码(图 C)。
关键结果:能力拆两轴,瓶颈在「用好」
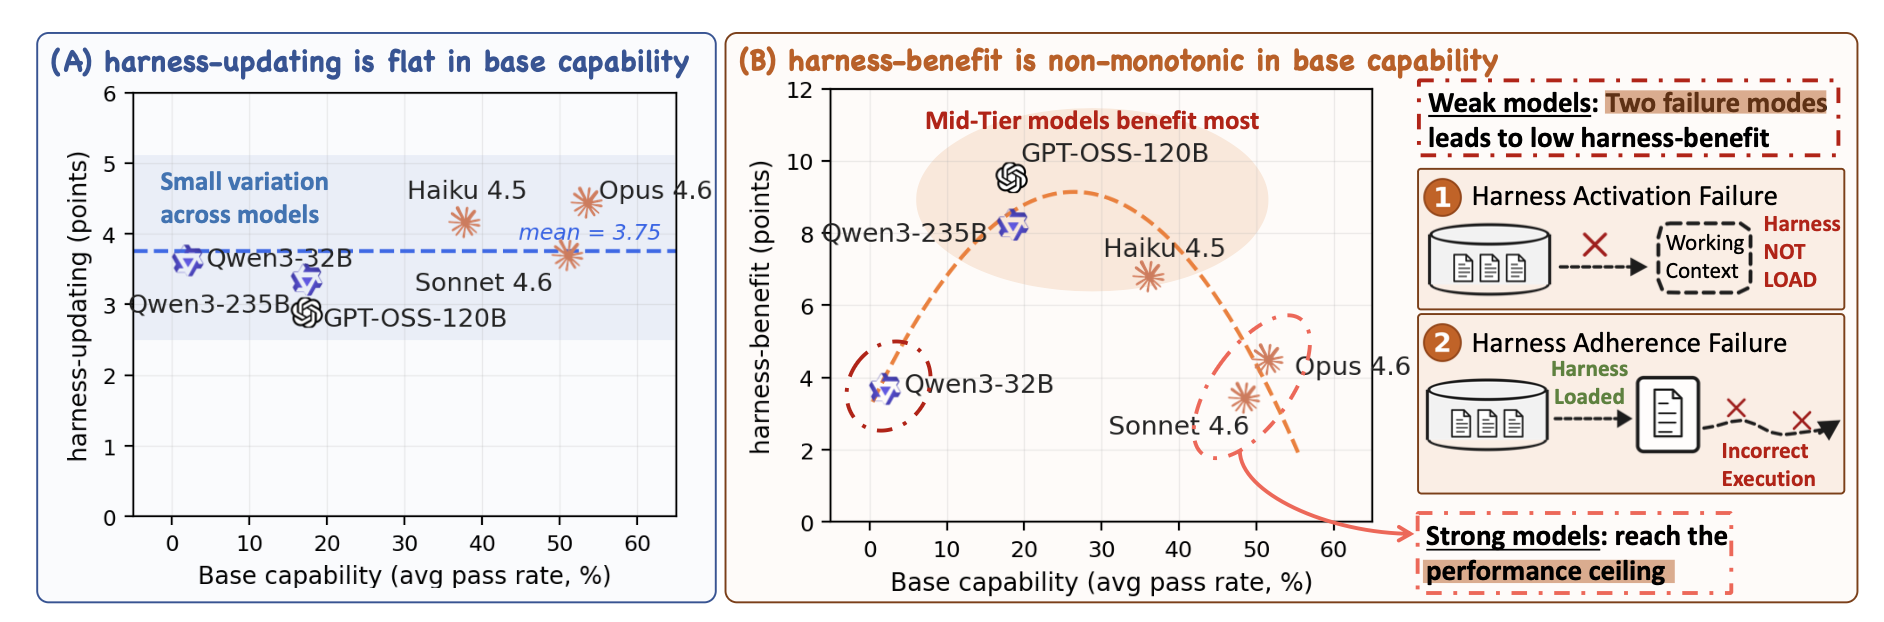
综述最有信息量的实证来自 Lin et al. 2026 的两轴拆解(图 F):harness-updating(能不能改)从 Qwen2-32B 到 Opus 4.6 基本平坦——9B 的提案者都能写出与 Opus 程序同构的 skill;harness-benefit(能不能用好)却非单调,中间档模型受益最大。这说明自改进的瓶颈常在于「正确及时地调用技能」,而不在于写出编辑。
- STOP 的警示:GPT-4 下递归改进提升平均性能,GPT-3.5 与 Mixtral 反而下降——基座必须够强,机制改进才有正收益。
综述还梳理了值得跟踪的评估基准(附录):PaperBench 测「复现一篇 AI 研究论文」、RE-Bench 测 agent 相对人类专家的 R&D 能力、MLE-bench 测机器学习工程、KernelBench 测 GPU kernel 编写——这些基准把「评测」本身变成可量化对象,正是进化搜索能发挥的前提。而 Karpathy 的 autoresearch、OpenAI 的 GPT-5 早期科学加速实验等系统,则展示了 expert-designed harness 能覆盖多少 auto-research 环节。
局限与争议:评测、安全、L2 证据
综述自己的诚实清单:
1. 评测是主瓶颈:fitness 易量化(矩阵乘、GPU kernel、算法竞赛)时进化搜索好用;评测慢、模糊、偏启发式时难用。Trehan & Chopra 的开放研究实验更直观:3 个领域各 45–50 篇种子文档,只有 4 个想法被选中、1 个完整跑通成论文——并观察到六类重复失败模式。
2. 安全边界:允许程序改 harness 等于打破 OS 抽象边界,编辑面、权限与安全层必须放在循环外;reward hacking 的挑战全部还在。AHE 的「runs 目录、verifier、LLM 配置只读」是一个缓解样例。
3. L2(权重联合优化)证据最弱:SIA 的实验有 confounds——task agent(gpt-oss-120b)远弱于 meta/feedback agent(Claude Sonnet 4.6),baseline 也弱,Weng 明确说「方向有趣、证据 provisional」。
一句话记住这篇
harness 工程是 RSI 的近路径:进化对象从 prompt 一路递进到 harness 代码与优化器代码,自指程度分 L0–L2。最该记住的结论是:模型改进机制的「更新能力」对规模不敏感,瓶颈在「用好机制」的收益端;最该保持的态度是——评测质量决定进化质量,安全层必须活在循环之外。
把「harness(决定存什么/取什么/呈现什么的代码系统)本身当优化目标」的综述:按进化对象从 prompt→结构化上下文→workflow→harness 代码→优化器代码分层,给出 L0–L2 自我改进分级;用 STOP/Self-Harness/AHE/DGM/SIA 等实证说明模型能改进机制,但效果取决于基座能力、可观测性与评测质量。
问题
要解决什么:递归自我改进(RSI)的近路径是让模型改进自己的 harness——那个决定模型存什么、取什么、呈现什么的代码系统;综述把 2023–2026 的 auto-research、自改进 agent、进化程序搜索研究组织到「harness 工程」框架下,回答「当前自改进做到哪一步、瓶颈在哪」。
为什么 prior work 不够:早期「agent = LLM + 记忆 + 工具 + 规划」的框架漏掉 workflow 循环、权限控制与持久状态管理;多数优化方法只动 prompt 文本或压缩反馈(只给分数/摘要),与 harness 搜索需要的全经验访问不匹配;单篇论文又各说各话,缺一个把进化对象和自指程度讲清楚的分层坐标。
进化循环(搜索空间 → 算子 → 评估 → 选择)
搜索空间(什么被进化):综述覆盖的进化对象全集(prompt/上下文/harness 代码/workflow/权重):按「指令 prompt → 结构化上下文 → workflow → harness 代码 → 优化器代码」的演进链组织;每个表面可编辑与否取决于方法(如 AHE 限定只改 harness 工作区,runs 目录、verifier、LLM 配置只读)。
变异/提案算子:
- propose-evaluate-accept 循环(Self-Harness:weakness mining → bounded proposal → 回归验证)
- coding-agent 变异/交叉(AlphaEvolve 的 EVOLVE-BLOCK diff、MCE 的 agentic crossover)
- MCTS 扩展(AFlow 的选择-扩展-评估-回填)
- meta agent 编程新 agent(ADAS)
- mutation prompt 自身也进化(Promptbreeder 自指式变异)
评估方式:综述归纳的共性机制:验证器与回归测试(Self-Harness 的 held-in/held-out 双集)、基准 pass rate(TerminalBench-2、SWE-bench Verified、Polyglot)、可自动化的数值 fitness(矩阵乘、GPU kernel、算法竞赛);并指出评测慢、模糊或偏启发式时进化搜索难用。
选择与归档:综述归纳的共性机制:Pareto 前沿保留(Meta-Harness)、archive 累积 + 新颖性过滤(ADAS;ShinkaEvolve 的 code-novelty 拒绝采样)、按性能成比例且抑制子代过多的父代采样(DGM)、只接受无回归候选(Self-Harness)。
自我改进程度:综述给出的 L0–L2 分级视角:L0 固定模型 + 手工 harness;L1 固定模型 + harness 自进化(本综述大多数工作,含 Meta-Harness/Self-Harness/AHE/DGM/ACE/MCE);L2 harness 与权重联合优化(SIA、Continual Harness 初探——Weng 认为 SIA 证据 provisional,训练稳定性与 Goodhart 效应未解)。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|
输出
| 名称 | 类型 | 说明 |
|---|
数据集
| 数据 | 规模 | 备注 |
|---|
架构(摘要)
主干与结构
backbone:
参数:
类型:
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| DGM:固定模型下 harness 代码进化(Claude 3.5 Sonnet) | SWE-bench Verified 从 20% 到 50%,Polyglot 从 14.2% 到 30.7% | 手工设计 coding agent(手写 harness) | 简单初始 harness 配置起步,agent 只许改自己的 harness 代码库;数据来自被引论文 DGM(综述 Evolutionary Search 节) |
| STOP:递归改进对不同基座的收益 | GPT-4 下迭代改进提升平均下游性能;GPT-3.5 与 Mixtral 下降 | 初始 improver I0(无改进) | Zelikman et al. 2023;结论:递归结构本身不够,基座必须能改进机制 |
| harness-updating vs harness-benefit(Lin et al. 2026) | 更新能力从 Qwen2-32B 到 Opus 4.6 基本平坦(9B 提案者写出与 Opus 程序同构的 skill);收益能力非单调、中档模型最高 | 跨 8 个规模档的模型对照 | Qwen3.5-9B 到 Claude Opus 4.6 的编码 agent;benchmark 数据见被引论文 |
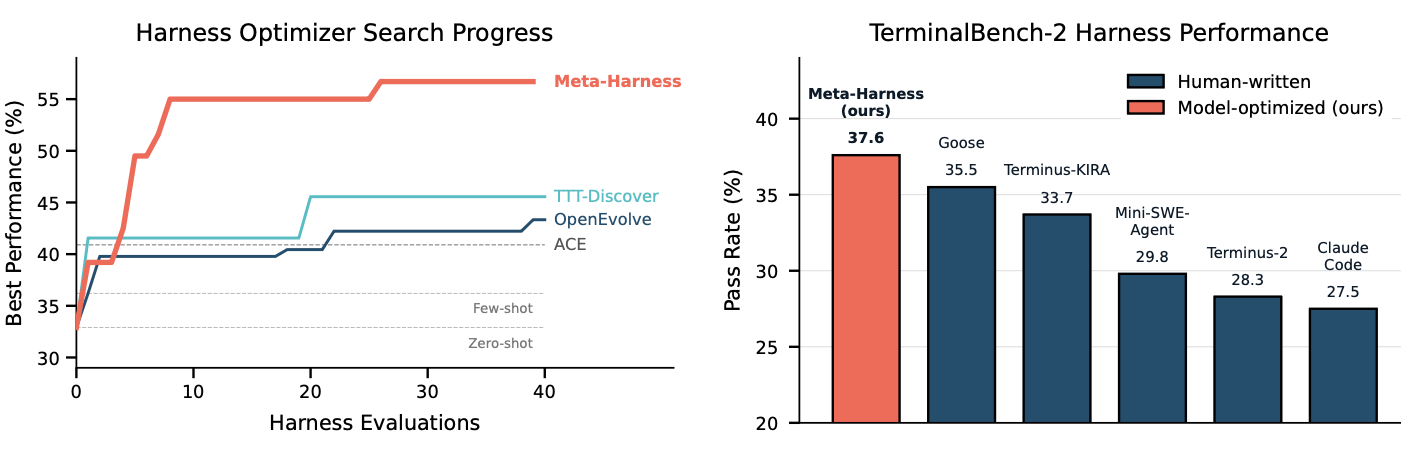
| AHE:可观测性驱动的 harness 进化(TerminalBench-2) | 超过 OpenCode、Terminus-2、Codex 等人类设计 harness(除 Hard 档与少量自进化 baseline) | 人类设计的 harness 与 ACE、TF-GRPO 等自进化 baseline | TerminalBench-2;同一 frozen harness 迁移到 SWE-bench-verified 仍有效——说明学到的是工程经验而非 benchmark 特化 |
| Trehan & Chopra:开放研究尝试的完成率 | 3 个领域各 45–50 篇种子文档,4 个想法被选中,只有 1 个完整跑通成论文 | 无(描述性实验) | world models / multi-agent RL / AI safety 三域,最小脚手架 + 基础工具;观察到六类重复失败模式 |
| Self-Harness:模型特异的 harness 指令 | MiniMax M2.5 / Qwen3.5-35B-A3B / GLM-5 上学习各自弱点对应的 harness 指令,提升 held-out pass rate | 各自基线的固定 harness | TerminalBench-2;weakness mining → bounded proposal → held-in/held-out 回归验证循环 |
Insights
- 进化对象有明确的递进链:instruction prompts → 结构化上下文 → workflow → harness 代码 → 优化器代码;模型越强,可优化的目标越复杂(Harness Optimization 节)。
- 自改进能力要拆两轴:harness-updating(能不能改)对模型规模不敏感,harness-benefit(能不能用好)非单调——瓶颈常在后者(Lin et al. 2026)。
- 评测是进化的主瓶颈:fitness 易量化(矩阵乘、GPU kernel、算法竞赛)时进化搜索好用;评测慢、模糊或偏启发式时难用。
- 可观测性三支柱(component / experience / decision)是 harness 进化的地基,reward hacking 靠「编辑面限定 + 只读边界 + 每次编辑附带可证伪预测」来缓解(AHE)。
- 论文生产与科学发现要分开看:能写出像样的 manuscript 仍可能有编造引用、实现漂移、弱实验——这是 Weng 对 auto-research 的明确警惕(Future Challenges 节)。
vs 同类工作
- 综述的框架价值:把 20+ 篇论文统一到「harness 工程 → RSI」坐标下,给出三个设计模式(workflow 自动化、文件系统持久记忆、subagent/后端任务)与 L0–L2 自指分级。
- 与单篇方法论文的差别:不报新数字,而是横向比较反馈通道(分数/摘要/全经验)与进化对象层级,并对 SIA 等结果做方法论批判(task agent 远弱于 meta agent、baseline 太弱、证据 provisional)。
- 给出了「harness 层 vs 核心智能」的预测:近路径是 meta-methodology——改进「拿到更好答案的机器」,harness 本身成为优化目标,最终许多改进会内化进模型行为但接口保留。
局限
- 综述性质:所有数字来自被引论文,未做独立复现;Weng 自己指出 SIA 实验存在 confounds、证据 provisional(Joint Optimization 节)。
- 评测偏 coding/benchmark 场景(TerminalBench-2、SWE-bench、KernelBench 等),对模糊/开放任务(科研发现、写作)证据少;作者明说 paper 生产不等于发现(Future Challenges 节)。
- 安全边界未解:允许程序改 harness 时 OS 抽象边界被打破,编辑面、权限与安全层必须放在循环外(Weng 自承 concern);reward hacking 的全部挑战仍存在。
- L2(权重联合优化)证据最弱:SIA 有 confounds,Continual Harness 只在长 horizon 游戏验证;训练稳定性与 Goodhart 效应悬而未决。
- 成本维度缺系统比较:Meta-Harness 每迭代约 10.0 MTok 对 GEPA 0.008 MTok(表 1 引自原论文),综述未给出各方法成本-收益的统一核算。
可复现性
- code:无独立代码(综述)
- notes:全文逐节链接原始论文与仓库(arXiv/项目页),附录列出有用 benchmark(PaperBench、RE-Bench、MLE-bench、KernelBench 等)与完整参考文献表。
Harness 工程综述:进化对象递进链与自指分级
Mermaid:从 harness 到自改进循环的地图
flowchart LR
    subgraph L0["L0:固定模型 + 手工 harness"]
        M["基座模型"] --> H0["手工 harness\n(workflow/工具/记忆规则)"]
        H0 --> OUT0["任务输出"]
    end

    subgraph L1["L1:固定模型 + harness 自进化"]
        P["Coding-agent proposer"] -->|"检查文件系统:\n先例代码/分数/执行轨迹"| FS["全经验文件系统"]
        FS -->|"grep/cat 检索"| P
        P -->|"提案新 harness 代码"| EVAL["执行评估\n(验证器/回归测试/基准)"]
        EVAL -->|"无回归才接受"| H1["新 harness"]
        H1 --> M2["固定基座模型"]
        M2 --> OUT1["任务输出"]
    end

    subgraph L2["L2:harness 与权重联合优化(初探)"]
        FB["Feedback-Agent\n(选更新哪一侧)"] -->|"更新 harness"| H2["harness"]
        FB -->|"更新权重"| W["模型权重"]
        H2 --> M3["模型"]
        M3 --> FB
    end

    L0 -->|"进化对象上移"| L1
    L1 -->|"SIA / Continual Harness"| L2
进化对象递进链(综述主线)
指令 prompt → 结构化上下文 → workflow → harness 代码 → 优化器代码
- prompt:Promptbreeder 变异任务 prompt,且 mutation prompt 自身也进化(自指式变异);GEPA 用反思 + 遗传 Pareto 搜索。
自指分级与能力拆解
- L0:固定模型 + 手工 harness(大多数生产 agent)。
三个设计模式(跨层级通用)
1. Workflow 自动化:goal-oriented 循环(plan→execute→observe/test→improve),agent runtime 分析自身轨迹与失败。
2. 文件系统作持久记忆:日志/diff/错误轨迹落盘,模型用 bash 读写,天然受益于核心模型的文件操作能力。
3. Subagent 与后端任务:显式可检查的进程管理(launch/inspect/cancel/merge),子任务输出落盘而非藏在临时对话里。
评测与安全层(必须活在循环外)
- 评测:验证器 + 回归测试(held-in 查弱点是否解决、held-out 查是否引入新问题)+ 可自动化数值 fitness;评测慢/模糊时进化搜索失效。
harness 长什么样:模型↔工具响应闭环
原文 caption:A simplified Codex agent loop: the agent calls tools and tool responses affect the model's next generation.(综述引用 OpenAI Codex 博客图)
给「harness」下定义:模型生成 ↔ 工具响应闭环,加上 workflow、评测、权限、持久状态管理,构成部署系统。读法:看闭环边界内全是可编辑表面。为什么重要:它是综述三个设计模式(workflow 自动化、文件系统持久记忆、subagent/后端任务)的锚点图,也是全文立论的地基。
上下文工程代表:Generator/Reflector/Curator
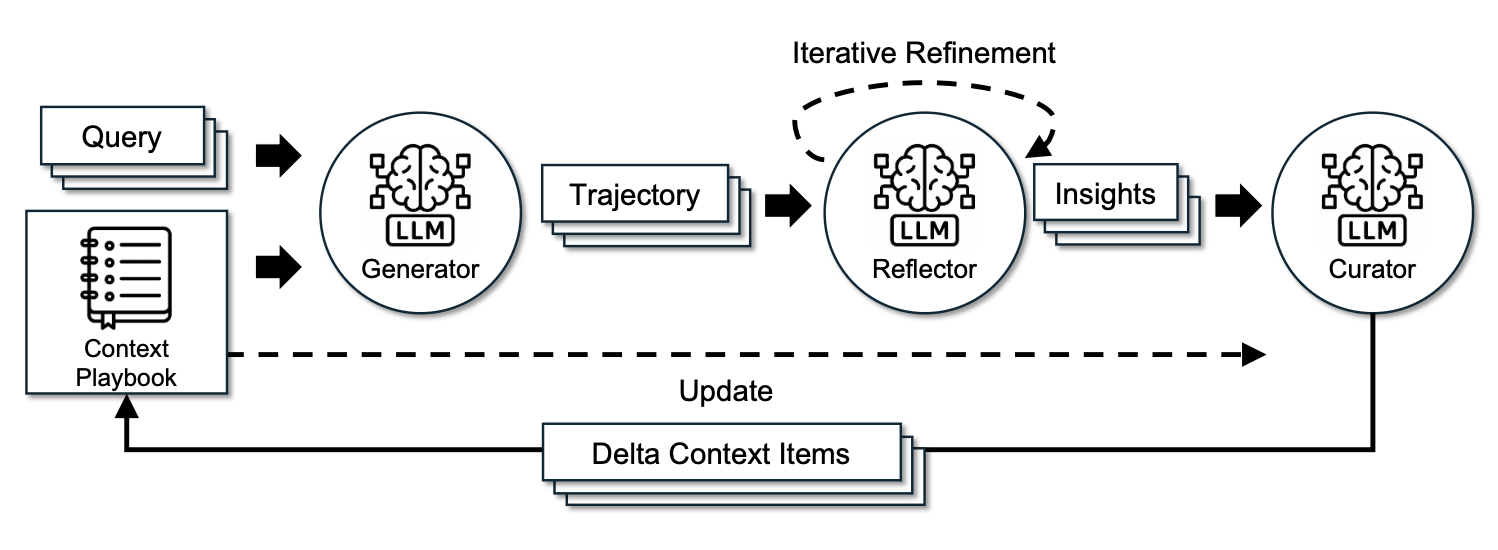
原文 caption:The framework of Agentic Context Engineering (ACE).(综述引用 Zhang et al. 2025)
展示「结构化上下文」这一进化层级:上下文被组织成带 identifier 的条目 playbook,由生成-反思-策展三角色维护。读法:机制(三角色分工与更新规则)仍是手工的,内容在进化。为什么重要:它是 L1 的典型样本——上下文内容自进化、机制手工,为 MCE 的「机制也进化」做铺垫。
上下文工程进化版:meta 层 skill 进化 + base 层上下文优化
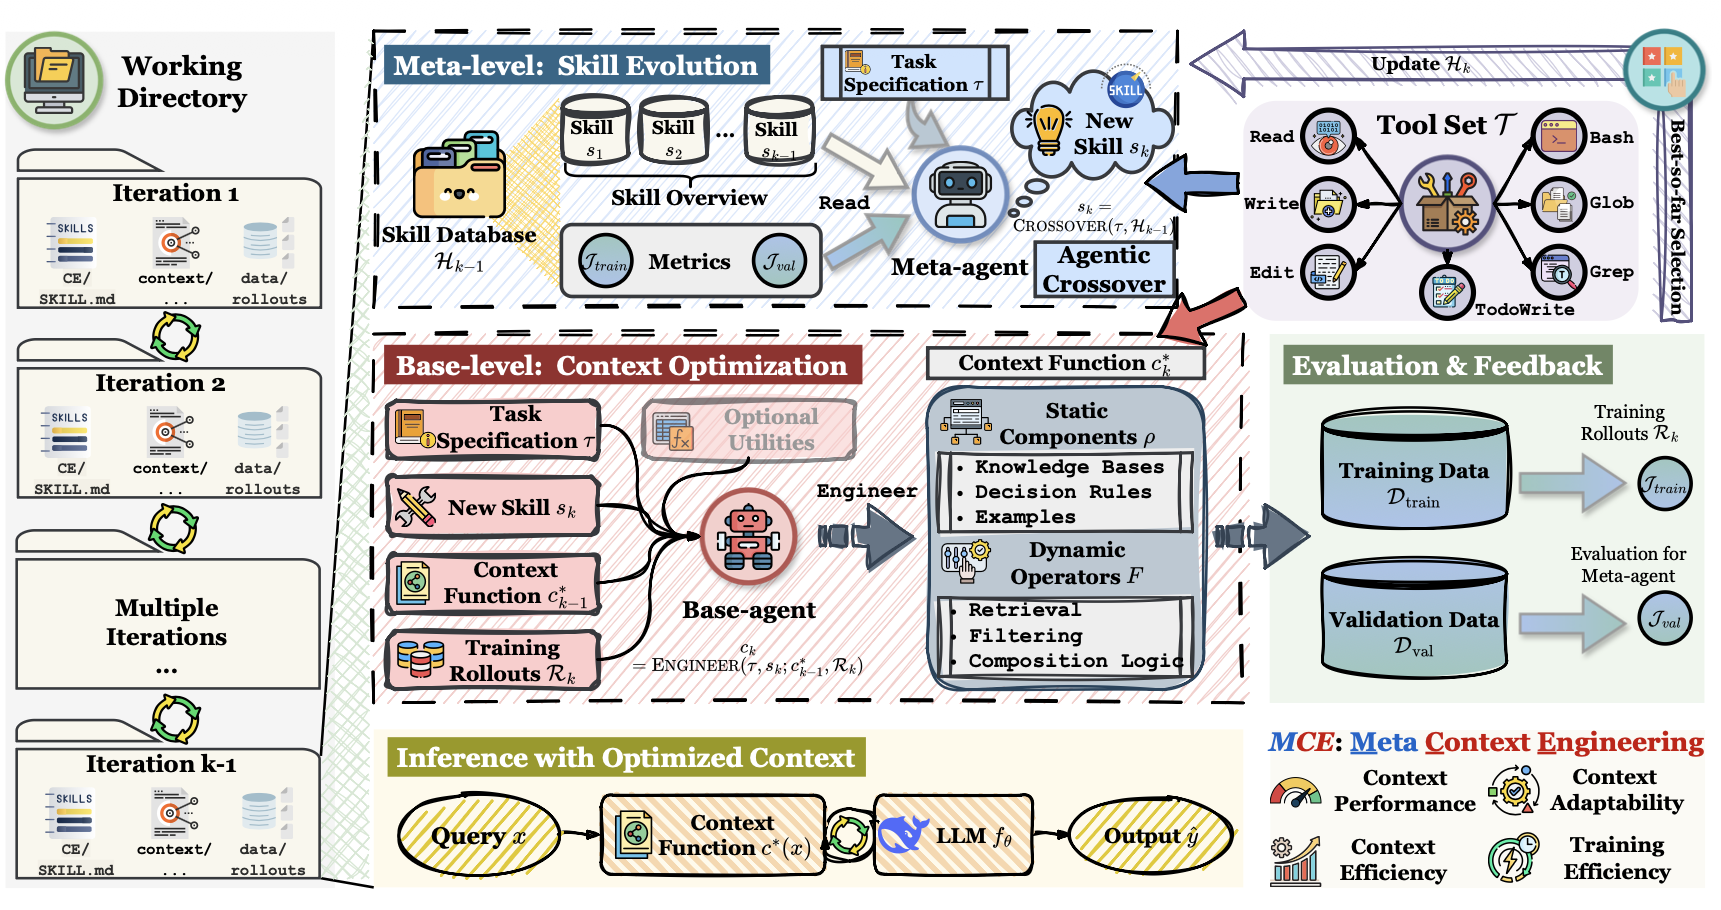
原文 caption:The framework of Meta Context Engineering (MCE): meta-level skill evolution searches over context-management mechanisms, while the base level optimizes the task context.
展示进化对象上移一级:meta 层用 agentic crossover 进化「怎么管上下文」的 skill,base 层把上下文当文件与代码优化。读法:看双层循环如何共用同一套编码工具集。为什么重要:它是综述「进化对象递进链」在上下文层级的顶点,说明机制本身可以成为优化目标。
harness 优化 harness:proposer 通过文件系统访问全部经验
原文 caption:The Meta-Harness outer-loop optimization algorithm.(综述引用 Lee et al. 2026)
展示 harness 代码成为进化对象:coding-agent proposer 用 grep/cat 查询文件系统里的先例代码、分数与执行轨迹,提案新 harness。读法:看反馈通道是「全文件系统」而非压缩摘要。为什么重要:它体现了综述的核心论点——harness 层与原始智能同等重要,且全经验访问比分数/摘要反馈更有效。
自我改进 harness:weakness mining → 有界提案 → 回归验证
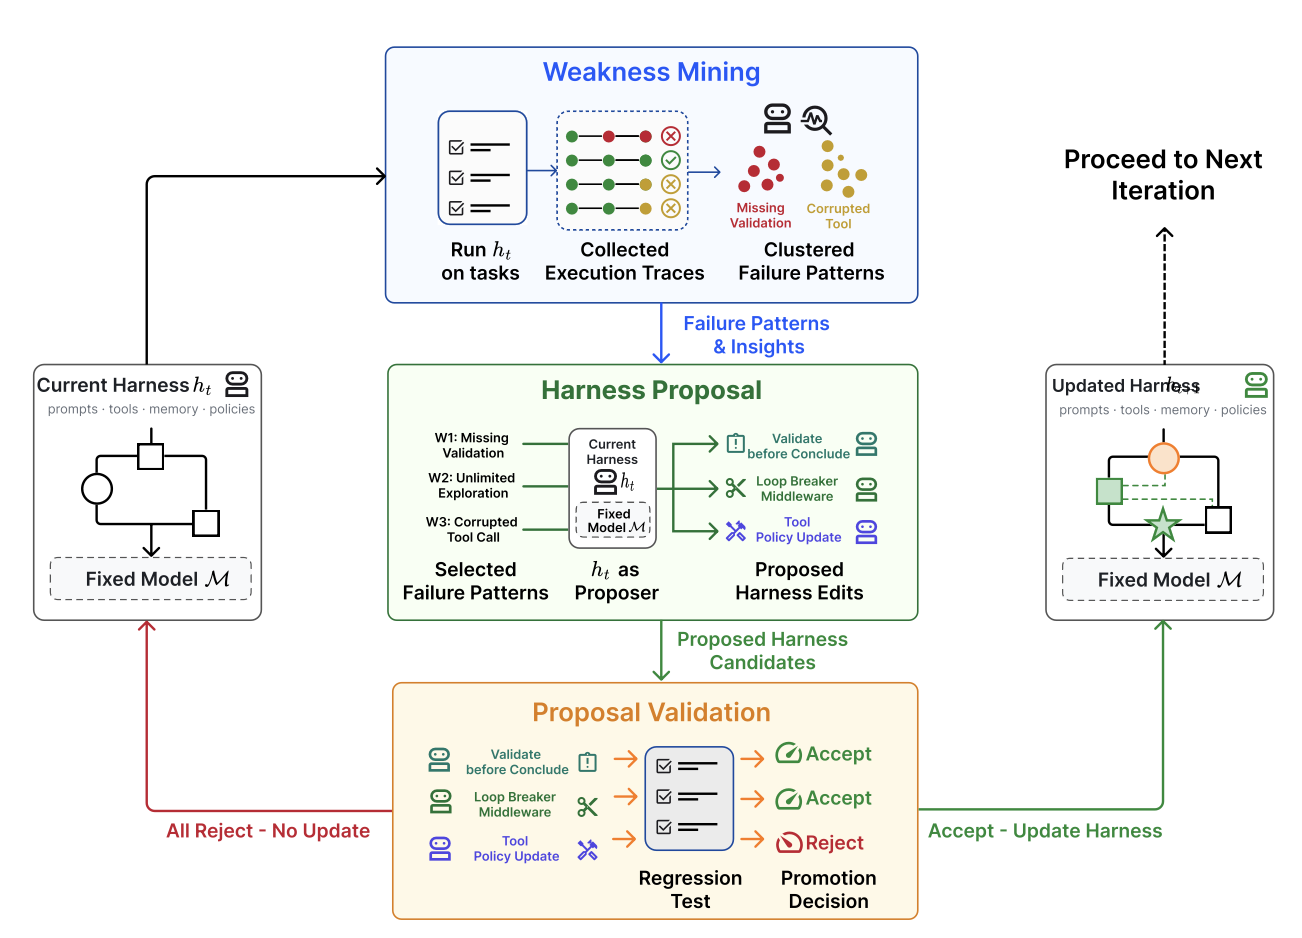
原文 caption:Self-Harness uses a loop of weakness mining, bounded harness proposal, and validation to update a harness.
展示 L1 自改进的标准循环:把失败聚成 verifier-grounded 模式、在有界编辑面上提案、用 held-in/held-out 双集回归测试决定接受与否。读法:看「无回归才接受」这个硬门槛。为什么重要:它示范了自进化 harness 如何用回归测试对抗 reward hacking 与退化,是综述「评测是瓶颈」论点的正面例子。
自改进能力的两轴拆解:更新平坦、收益非单调
原文 caption:(A) harness updating capability is measured flat across a range of models from Qwen2-32B to Opus 4.6; (B) harness benefit capability is non-monotonic where middle tier models benefit the most.(综述引用 Lin et al. 2026)
支撑「自改进瓶颈在收益端而非更新端」:更新 harness 的能力对模型规模不敏感(9B 模型写的 skill 与 Opus 程序同构),用好 harness 的能力却在中间档模型最高。读法:对比 A、B 两面板的曲线形态。为什么重要:它修正了「模型越强越能自我改进」的直觉——关键是能否正确调用技能,而非能否写出编辑。
模型外面的代码,比模型本身更能决定成败(对话版)
小播:今天聊一篇 Lilian Weng 的综述,主题有点大:模型怎么改进自己?
老播:对,标题叫《Harness Engineering for Self-Improvement》。一句话结论:递归自我改进的近路径,大概率从改进「模型外面的代码」开始——就是那个决定模型存什么、取什么、怎么呈现的 harness。
小播:等等,什么叫模型外面的代码?
老播:Claude Code、Codex 这类工具见过吧?同一个模型,套上不同 harness,行为可以天差地别。综述里引了一个数字:同一 benchmark 上,只换 harness 能产生约 6 倍的性能差。所以它说,harness 层和模型的原始智能同等重要。
小播:6 倍?那 harness 值得好好研究。
老播:对。我们从头拆——先看 harness 到底包括什么,再看进化对象怎么一层层往上走。
Harness 的三个设计模式
小播:harness 和以前的「agent = 模型 + 记忆 + 工具 + 规划」有什么区别?
老播:多了 workflow 循环、评测、权限控制、持久状态管理。它更像一个操作系统,而不是一套 prompt 模板。综述归纳了三个反复出现的模式。
小播:哪三个?
老播:第一,workflow 自动化——目标导向的循环:计划、执行、观察测试、改进、再执行。第二,文件系统当持久记忆——长任务里日志、diff、错误轨迹动不动超过上下文窗口,把它们写进文件,而不是塞进 context。第三,subagent 和后端任务——主 agent 并行派发子任务,进程管理要显式、可检查。
小播:听起来都是工程实践,不是算法创新?
老播:对,但这正是论点的前半:harness 是「运行时与软件系统设计」,工程细节决定系统上限。论点的后半是主线——进化对象递进链。
进化对象递进链
小播:什么叫进化对象?
老播:就是「优化什么」。综述给了一条链:指令 prompt,然后是结构化上下文,然后是 workflow,然后是 harness 代码,最后是优化器代码。模型越强,能优化的目标越复杂。
小播:每一层都有代表作?
老播:有。prompt 层有 Promptbreeder,连变异 prompt 自己都进化。上下文层有 ACE——生成、反思、策展三个角色维护一个条目化的 playbook,内容在进化,但更新规则还是手工的。MCE 再进一步,连「怎么管上下文」这个机制本身都用进化来搜。workflow 层有 ADAS 和 AFlow。再往上,Meta-Harness 优化整段 harness 代码——决定存什么、取什么、呈现什么的代码。
小播:那「优化器代码」这一层呢?
老播:STOP 最典型:让模型递归改进改进器本身。这里有个关键警示——GPT-4 下递归改进是正收益,GPT-3.5 和 Mixtral 反而下降。基座必须够强,机制改进才有用。
最反直觉的发现:改得动,但用不好
小播:综述里最值得记的实证是哪个?
老播:Lin et al. 2026 把自改进拆成两轴:一是 harness-updating,能不能写出好的 harness 编辑;二是 harness-benefit,能不能用好更新后的 harness。结果很反直觉:更新能力从 Qwen2-32B 到 Opus 4.6 基本是平的——一个 9B 的小模型都能写出和 Opus 程序同构的技能;但收益能力是倒 U 型,中间档模型受益最大。
小播:也就是说,写编辑不难,难的是正确及时地调用?
老播:对,记住这个记忆锚点:瓶颈在「用好」的收益端,在「写得出」的更新端。这解释了为什么有些模型改了 harness 反而变差——不是改不动,是用不好。
小播:那有没有实际的战果?
老播:先记一个记忆锚点:评测是进化的前提——fitness 好量化,进化就好用;评测慢、模糊、偏启发式,进化就难办。后面讲局限还会回到这一点。
老播:有。DGM 固定 Claude 3.5 Sonnet,让 agent 只许改自己的 harness 代码,SWE-bench Verified 从 20% 涨到 50%,Polyglot 从 14.2% 涨到 30.7%。AHE 在 TerminalBench-2 上超过了 OpenCode、Terminus-2、Codex 这些人类设计的 harness,而且同一个冻结的 harness 迁移到 SWE-bench 仍然有效。
小播:迁移有效,说明学到的是通用工程经验?
老播:对,这就是「harness 代码」层比「prompt」层值钱的地方——它把工程经验编码进了系统组件,而不是过拟合某个 benchmark。
泼冷水:评测、安全、L2
小播:综述自己承认哪些问题?
老播:三个。第一,评测是主瓶颈:fitness 好量化的时候进化搜索才好用,比如矩阵乘、GPU kernel、算法竞赛;评测慢、模糊、偏启发式的场景它就难办。有个开放研究的实验:三个领域各 45 到 50 篇种子文档,最后只有 4 个想法被选中,1 个完整跑通成论文——而且能写出论文和真正发现,是两回事,编造引用、实现漂移都是真实风险。
小播:第二呢?
老播:安全边界。让程序改 harness,等于打破操作系统的抽象边界。综述作者明确说,编辑面、权限、安全层必须放在进化循环外面,reward hacking 的挑战一个都没解决。AHE 的做法是参考:runs 目录、验证器、模型配置全部只读,编辑只能发生在 harness 工作区。
小播:第三?
老播:权重联合优化,就是综述里的 L2 级。代表工作是 SIA——一个反馈 agent 决定这轮改 harness 还是改权重。但它的实验有硬伤:干活的 agent 比改它的 agent 弱太多,baseline 也太弱。作者原话是:方向有趣,证据 provisional。
小播:那 L0、L1 又是什么?
老播:L0 是固定模型加手工 harness,今天大多数产品在这级。L1 是固定模型、harness 自进化,综述里绝大多数工作在这级。L2 就是 harness 和权重一起改,还在初探。
收尾
小播:最后用一句话总结?
老播:harness 工程是自我改进的近路径:进化对象从 prompt 一路递进到 harness 代码和优化器代码,自指程度分 L0 到 L2。最该记住的结论是:模型写 harness 编辑的「更新能力」对规模不敏感,瓶颈在「用好 harness」的收益端。最该记住的数字是:DGM 在固定 Claude 3.5 Sonnet 下,只让 agent 改自己的 harness 代码,就把 SWE-bench Verified 从 20% 提到 50%。
小播:而最该保持的态度是:评测质量决定进化质量,安全层必须活在循环之外。
老播:没错。这篇综述的价值就是把散在各处的自改进工作,放进了同一张坐标图——读它,比读其中任何单篇都更能看清这个领域的边界在哪。