Trigram 频率与 gap 精确频率探针 · controlled real-text dataset · 2000 steps · seed 42
1 · 这其实是一个实验:Baseline run + 三种分析视角
唯一的实验:Baseline training
在受控 real-text n-gram 数据集上运行一次固定的 NanoGPT baseline_input setting,训练 2000 steps。这里没有把 train/val gap、frequency 分组和 norm 曲线误写成不同实验。
分析视角 1:频率分层
对同一个 run 的 train/validation loss 按原始 train corpus 整个 epoch 中的 collision-free exact trigram context count r(c) 分组,计算 exact-frequency gap。
分析视角 2:loss / gap
受限 context 只能提供不完整的条件信息,因此 ground truth 本身有 H(Y|C)>0 的不确定性;训练可以降低 loss,但不能把 Bayes noise 消掉。
分析视角 3:norm dynamics
从同一个 run 的每个 batch 记录 bigram、trigram、total injection RMS,观察模型是否通过增大 memory norm 来记忆训练侧统计。
r(c) 只来自原始 train corpus 的完整 epoch,按真实 trigram context 逐个计数;hash bucket occupancy 不参与 gap 分组。当前 controlled block 仍是 [c0,c1,c2] → next,因此本报告的 context order 是 3。2 · Setting 与数据账本
训练与频率分解记录:aggregated JSONL · 全量 batch 索引:trace_manifest.jsonl · probe 明细索引:probe_details.jsonl。
3 · 训练曲线:Training loss 与 Validation loss
最终 step 2000 的 training loss 为 1.3826,validation loss 为 3.3485,整体 gap 为 +1.9658。
4 · 频率分布:每一个真实 trigram context count 是一个点
sqrt(r) moving average。r(c) 是 collision-free exact context count,统计源为原始 train corpus 的完整 epoch;hash bucket occupancy 仅可作为独立诊断,不能出现在主 gap 图中。5 · 主图:gap versus true trigram frequency
sqrt(r) 为窗口的 adaptive moving average;灰色虚线是严格的 y=0 基准。step 2000 的 exact-frequency gap 均值为 +0.977,中位数为 +0.975。散点的离散程度很大,因此平滑线只用于观察趋势,不替代原始点;图中 gap 纵轴固定为 [-1,4],超出范围的点不显示。
y=0。sqrt(r) adaptive moving average。| r | train | val | gap |
|---|---|---|---|
| 1 | 2.9850 | 3.8253 | +0.8403 |
| 2 | 2.8928 | 3.7592 | +0.8664 |
| 3 | 2.8495 | 3.6644 | +0.8149 |
| 5 | 2.8299 | 3.7928 | +0.9630 |
| 10 | 2.6068 | 3.9965 | +1.3897 |
| 20 | 2.6919 | 3.8298 | +1.1379 |
| 50 | 2.8787 | 4.4914 | +1.6126 |
| 100 | 3.1367 | 3.5992 | +0.4625 |
| 200 | 2.8794 | 3.7870 | +0.9076 |
| 500 | 0.8799 | 5.9677 | +5.0878 |
6 · gap 随训练进程
r(c),查看它在训练过程中的 train loss、val loss 和 gap。点击图例可以隐藏/显示曲线;gap 图固定显示 y=0。7 · 同一个 baseline run 的 injection norm 曲线
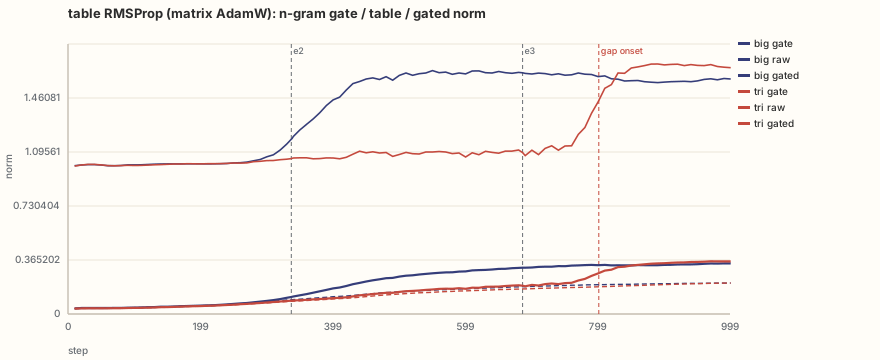
这张图不是另一个实验,而是同一 baseline run 的机制诊断。若 norm 持续增长而 validation loss/gap 没有同步改善,可以支持“memory capacity / norm growth 驱动过拟合”的解释,但不能单凭相关性证明因果。
8 · norm 机制背景(独立对照)
下面这张图来自此前独立的 RMSProp/table-gate 诊断,只作为背景,不与本次 trigram baseline 的 batch-level norm 混合统计。
9 · 原始明细是否已经保存?
全量 trace 保存的是每个训练 step 的 token-level loss,以及同一步固定 validation batches 的 token-level loss;不保存所有 transformer activation。当前 run 覆盖约 295M training tokens,并另外保存每步的 bigram/trigram/total injection RMS。
如启用 full-batch trace,报告会读取 trace_manifest.jsonl,并将每一步固定 validation batch 的 token-level loss 与 injection RMS 纳入主训练轨迹。