搜索setting
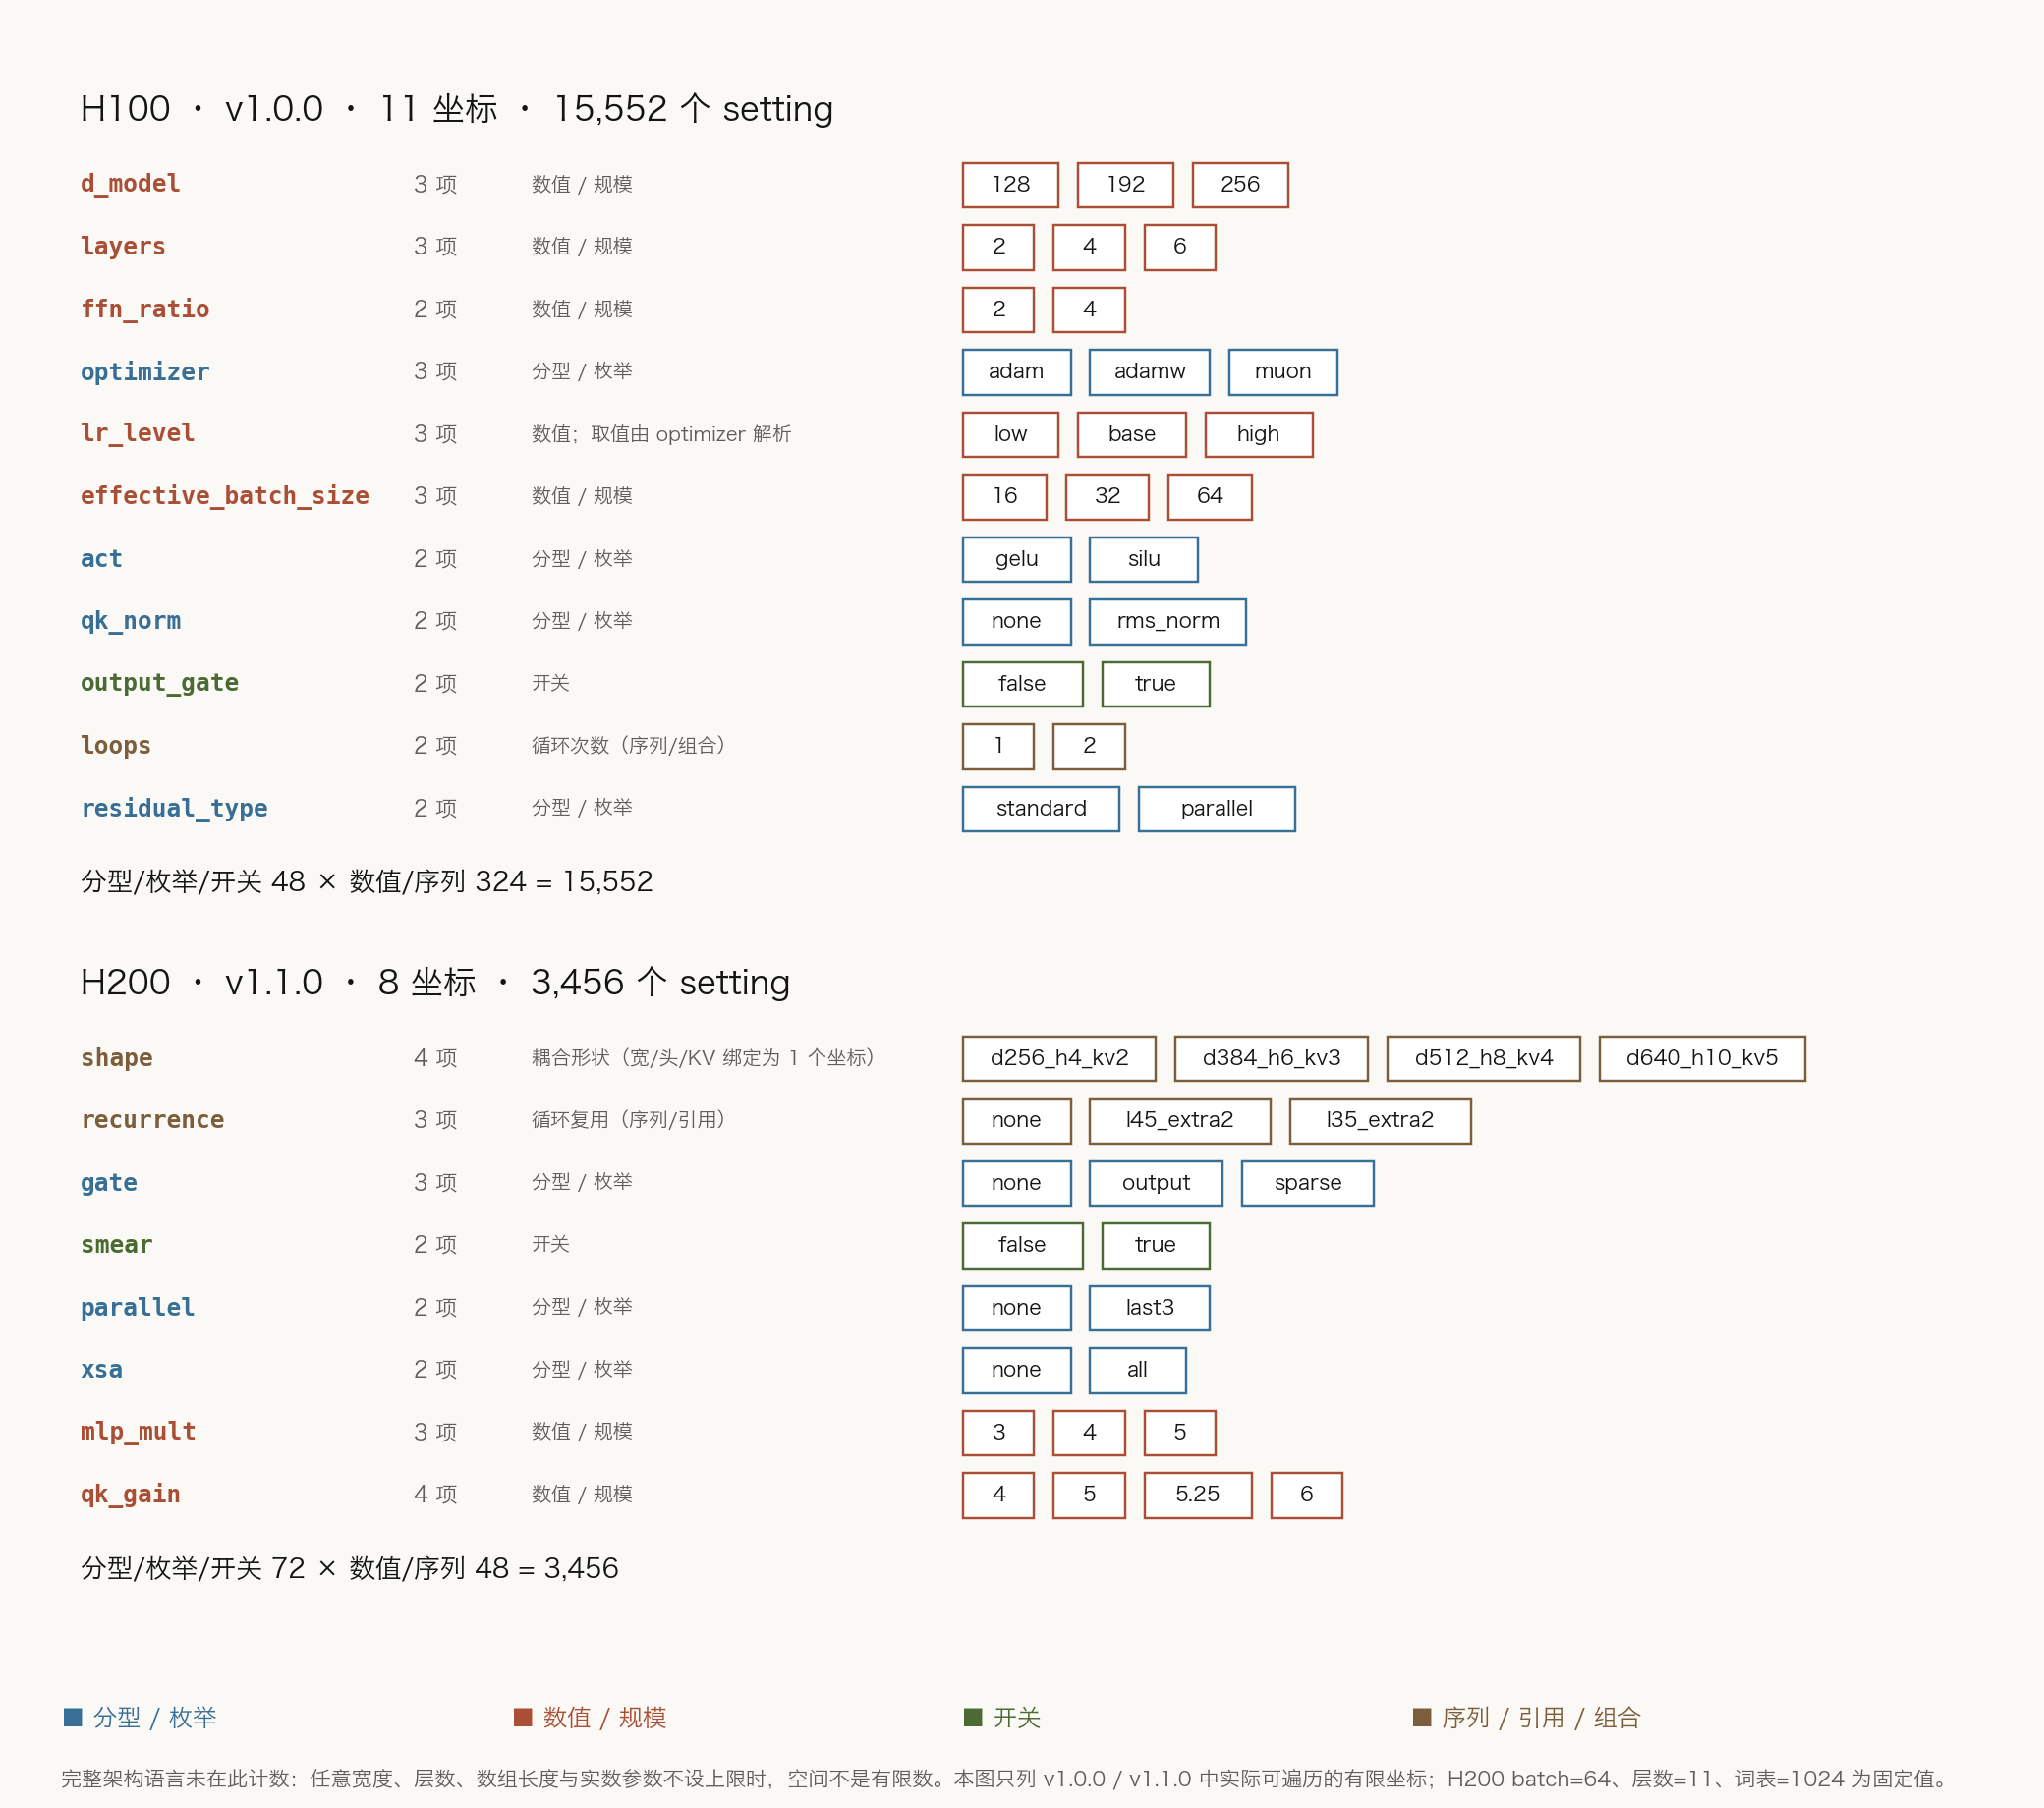
蓝 · 分型 / 枚举赭 · 数值 / 规模绿 · 开关棕 · 序列 / 引用 / 组合
{
}
这是语法索引,不是把所有可选分支同时塞进一份模型。选择一行,右侧查看取值、附属参数、条件与书写示例。数值示例不代表已经声明的有限搜索域。
把前面的讨论压缩成这些约定
- 锚点是代码。JSON 描述构造与执行规则;forward 是有序列表,可以含多个循环和 lm_head。图从同一份 setting 生成。
- 分型先行。type 决定一个分支,参数附属于该分支。多个位置的选择形成乘积,但形状、共享和执行引用会限制合法组合。
- 默认隐藏。embedding 尺寸从全局推导;A/M 默认 pre_rms_norm,head 默认 rms_norm。内部只写特例,模块覆盖循环,循环覆盖全局。
- 替换与复用分开。body 是默认 A/M 与层替换表;execution 表示执行顺序;share 是参数或缓存关联。复用权重不等于复用 KV。
- 节点数不等于自由度。N 只数 compact JSON 的 key;向量元素不额外计 N,但仍参与状态和编辑。有限层数还不够:所有数值、数组长度和取值域都要有界。
- 分开声明模型与搜索规则。数组批量修改、删除子树、关联锁定是编辑/提议协议。通用距离尚未按全部新动作重算;不能用旧矩阵冒充完整语法的最短路。
层集合、参数共享、默认值:精简语法
层集合 ::= [整数, …] | "array(start,step)" | "array(start,step,count)"
        | ["array(start,step,count)", 整数, …]
例: ["array(4,4,6)",27] → [4,8,12,16,20,24,27]
省略 count:延伸到当前 iteration;层号从 1 开始,不能越界或重复。
当前只有 body[].layers 接受 array 字符串;execution / share 的数组仍写整数。

参数共享例:"share": {"attn_weights": [[1,3,5]], "mlp_weights": [[2,4,6]]}
默认分型:body 中不带 layers 的 A 与 M;带 layers 的项整体替换该槽位。
继承顺序:模块 norm > layer_loop.norm > 根 norm > pre_rms_norm。
head 默认:{"lm_head": {}} → RMSNorm → Linear,默认与 embedding 绑权重。

有限域(搜索元数据,不是模型语法):
  枚举:从有限候选中选一个;开关:true / false。
  数值:显式有限列表,或有上下界的量化格点 / 有限 anchor 倍率。
  数组:声明最大长度、合法元素与展开上界;组合后再检查引用与形状。
  分支:选择 type 后只披露该分支的参数,必要字段原子地一起修改。
已讨论的编辑约定(通用实现尚未统一)
层集合增加一个 array 描述、一个整数或不超过三个整数,拟计一次编辑;删除整个子树也拟计一次,因此插入与删除成本可能不对称。改变 dominant 默认分型只是同一语义的重编码,应不额外收费。添加节点应连同必需参数一起构成合法提议,不能训练缺字段的中间态。
渐进披露:先选编辑对象,再选动作,再在有限域中抽取取值。参数共享只允许形状与实现兼容的引用。MCMC 的正反提议概率必须包含这些选择阶段;编辑距离不能代替接受概率。当前 3456 域使用自己的有限坐标协议,没有实现所有通用树编辑。
当前实验和历史方案的边界
当前页面从仓库的 pg_champion_space_v2.py 直接构建:8 坐标、3456 组合,11 个物理层;优化器固定为 source_native_muon_and_adamw。早期 144 状态 POC 的 Adam/AdamW/Muon 选择属于历史域,不能叠加到当前组合数。
当前指标是最后 64 次完整更新的在线训练 CE;固定 SP1024、序列 256、batch 64、120 秒、seed 42。它不同于早期 prefix256+output256 的验证 CE,也不是独立验证质量或官方 BPB。
弱锁定、关联锁定目前是策略元数据;完整语言的渐进披露与全局最短路尚未统一实现。此页是源码快照,不查询 GPU 运行状态。